

词向量的获取通常有两种方式:一种是直接使用他人公开发布的词向量,另一种是在特定语料上自行训练。
在实际工作中,无论是加载已有模型还是从零训练,都可借助Gensim来完成,它提供了便捷的接口来加载 Word2Vec 格式的词向量,也支持基于自有语料训练属于自己的词向量模型。
可执行以下命令安装Gensim
pip install gensim
1)使用公开词向量
公开的中文词向量,可从https://github.com/Embedding/Chinese-Word-Vectors下载,其提供了基于多个数据集训练得到的词向量。
词向量文件的格式为:第一行记录基本信息,包括两个整数,分别表示总词数和词向量维度。从第二行起,每一行表示一个词及其对应的词向量,格式为:词 + 向量的各个维度值。所有内容通过空格分隔,该格式已成为自然语言处理领域中广泛接受的约定俗成的通用格式。具体格式如下
<词汇总数> <向量维度>
word1 val11 val12 … val1N
word2 val21 val22 … val2N
…
可使用KeyedVectors.load_word2vec_format() 加载上述词向量文件,具体代码如下。
from gensim.models import KeyedVectors

model_path = 'sgns.weibo.word.bz2'
model = KeyedVectors.load_word2vec_format(model_path)上述代码使用的sgns.weibo.word.bz2词向量文件包含195202个词,每个词向量300维。该文件可从该网址下载,也可直接从课程资料获取。
词向量加载完后,便可使用如下API查询词向量
- 查看词向量维度
print(model.vector_size)- 查看某个词的向量
print(model['地铁'])- 查看两个向量的相似度
similarity = model.similarity('地铁', '公交')
print('地铁 vs 公交 相似度:', similarity)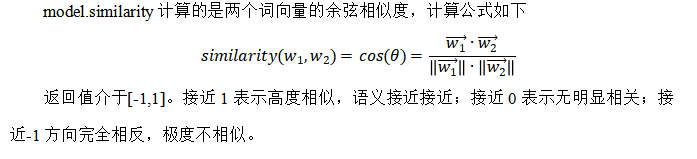
- 找出与某个词最相似的词
similar_words = model.most_similar(positive=["上班"], topn=5)
print(similar_words)

result = model.most_similar(positive=["爸爸", "女性"], negative=["男性"], topn=3)
print(result)2)自行训练词向量
(1)准备语料
Word2Vec的训练语料需要是已分词的文本序列,格式为:
sentences = [['我', '每天','乘坐', '地铁', '上班'], ['我','每天', '乘坐', '公交', '上班']](2)训练模型
gensim提供了十分方便的训练词向量的API——Word2Vec。
from gensim.models import Word2Vec

model = Word2Vec(
    sentences,            # 已分词的句子序列
    vector_size=100,      # 词向量维度
    window=5,             # 上下文窗口大小
    min_count=2,          # 最小词频(低于将被忽略)
    sg=1,                 # 1:Skip-Gram,0:CBOW
    workers=4             # 并行训练线程数
)(3)保存词向量
model.wv.save_word2vec_format('my_vectors.kv')(4)加载词向量
from gensim.models import KeyedVectors

my_model = KeyedVectors.load_word2vec_format('my_vectors.kv')
完整案例如下:
数据集来源为ChineseNLPCorpus,格式CSV,具体结构如下
| cat | label | review |
| 书籍 | 1 | 感谢于歌先生为大家带来这么精彩的一本好书! |
| 书籍 | 0 | 这本书纸质不怎样,内容也不怎样。 |
| 水果 | 1 | 苹果酸甜可口,大小适中,好吃。 |
| 水果 | 0 | 不是很大,比较甜,不会回购,感觉加运费后不划算。 |
完成代码如下:
import jieba
from gensim.models import Word2Vec, KeyedVectors
import pandas as pd

df = pd.read_csv('online_shopping_10_cats.csv', encoding='utf-8', usecols=['review'])

sentences = [[token for token in jieba.lcut(review) if token.strip() != ''] for review in df["review"]]

model = Word2Vec(
    sentences,  # 已分词的句子序列
    vector_size=100,  # 词向量维度
    window=5,  # 上下文窗口大小
    min_count=2,  # 最小词频(低于将被忽略)
    sg=1,  # 1 = Skip-Gram,0 = CBOW
    workers=4  # 并行训练线程数
)

model.wv.save_word2vec_format('my_vectors.kv')

my_model = KeyedVectors.load_word2vec_format('my_vectors.kv')
print(my_model)











请登录后查看评论内容