

5.3.1 模型训练
Seq2Seq 模型的训练目标,是在给定输入序列的条件下,逐步生成完整且准确的目标序列。下面以一个中–英机器翻译样本为例,说明训练过程的各个环节。
假设某个训练样本为:
中文输入:“我喜欢你。”
英文输出:“I like you.”
- 数据准备
为了让模型明确目标序列的起点和终点,通常在目标句前添加 <sos>(start of sequence),句末添加 <eos>(end of sequence):
“I like you.” → “<sos> I like you. <eos>”
这两个特殊标记帮助模型学会从哪里开始生成,以及何时停止生成。
2)前向传播
模型由编码器和解码器两部分组成:
- 编码器
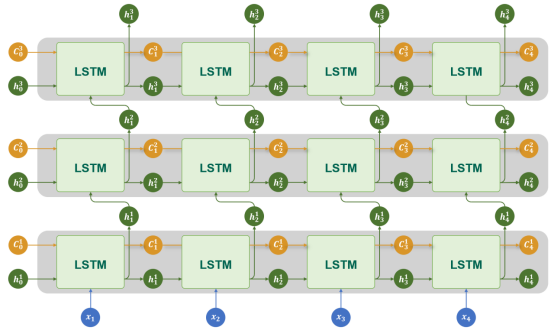
编码器接收源语言序列“我喜欢你。”,通过嵌入层和循环神经网络(RNN / LSTM / GRU)的逐步处理,将整句编码为上下文向量。
- 解码器
解码器使用该上下文向量初始化其隐藏状态,然后逐步生成目标序列。
需要特别注意的是,训练阶段与推理阶段的解码策略是不同的:
在推理阶段,解码器采用自回归生成方式:每一步的输入是模型自己上一步的预测结果。
而在训练阶段,通常使用一种称为 Teacher Forcing 的策略,即:
解码器每一步的输入不是模型上一步的预测结果,而是目标序列中真实的前一个token。如图下图所示
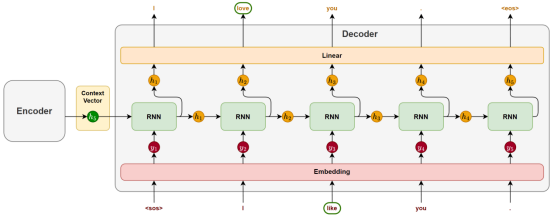
这种做法带来了两个明显好处:
训练更快,误差不会累积;
梯度传播更稳定,有利于优化收敛。
3)计算损失
解码器每一步输出一个token的概率分布,我们通过交叉熵损失函数衡量模型对真实词的预测质量。训练过程中,每一个时间步都会产生一个损失值。该样本的总损失,就是所有时间步的损失值逐步累加的结果。
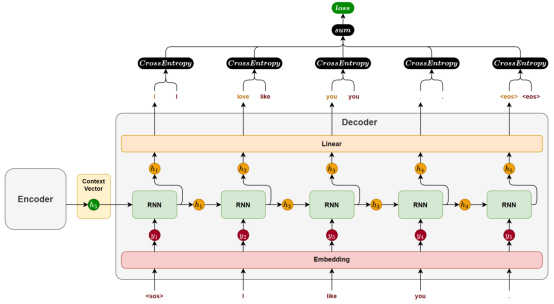
4)反向传播
在 PyTorch 中,调用 loss.backward() 即可自动完成梯度的反向传播。系统会沿时间维度展开计算图,自动完成所有参数的梯度计算,无需手动推导,实现简洁高效。
5.3.2 模型推理
模型推理是Seq2Seq模型在实际任务中生成目标序列的过程,通常包括以下几个环节:
- 编码器处理
推理阶段的编码器处理流程与训练时完全一致。
输入序列会经过分词、嵌入和循环神经网络的逐步处理,最终生成一个表示整句语义的上下文向量,该向量将作为解码器的初始隐藏状态,为生成过程提供语义基础。
- 解码器处理
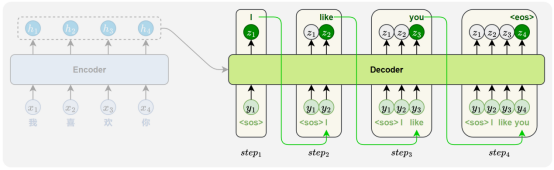
解码器是推理过程的核心,其生成方式采用自回归生成(Autoregressive Generation):每一步的输出会作为下一步的输入,逐步构造完整句子。
- 自回归生成流程
第一步,解码器接收起始标记 <sos>,生成第一个词;
第二步,将上一步生成的词作为当前输入,再预测第二个词;
持续重复以上过程,直到模型生成 <eos>,或达到设定的最大生成步数。
- 词选择策略
每个时间步,解码器输出的是一个词概率分布。我们需要从中选择一个具体词作为本时间步的输出,选择方式即为生成策略。常见策略包括:
- 贪心解码(Greedy Decoding)
每一步都选择概率最高的词。
优点:简单高效
缺点:容易陷入局部最优,生成不够多样。
- 束搜索(Beam Search)
每一步保留多个候选词序列(如 beam size = 3),并在扩展后选择得分最高的完整句子。
优点:全局考虑,生成质量高
缺点:计算开销大











请登录后查看评论内容