

Transformer的训练与推理都基于自回归生成机制(Autoregressive Generation):模型逐步生成目标序列中的每一个词。然而,在实现方式上,训练与推理存在明显区别。
7.3.1 模型训练
训练时,Transformer将目标序列整体输入解码器,并在每个位置同时进行预测。为防止模型“看到”后面的词,破坏因果顺序,解码器在自注意力机子层中引入了 遮盖机制(Mask),限制每个位置只能关注它前面的词。
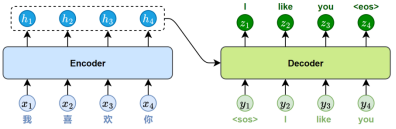
这种机制让模型在结构上模拟逐词生成,但在实现上能充分利用并行计算,大幅提升训练效率。
7.3.2 模型推理
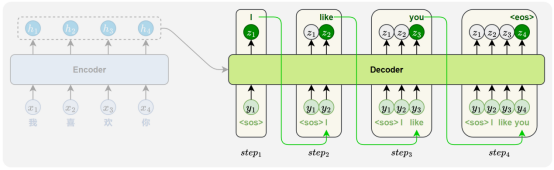
推理时,每一步都要重新输入整个已生成序列,模型需要基于全量前文重新计算注意力分布,决定下一个词的输出。整个过程必须顺序执行,无法并行。
推理阶段,模型每一步都要重新输入当前已生成的全部词,通过自注意力机制建模上下文关系,预测下一个词。
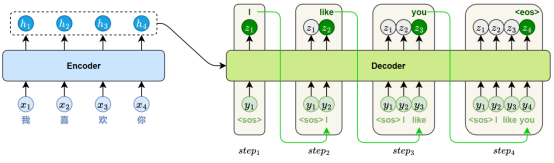
模型会基于完整前文重新计算注意力分布,生成当前步的输出。由于每一步的输入依赖前一步结果,整个过程必须顺序执行,无法并行。
每步输出的是一个词的概率分布,最终生成结果也可使用不同的解码策略(如贪心搜索、束搜索等)。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容