

我们先从一个最容易误解的地方开始。
很多人会说,“Agent 不是已经有 messages 了吗?这不就是状态?”
不完全是。
messages 是 State 的一部分,但它不是全部。
聊天记录主要解决,模型下一轮需要看到哪些对话和工具结果。
而 State 还需要解决:
- 当前目标是什么;
- 已经跑了几步;
- 调过哪些工具;
- 当前是否等待审批;
- 是否已经完成;
- 是否失败;
- 最近一次错误是什么;
- 当前还有没有继续执行资格。
所以更准确地说,State 是 Agent 当前运行事实的结构化快照。
这里最容易混淆的是包含关系:messages 确实保存在 State 中,但它只是为下一轮模型输入提供材料的一部分;步数、工具历史与当前阶段等事实还要由程序单独管理。
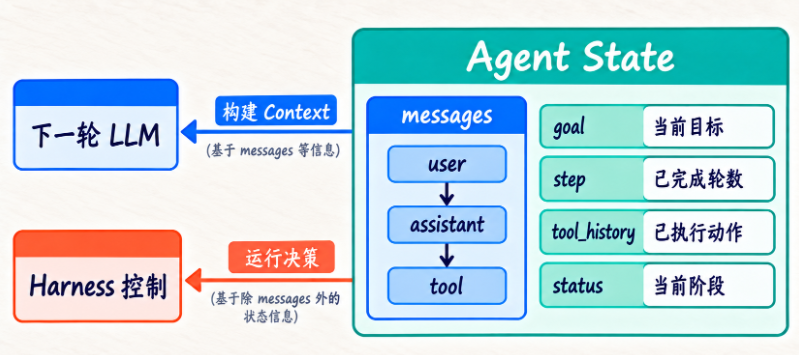
从图的两条输出路径也能看出区别:模型主要消费构建后的 Context,Harness 则根据结构化状态控制运行。实际 Context 还可以组合规则、工具定义等其他来源,并不等于直接把 messages 原样送进去。
我们可以先写最小版本:
agent_state = {
    "goal": "检查项目为什么启动失败",
    "messages": [],
    "step": 0,
    "tool_history": [],
    "status": "READY"
}
这里每个字段都不是为了“好看”,而是有明确用途。
goal:这次运行到底要解决什么?
最容易出现的错误,是把 Goal 混在第一条用户消息里,然后后面完全靠 messages 自己“回忆”。
这在短任务里问题不大。
但如果上下文很长,Goal 很容易被大量 Tool Result 淹没。
显式保存:
state.goal有几个好处。
第一,任何模块都能直接知道当前任务目标。
第二,System Reminder 可以反复提醒模型:
当前目标仍然是:
检查项目为什么启动失败
第三,Tracing 和 Run Summary 都能直接展示。
第四,后面做 Planner 时可以直接基于 Goal 生成计划。
所以 Goal 是一个非常典型的“运行级状态”。
messages:当前模型上下文的原材料
messages 保存的通常是:
user
assistant
tool
assistant
tool
...
它帮助模型知道之前发生了什么。
但这里先记一个重要边界,messages 不一定等于最终 Context。
后面我们会有 Context Builder。
它可能从:
messages
working_memory
system prompt
tool definitions
project rules
里重新组装模型输入。
所以在 State 里保存 messages,更多是保存“对话与交互历史”。
step:先约定我们到底在数什么
最简单的写法:
state.step += 1这个数字非常有用。
不过这里有个容易被忽略的细节:不同系统对“一步”的定义可能不同。有人把一次 LLM 决策算一步,有人只在 Tool 执行后加一,还有人把每个 Tool Call 单独算一步。只要口径前后一致都能工作,真正危险的是代码、日志和前端各用一套口径。
本节的完整教学示例在每次工具结果写回后执行 state.step += 1,因此它更接近“已完成的工具轮数”;配套 AgentEngine 则在每次 LLM 决策前增加 Step,更接近“模型决策轮数”。后面做 Run、Trace 和预算时,我们会继续使用配套 Engine 的口径。看到两处数字不完全一样时,先核对定义,不要急着判断状态丢失。
例如:
if state.step >= max_steps:
    state.status = "FAILED"
再比如每 5 步插一次 Reminder:
if state.step % 5 == 0:
    inject_reminder()
也可以用于 Trace:
Step 1
Step 2
Step 3
如果没有显式 step,你会发现很多“循环控制”都要重新推断。
tool_history:Agent 做过哪些外部动作?
这是特别关键的一类信息。
例如:
[
    {
        "tool": "list_files",
        "arguments": {}
    },
    {
        "tool": "read_file",
        "arguments": {
            "path": "src/main.py"
        }
    }
]
它和 messages 有重叠,但用途不同。
messages 是面向模型上下文。
tool_history 更适合:
- 重复动作检测;
- 审计;
- Trace;
- 统计;
- 判断某个动作是否已经做过。
例如:
def has_read_file(state, path: str) -> bool:
    for item in state.tool_history:
        if (
            item["tool"] == "read_file"
            and item["arguments"].get("path") == path
        ):
            return True

    return False
有了这个结构,就很容易提醒 Agent,“这个文件你已经读过了。”
status:当前运行阶段是什么?
很多人最开始会写:
running = True
finished = False
waiting = False
failed = False
很快就会出现矛盾:
running=True
waiting=True
finished=False
failed=False
这到底算什么状态?
所以更推荐用明确的单一状态:
READY
THINKING
TOOL_CALLING
OBSERVING
WAITING_APPROVAL
COMPLETED
FAILED
一个时刻只处于一个主要状态。
这会极大提升可读性。
用 dataclass 替代松散字典
字典适合开篇,但正式项目更适合 dataclass。
from dataclasses import dataclass, field


@dataclass
class AgentState:
    goal: str
    messages: list[dict] = field(default_factory=list)
    step: int = 0
    tool_history: list[dict] = field(default_factory=list)
    status: str = "READY"


if __name__ == "__main__":
    state = AgentState(
        goal="检查项目为什么启动失败"
    )

    print(state)
运行以后会看到:
AgentState(
    goal='检查项目为什么启动失败',
    messages=[],
    step=0,
    tool_history=[],
    status='READY'
)
为什么 dataclass 更好?
因为它让 State 成为一个明确类型。
后面我们可以继续加:
last_error
current_tool_call
final_answer
created_at
updated_at
也可以写方法:
state.mark_completed()
state.mark_failed()
这就开始从“字典”走向真正的运行模型。
State 字段不是越多越好
另一个常见问题是,“既然 State 很重要,那我是不是把所有东西都放进去?”
也不对。
一个实用判断是,如果某个信息会影响下一步决策、恢复、控制或状态判断,就很可能属于 State。
如果只是为了历史审计,而且不会影响当前运行,可以只进入 Trace。
例如完整 Prompt 文本可能很大,不一定要一直塞在 State 里,可以只记录到 Trace。
所以 State 不是“所有数据仓库”。
它是当前运行事实的最小充分集合。














请登录后查看评论内容