

场景背景
一个 Data Analysis Agent 接到任务,“为什么昨天收入下降?”
Agent 先查:
总收入再查:
按媒体拆分发现:
media_B 异常接着应该继续:
查 media_B 的请求、曝光、eCPM问题矛盾
但系统实际发生:
query_by_media()
query_by_media()
query_by_media()
同一个查询重复三次。
团队第一反应,“模型是不是太笨?”
其实 Trace 一看,发现 State 里只有:
messages没有:
tool_history
current_focus
而且 Tool Result 被压缩后,模型不清楚自己已经查过媒体维度。
输入与前置条件
我们扩展 State:
{
    "goal": "解释收入下降",
    "step": 2,
    "status": "THINKING",
    "tool_history": [
        {
            "tool": "query_total_revenue",
            "arguments": {}
        },
        {
            "tool": "query_by_media",
            "arguments": {}
        }
    ],
    "current_focus": {
        "dimension": "media",
        "value": "media_B"
    }
}
解决过程
下一轮 Context Builder 可以明确告诉模型:
已完成:
- 总收入查询
- 媒体维度拆分

当前异常焦点:
media_B

请不要重复执行已完成的查询。
模型自然更容易:
query_media_metrics(media_B)输出结果
Agent 从重复查询变成:
query_total_revenue
 ↓
query_by_media
 ↓
query_media_metrics(media_B)
 ↓
query_by_position(media_B)
 ↓
Finish
对照两条执行轨迹,就能看出“连续查三次媒体维度”不一定是模型本身不会分析:缺少已执行动作和当前焦点时,下一轮只能重新猜测。
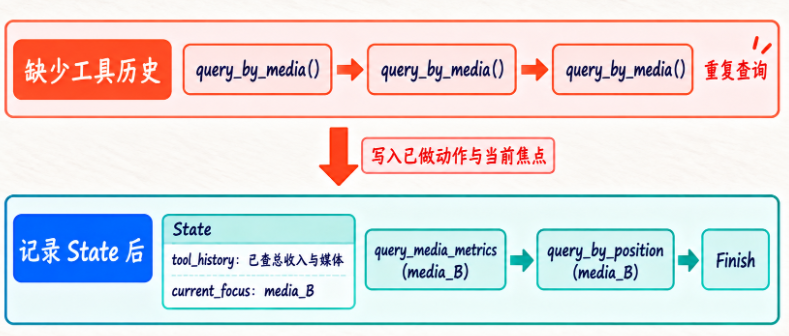
将 tool_history 与 current_focus=media_B 写入 State,并在 Context 中清楚提示,模型才更容易继续查询该媒体的指标和广告位;这是一种更可靠的引导,不是保证它永不重复的魔法开关。
复盘与迁移
这个案例说明,State 会直接影响 Agent 的行为质量。
很多“模型问题”,其实是状态设计问题。
模型没有被告知自己做过什么,它就只能重新猜。
所以后面我们设计 Working Memory 时,会继续增强这一点。
常见误区
误解: Agent State 就是 messages,只要聊天记录保存完整就够了。
正解: messages 只是状态的一部分,它主要服务于模型上下文。Agent 还需要显式知道 Goal、Step、Tool History、当前 Status、最近错误、当前待审批动作等运行事实。很多控制逻辑不应该每次从聊天记录里重新推断,否则成本高、容易出错,也不利于服务恢复和审计。
误解: 状态越多越好,所有信息都放进 AgentState 最方便。
正解: State 应该保存会影响当前运行、恢复、控制和决策的关键信息,而不是成为“万能垃圾桶”。完整日志、完整 Prompt、HTTP Header、每次 Token 明细更适合 Trace;跨 Session 的长期知识更适合 Memory。State 越臃肿,序列化、持久化、上下文组装和调试都会更复杂。
误解: status="running" 已经足够,不需要 READY、THINKING、OBSERVING 这些细分状态。
正解: 真实 Agent 运行过程中,不同阶段允许的动作完全不同。THINKING 表示正在做模型决策,TOOL_CALLING 表示准备执行动作,WAITING_APPROVAL 表示任务暂停等待人工确认。把所有阶段都压成 running,后面前端展示、恢复执行、权限控制和异常定位都会失去语义。
误解: Tool 一旦执行失败,就应该把 Agent State 直接改成 FAILED。
正解: 可恢复型 Tool Error 更适合作为 Observation。比如文件不存在,Agent 可以改为 list_files;SQL 为空,可以换维度。只有确认任务无法继续,或者触发系统硬边界,才应该进入 FAILED。否则把所有局部错误都当成任务失败,会丢掉 Agent 最重要的恢复能力。
误解: 状态机只是为了画图,真正写代码时直接赋值就行。
正解: 当系统简单时直接赋值问题不大,但随着 Human Approval、暂停恢复、并发执行、服务化出现,非法状态流转会成为真实 Bug。例如 COMPLETED 后又被恢复到 THINKING,或 WAITING_APPROVAL 时偷偷执行 Tool。显式状态机能把允许与禁止的流转写清楚,让很多错误在代码层就被阻断。
误解: State 和 Memory 是同一个概念,反正都是“记东西”。
正解: State 更偏当前 Run 的运行事实,例如当前 Step、Status、错误、待执行动作;Memory 更偏跨轮次或跨 Session 需要保留的知识,例如用户偏好、项目规则、历史决策。两者可以互相影响,但生命周期、更新策略和使用方式不同。把它们混在一起,后面很难管理。














请登录后查看评论内容