

前面解决的是“能不能生成 Schema”,这一节开始解决“生成出来的 Schema 好不好用”。实际项目里,模型调用不稳定,很多时候不是模型本身不行,而是 Tool 的命名、参数和约束让它有太多可以误解的空间。
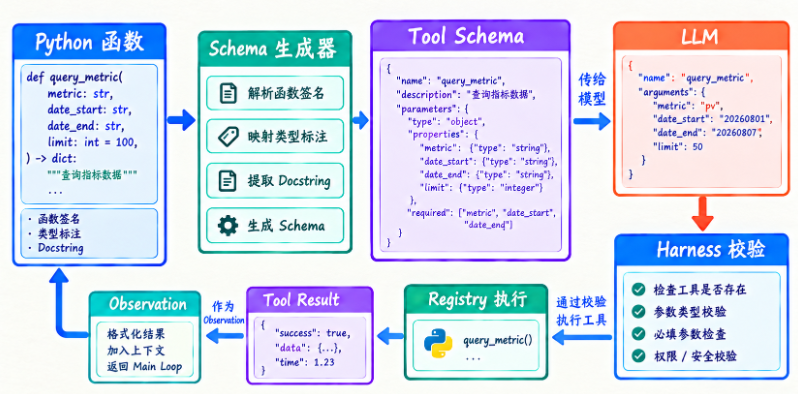
所以后面的几个问题可以用一个统一视角去看:好的 Schema 既要给模型足够信息,又要尽量缩小无意义的自由度。 自动生成负责结构,真正的语义设计仍然需要我们自己把关。
到这里,我们已经可以自动生成 Schema。
但自动生成只是起点。
真正的 Agent 项目很快会遇到,模型虽然拿到 Schema,为什么还是会乱传参数?
原因通常是 Schema 太宽松或者语义不清。
问题一:参数名技术上正确,但语义不清
例如:
def query(
    value: str,
):
    ...
自动 Schema:
{
  "value": {
    "type": "string"
  }
}
模型不知道 value 到底是什么。
所以函数参数本身就应该更清楚:
def query_metric(
    metric_name: str,
):
...这是第一个非常重要的经验,Tool Schema 质量首先来自函数设计质量。
问题二:类型太宽松
例如:
def set_log_level(
    level: str,
):
    ...
实际上只允许:
debug
info
warning
error
如果 Schema 只有:
"type": "string"模型可能生成:
verbose
critical
normal
更好的 Schema:
{
  "type": "string",
  "enum": [
    "debug",
    "info",
    "warning",
    "error"
  ]
}
这会显著减少错误。
用 Literal 自动生成 enum
Python:
from typing import Literal


def set_log_level(
    level: Literal[
        "debug",
        "info",
        "warning",
        "error",
    ],
):
    ...
我们可以扩展:
origin = get_origin(annotation)

if origin is Literal:
    return {
        "type": "string",
        "enum": list(
            get_args(annotation)
        )
    }
这就是类型标注逐渐变成真正协议。
问题三:参数范围没有表达
例如:
limit: int程序只允许:
1 <= limit <= 100单靠基础 type hint 表达不了。
可以有两种方式。
第一,Schema Generator 支持额外 Metadata。
第二,Tool 内部 / Middleware 做业务校验。
实际工程通常两层都做。
Schema 尽量告诉模型:
minimum
maximum
执行前 Harness 再真正检查。
因为,Schema 是提示与协议,不是安全边界。
问题四:description 太长也会有副作用
很多人以为描述越详细越好。
于是一个 Tool Description 写 500 字。
工具几十个以后,光 Tool Schema 就吃掉大量 Context。
所以要在:
足够清楚之间平衡。
例如:
read_file:
读取工作目录内指定 UTF-8 文本文件。
当你已经知道准确路径、需要查看文件内容时使用。
通常已经很够。
没必要写成一篇教程。
问题五:工具粒度影响 Schema 复杂度
例如设计:
file_tool(
    action,
    path,
    content,
    keyword,
    recursive,
    encoding,
    ...
)
一个 Tool 做:
read
write
search
list
delete
Schema 会极其复杂。
模型很容易填错组合。
更合理可能拆成:
read_file
write_file
search_files
list_files所以,Tool Schema 问题很多时候其实是 Tool 粒度问题。
这个地方很适合从“模型要做多少选择”来理解。万能 Tool 看起来接口少,但模型既要选 action,又要判断哪些参数组合在当前 action 下有效;拆成多个职责单一的 Tool 后,第一步先把动作选清楚,后面的参数空间反而简单很多。
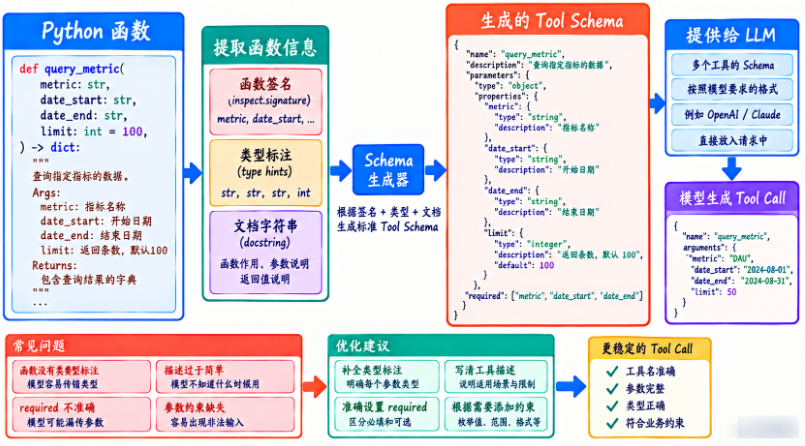
因此不要单纯追求“工具数量少”。对 Agent 来说,边界清楚通常比接口万能更重要。工具拆得合理,Description 更容易写,Schema 更容易约束,Middleware 也更容易针对不同风险做策略。
问题六:Schema 不应该承担全部安全责任
例如:
"path": {
  "type": "string",
  "description": "只能读取 workspace 内路径"
}
这不代表模型一定不会传:
../../etc/passwdHarness 仍然必须:
resolve path
 ↓
检查是否在 workspace
 ↓
不合法则拒绝
这就是,Schema 约束模型输出,Middleware 约束真实执行。
不要混淆。
把这三层放在一起看,边界就非常明确了:Schema 主要影响模型“怎么生成”,Validation 判断“参数是否符合协议”,Middleware 决定“这个动作在当前环境到底能不能做”。
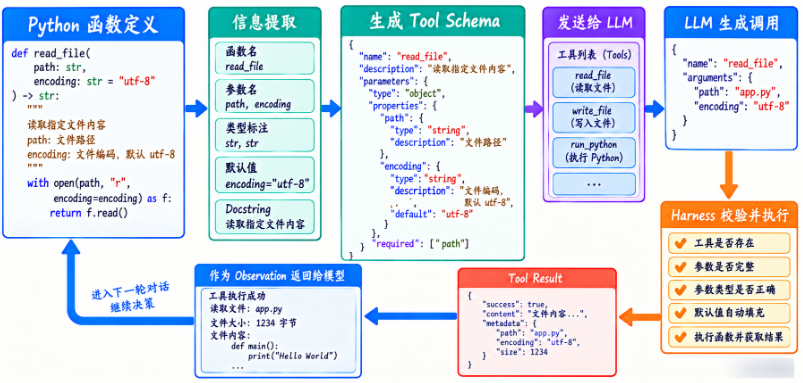
比如 path: string 完全可能是一个类型合法但业务危险的路径。因此看到一个 Tool Call 通过 Schema 校验,只能说明它结构上像一个合法请求,并不等于它已经获得了真实环境的执行许可。
一个带 Literal 的增强示例
输出会包含:
"enum": [
  "debug",
  "info",
  "warning",
  "error"
]
模型更容易生成合法参数。
什么时候不要完全自动?
有些 Tool 的业务语义很复杂。
比如:
query_ad_metrics参数:
metric
dimension
date_start
date_end
filters
这时候只从 Type Hint 自动生成,可能还不够。
可以允许:
@tool(
    description="...",
    parameter_descriptions={
        ...
    }
)
或者后面引入更完整的模型定义工具。
但核心原则保持,自动提取结构,人工补充语义。
这是比较稳定的做法。
让参数校验成为执行之前的一步
我们已经会把 Python 类型变成 Schema,接下来检查一个具体输入:工具只接受 income 或 impression,模型却传来了 revenue。Schema 可以帮助模型减少这类错误,但执行器仍要验证输入。服务端拒绝不合法参数,才能保证实际函数收到的数据符合约定。
校验需要覆盖嵌套对象、列表元素、必填字段和额外字段。默认值也要谨慎:省略 date_end 时自动填今天,看似方便,却可能让历史分析悄悄混入新数据。我们应写明默认值的业务含义,并在 Trace 里记录最终执行参数。
配套项目现在已经把这一步接进 ToolRegistry.execute():函数真正执行之前,会检查常用 JSON Schema 子集,包括 type、required、properties、additionalProperties、items、enum、数值范围、长度与正则约束。错误会带上稳定的 invalid_tool_arguments 代码和 $.filters.country 这样的字段路径,而不是只抛出一个含糊的 Python TypeError。Main Loop 会把错误作为对应 tool_call_id 的 Observation 放回消息历史,模型可以在剩余预算内修正参数;如果它反复提交同一种错误,Step 和 Tool Call 预算仍会负责收口。
这里还有一道经常漏掉的批处理边界。一次模型响应可能包含多个 Tool Call,如果第一个写文件、第二个参数才不合法,逐个“校验一个、执行一个”仍会留下半批副作用。课程的 Main Loop 会先完成整批 Middleware 策略判断并留下审计记录,再校验完整批次,最后才创建审批或进入实际执行;任何一个调用不合法,这一批都不会开始。策略放在 Schema 前面有一个实际好处:即使工具根本没有注册,类似“写入 tests/”的危险意图仍会被策略层识别和记录,不会只剩下一条“未知工具”。被跳过的合法调用也会收到 tool_batch_rejected Observation,确保 assistant 发出的每个 Tool Call 都有对应 Tool Message,下一轮请求不会破坏 Provider 协议。这个顺序值得记住:整批策略预检 → 整批 Schema 校验 → 返回拒绝 Observation,或审批并逐个执行。
这一段如果只看文字比较容易把“校验”和“执行”黏在一起。下面这张流程图可以把关键顺序拉开来看:先把整轮调用当成一个批次检查,只有这一批都满足策略和参数协议,真实执行阶段才开始。
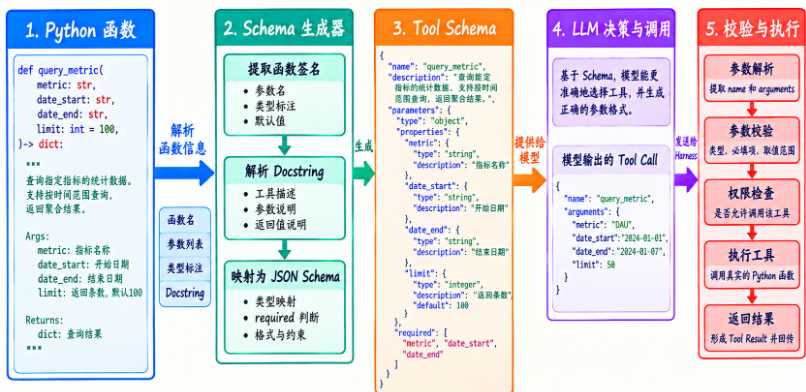
这里真正要防的是“半批成功”:前面的副作用已经发生,后面才发现某个调用非法。先检查完整批次,再进入执行边界,会让错误恢复、审批和审计都更可控。
这套实现刻意没有假装支持全部 JSON Schema。遇到 oneOf、$ref 等未实现的校验关键字,注册阶段会直接失败,而不是悄悄忽略约束。生产项目如果需要完整规范,可以替换成熟校验库;无论使用哪种实现,“模型端看到 Schema”和“服务端强制验证”都要同时存在。
如果工具不接受未声明参数,可以在对象 Schema 中显式加入:
{
  "type": "object",
  "properties": {
    "path": {
      "type": "string"
    }
  },
  "required": ["path"],
  "additionalProperties": false
}
这样模型多传 filename 时,校验层可以直接指出“出现了未声明字段”,而不是等到 Python 抛出较难处理的 TypeError。不过 Provider 对 JSON Schema 子集的支持并不完全一致:内部 Schema 可以保持严格,Adapter 对外发送时再做兼容转换;无论模型端是否支持,服务端校验都不能省略。
参数校验失败时,返回稳定错误码、字段位置和允许值,模型才容易修正。它与运行中的网络超时属于不同类别,不应该使用同一种重试策略。更新 Schema 后,还需要比较旧调用是否仍然有效,必要时发布新版本。
动手补齐:试四种输入
对一个接收 filters 对象的查询工具,分别提交缺少日期、错误枚举、嵌套类型错误和多余字段。参考验收是:四种输入在产生外部副作用前被识别,错误明确指向字段,合法输入能正常执行。再检查模型修正后的第二次调用,确认提示信息确实足够使用。
















请登录后查看评论内容