

场景背景
Data Analysis Agent 有:
def query_metric(
    metric: str,
    dimension: str,
    date_start: str,
    date_end: str,
    limit: int = 100,
):
    ...
最简单 Schema:
所有字符串都是 string
limit 是 integer
模型开始调用。
真实问题
第一次:
metric = "收入"但后端只接受:
revenue第二次:
dimension = "广告媒体"后端只接受:
media第三次忘了:
date_end第四次:
limit = 1000000所以仅仅:
"type": "string"并不能把协议表达清楚。
改造
我们可以给:
metric设置枚举:
"enum": [
  "revenue",
  "request",
  "impression",
  "click"
]dimension:
"enum": [
  "media",
  "position",
  "app"
]
并明确:
"required": [
  "metric",
  "dimension",
  "date_start",
  "date_end"
]
limit 再加入:
minimum = 1
maximum = 1000
到这里,这个 Tool 的动作空间已经和最开始完全不同了。原来 metric、dimension 都是任意字符串,limit 也是任意整数;加入 enum、required 和范围以后,模型仍然有选择空间,但选择被限制在业务能够理解的集合里。
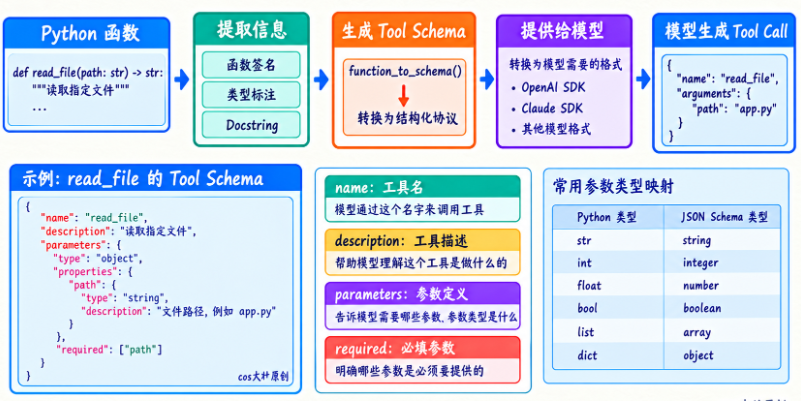
这种设计特别适合数据分析类 Agent:把“可选什么”尽量写进结构化约束,把更复杂的跨字段业务规则留给执行前校验。 两边各做自己擅长的事,比把所有规则都塞进 Prompt 稳定得多。
结果
模型可选空间大幅收窄。
它不再“发明”参数。
而是在协议允许的范围里做选择。
但为什么 Harness 还要二次检查?
因为即使 Schema 表达了:
date_start
date_end
模型可能依然传:
2020-01-01 到 2026-09-01超过业务允许的 30 天。
所以:
Tool Schema:
帮助模型生成合法结构

Business Validation:
检查业务约束

Security Middleware:
检查安全边界
三者不能互相替代。
复盘
这个案例特别能说明,Tool Schema 不是为了把 JSON 写漂亮,而是在定义模型的动作空间。
Schema 越准确,模型在 Tool Calling 时越不容易走偏。
常见误区
误解: Tool Schema 只是把函数名和参数名写成 JSON,没有太大价值。
正解: Schema 直接定义了模型能如何表达动作。它不仅告诉模型参数名,还可以表达类型、required、数组结构、枚举和值约束。更重要的是,Harness 也可以基于相同协议做参数校验。它把“模型怎么调用”和“程序怎么接收”连接成一个机器可读契约,因此是 Tool Calling 稳定性的核心组成。
误解: 有了 Tool Schema,Harness 就可以完全相信模型参数。
正解: Schema 能降低错误概率,但模型输出仍然属于不可信输入。即使类型合法,也可能出现路径逃逸、超大 limit、超长查询范围、危险命令等业务与安全问题。因此正确层次是:Schema 帮助模型生成结构,Validation 检查参数,Middleware 控制真实执行边界。Schema 不是安全沙箱。
误解: Tool Description 随便写一句就行,参数结构才是最重要的。
正解: 参数结构解决“选了这个 Tool 后怎么填参数”,Description 则直接影响“模型要不要选这个 Tool”。如果多个 Tool 描述模糊,模型很容易选错。例如 read_file 和 search_files 如果都写成“处理文件”,模型无法判断什么时候应该用哪个。高质量描述应该简洁说明用途、适用时机和关键边界。
误解: 自动生成 Schema 后,就不需要人工设计 Tool 了。
正解: 自动生成主要减少结构性重复劳动,例如读取函数名、参数名、类型和默认值。真正的语义仍然来自函数命名、参数命名、docstring、枚举和业务约束。如果函数本身设计成 query(value: str),自动生成出来的 Schema 同样模糊。自动化不会修复糟糕接口设计。
误解: Schema 越详细越好,把所有规则都写进 description 最安全。
正解: 过长 Schema 会占用 Context,也可能让模型抓不住重点。适合机器表达的约束应该用结构化字段,例如 enum、required、minimum、maximum,而不是全塞进自然语言。Description 只保留关键用途和语义。真正安全规则仍然放在 Harness / Middleware,不应依赖一大段文字。
误解: 一个万能 Tool 配复杂 Schema,比多个小 Tool 更先进。
正解: 如果一个 file_tool 同时支持 read、write、search、delete,并且参数组合复杂,模型很容易生成无效组合。很多时候拆成多个职责清晰的小 Tool,Schema 更简单、模型选择更稳定、安全策略也更容易做。Tool 粒度本身会直接影响 Schema 质量和 Agent 行为,因此不能只从代码复用角度设计。
















请登录后查看评论内容