

现在假设模型一次产生:
read README.md
read app.py
read requirements.txt
read config.py
Harness 并发执行完成。
得到:
Result A
Result B
Result C
Result D
接下来怎么办?
不能只是:
print(results)它们必须成为下一轮 Observation。
每个 Result 必须保留身份
至少:
call_id
tool_name
arguments
ok
result
error
否则模型不知道,哪个内容对应哪个文件。
例如:
{
  "call_id": "call-2",
  "tool": "read_file",
  "arguments": {
    "path": "app.py"
  },
  "ok": true,
  "result": "..."
}
Observation 可以逐条放回 messages
例如:
assistant:
tool calls...

tool:
call-1 result

tool:
call-2 result

tool:
call-3 result
这样下一轮模型可以看到所有工具反馈。
也可以做 Batch Observation
内部 Harness 可以先聚合:
{
  "batch_id": "batch-001",
  "results": [
    ...
  ]
}
然后 Context Builder 再决定怎么呈现给 Provider。
这属于内部设计。
这里的 Batch Observation 是 Harness 内部聚合结构,不能随意替代 Provider 的 Tool Calling 协议。模型上一条 assistant 消息如果提出了四个 tool_calls,下一次请求通常仍要为四个 call_id 分别提供对应的 Tool Message。我们可以并发执行、内部批量存储,也可以按完成顺序更新界面,但在再次调用模型前必须把这一轮所需结果完整组装好。
并发执行结束以后,真正难的部分其实才开始:多个 ToolResult 要怎样重新变成模型能继续推理的 Observation。内部可以做 Batch 聚合,但在 Provider 边界仍然要保持每个 call_id 的一一对应。
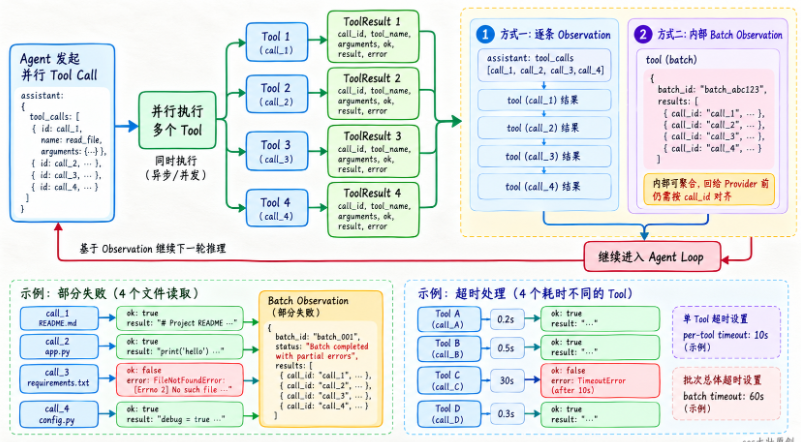
也就是说,执行阶段可以乱序完成,协议阶段不能乱配结果。 Harness 可以在内部按完成顺序处理,也可以重排回原始调用顺序,但再次请求模型之前,必须让这一轮所有必需结果都完整、可追溯。
部分失败怎么处理?
例如:
README.md → success
app.py → success
requirements.txt → FileNotFoundError
config.py → success
不要:
整个并行批次 FAILED更合理的是:
Batch completed with partial errors下一轮模型可以:
发现 requirements.txt 不存在
→ search_files("pyproject.toml")
这其实就是上一节 Error Recovery 和本节 Parallel Execution 的结合。
超时也应该单独处理
如果四个 Tool:
A 0.2 秒
B 0.5 秒
C 30 秒卡住
D 0.3 秒
不能让 C 拖住整个批次无限等待。
可以设置:
per-tool timeout
batch timeout
基础版应优先把 per-tool timeout 放进 Tool 自己真正等待 I/O 的位置,例如 HTTP 客户端超时、数据库查询超时或 subprocess.run(timeout=...)。只在外层调用 future.result(timeout=...),通常只能让等待方停止等待,不能杀掉已经运行的线程;退出 ThreadPoolExecutor 的上下文时,还可能继续等待这些任务结束。
asyncio.wait_for() 可以在超时时取消协程,但取消仍需要底层异步库配合,阻塞代码不会因此自动停下。Batch timeout 负责限制这一批最多等多久,per-tool timeout 负责约束每个外部动作,两者都要把已经完成的结果保留下来,并在 Trace 中区分“执行超时”“取消成功”和“只是不再等待”。
把错误隔离和超时放到同一批里看会更直观:某个 Tool 超时、某个 Tool 被权限拒绝,都不应该把其他已经成功的结果一起抹掉。批次可以“带着部分错误完成”,下一轮 Agent 再决定哪些失败需要重试、降级或换路径。
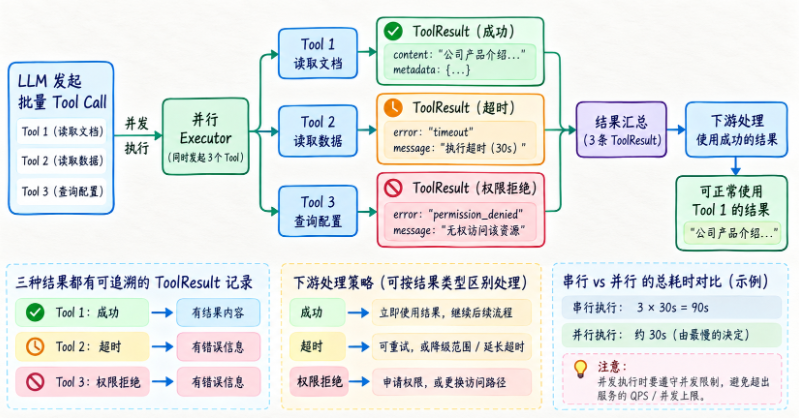
这也是并发 Harness 和普通 gather() / 线程池 Demo 的区别之一:我们关心的不只是任务有没有结束,还要给每个调用留下稳定、可追踪、可恢复的结果记录。
后面服务化以后还会有 Run Timeout。
并发 Tool History 怎么记录?
之前:
state.tool_history.append(...)串行很简单。
并行以后可以把一批 Call 作为一个 Step:
Step 5
  ├─ call-1
  ├─ call-2
  ├─ call-3
  └─ call-4
这比把它们强行记成:
Step 5
Step 6
Step 7
Step 8
更能体现,它们属于同一轮模型决策。
所以我们后面 Tracing 会逐渐引入:
Step
  ↓
multiple Tool Calls
一个完整批量执行器
下面我们用 ThreadPoolExecutor 再实现一次,并保留输入顺序。
为什么要保留输入顺序?
因为虽然执行完成顺序不同,但很多 Provider 在 Tool Result 回传时会希望与 Tool Call ID 准确对应。
最终 Observation 会明确:
total=3
success=2
failed=1
下一轮 Agent 就能继续。
并发并不改变 Main Loop 本质
这是本节最后一个非常重要的点。
串行 Agent:
Reason
 ↓
Action
 ↓
Observation
 ↓
Reason
并行 Agent 仍然是:
Reason
 ↓
Actions
 ↓
Observations
 ↓
Reason
只是:
Action从一个变成一组。
Main Loop 的本质没有变。
回到配套项目看当前实现
配套项目的 ProviderResponse.tool_calls 已经是列表,AgentEngine 也能接收一轮多个 Tool Call,并为每个调用保留 call_id。但当前 Engine 随后仍使用 for call in normalized_calls 逐个执行,所以它完成的是“多 Tool Call 协议支持”,还不是本节所讲的并发执行。
项目里的 RunService 虽然使用了 ThreadPoolExecutor,并发的对象是多个独立 Run,不是同一个 Agent Step 里的多个 Tool。两层线程池解决的问题不同,不能看到线程池就认为 Parallel Tool Calling 已经接通。
本节的同步、异步批量执行器因此属于下一步可接入实现。真正合入 Engine 前,还需要把 ToolSpec 的只读性、动态资源键和并发安全信息补齐,让 Middleware 先逐项授权,再由调度器分组执行;完成后仍按原始 tool_call_id 生成一条对应的 Tool Message,并在全部必需结果返回后再调用下一轮模型。
并发读取很容易,并发修改要再想一步
两个工具同时读不同文件,通常可以并发;两个工具分别给同一配置文件添加字段,就可能互相覆盖。它们的参数不同,并不代表没有共享资源。我们可以按目标资源建立冲突规则,让读取并发,依赖同一版本的修改串行或通过版本检查提交。
并发组中一个工具超时,其他结果仍然可能有用。聚合时保留每个调用的标识、状态和结果,不把失败项悄悄丢掉。若后续决策已经不需要剩余任务,可以请求取消,但要区分“取消等待”和“停止实际执行”。正在运行的线程通常无法被 Future.cancel() 直接终止,子进程也需要单独管理。
并发上限需要同时考虑线程数、连接池和外部限流。耗时统计上,两个并发任务各花两秒,不能据此认定用户等待了四秒。我们既记录每个工具的占用时间,也记录并发组的墙钟时间,后面成本与性能章节会使用这两个口径。
并发读取通常是最简单的一类,而并发修改要多做一层判断。两个 read_file 同时读取不同文件很自然;两个 edit_file 同时改同一个文件,即使 arguments 看起来不同,也可能产生覆盖和竞态。
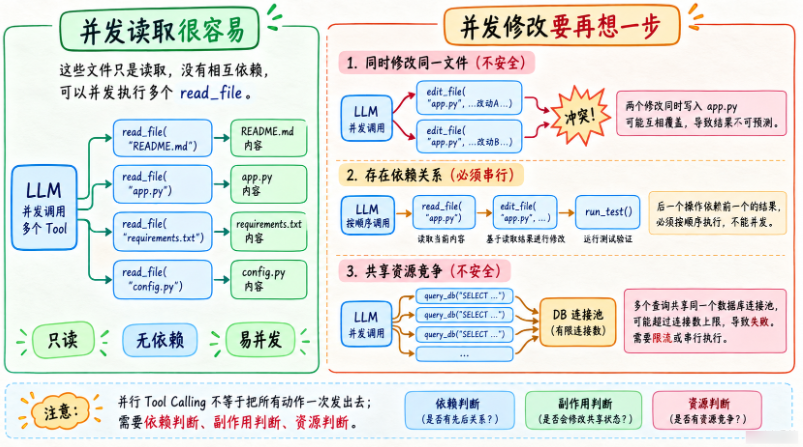
因此并行调度最好同时回答三个问题:有没有数据依赖、会不会改同一份状态、是否竞争同一类系统资源。只有这三层都过关,才适合真正同时执行。
动手观察:保留部分成功
模拟三个读取工具,一个成功、一个超时、一个返回权限拒绝。参考结果是三个调用都有可追溯记录,成功结果仍可使用,超时与拒绝的后续策略不同。再比较串行与并发的总耗时,说明提升来自哪一段,以及并发限制是否被遵守。
案例分析一:Coding Agent 并行读取 4 个核心文件,为什么可以明显缩短“项目理解”时间?
场景背景
用户把一个陌生 Flask 项目交给 Agent:
README.md
app.py
requirements.txt
config.py
任务,“快速告诉我这个项目怎么启动、依赖什么、主要配置在哪里。”
四个文件内容独立。
串行版本
Agent:
read README
 ↓
read app.py
 ↓
read requirements
 ↓
read config
 ↓
总结
假设每个 Tool 因远程文件服务需要:
0.7 秒总时间大约:
2.8 秒再加模型调用。
并行版本
模型一次输出四个 Tool Call:
read README
read app.py
read requirements
read config
Harness 检查:
全部 read-only
路径不同
无数据依赖
parallel_safe
于是进入:
Parallel Executor四个 Tool 同时执行。
Observation
批量结果:
README:
启动命令 python3 app.py

app.py:
Flask 服务,端口 5000

requirements:
flask、requests

config:
DEBUG=False
DATABASE_URL=...
下一轮模型一次总结。
结果
Agent 不仅快,而且 Step 更少。
原本可能:
4 次 Tool Step现在是:
1 次模型决策
1 个 Parallel Tool Batch
1 次模型总结
这个 Coding Agent 案例很适合拿串行和并行做一次直观对比。四个文件都属于独立读取,所以它们的总等待时间可以从四次 I/O 之和,压到接近最慢的那一次读取。
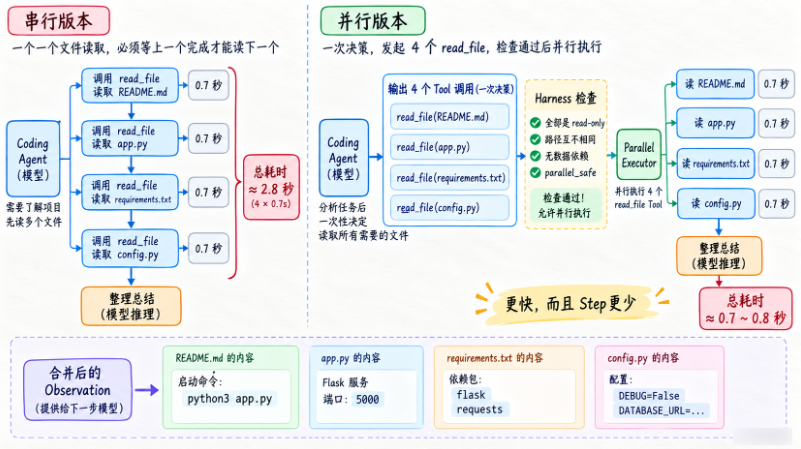
收益不只体现在墙钟时间上,Step 也更少:模型先一次决定需要哪些文件,Harness 并发采集证据,然后模型基于合并后的 Observation 统一总结。
为什么这个案例适合并行?
因为四个动作:
都是读取
没有依赖
没有共享写资源
属于非常标准的并发场景。
如果 config.py 不存在怎么办?
其他三个仍然成功。
Batch Observation:
README success
app.py success
requirements success
config.py FileNotFoundError
模型下一轮可以:
search_files("config")而不是让整个批次失败。
这就是,Parallel Execution + Error Recovery
的组合。
迁移
同样适用于:
并行读取多个配置文件
并行读取多个日志分片
并行读取不同模块代码
并行查询多个独立 API















请登录后查看评论内容