




章末自测
题目 1:为什么内存版 SessionManager 和 RunManager 不能算真正持久化? 请从服务重启、多 Worker、多实例和历史查询四个角度解释。 内存对象只存在于当前 Python 进程,服务重启后会重新初始...
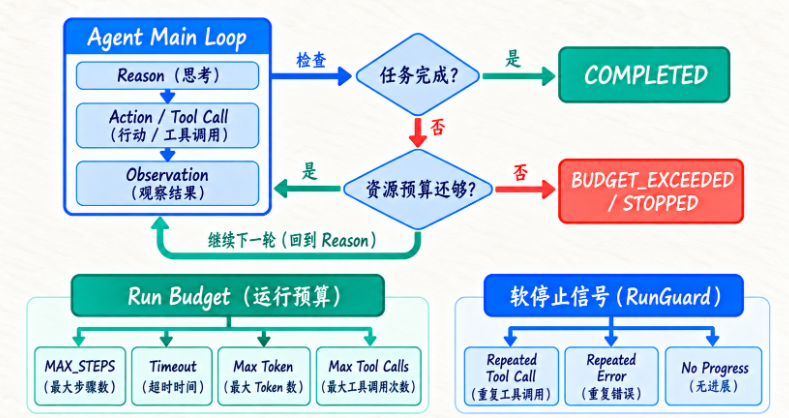
第5部分:让 Agent 不会“发疯” 死循环:Agent 为什么会一直干活?
前面几部分,我们一直在给 Agent 增加能力。 最开始它只有: Reason ↓ Action ↓ Observation ↓ Reason 后来我们给它加了: Tool Registry Tool Schema Error Recovery Parallel Tool Calling...
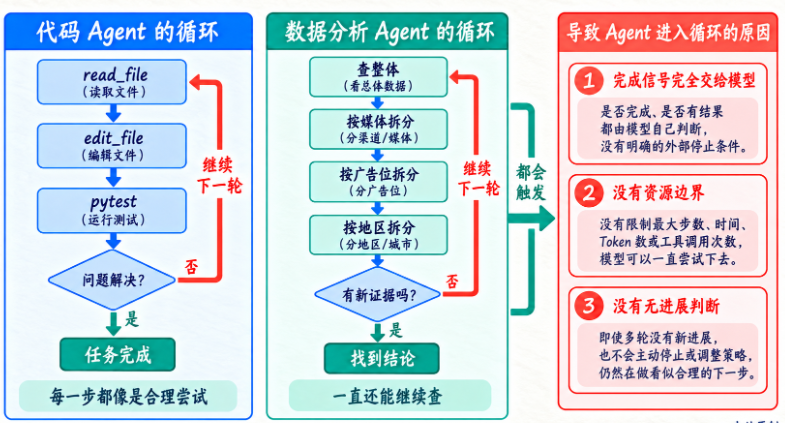
小节一:为什么 Agent 会陷入死循环——问题不只是 while True,而是“每一步都看起来合理”
很多同学一提到“死循环”,第一反应就是代码里是不是写了 while True。但在 Agent 场景里,真正麻烦的点往往不是循环语句本身,而是 每一步都像是合理尝试,所以系统会觉得“再试一次也没问...
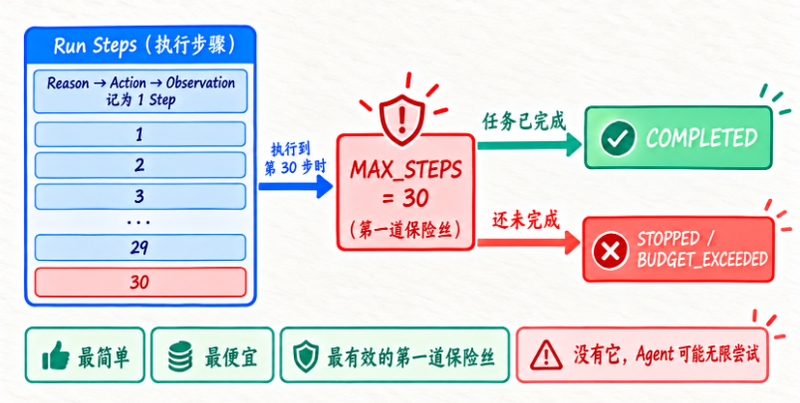
核心小节二:MAX_STEPS 为什么是第一道保险丝——最简单,但一定要有
这一节最想让大家记住的一句话就是:高级策略可以慢慢加,但第一道保险丝不能没有。 MAX_STEPS 不是最聪明的机制,却往往是最先该补上的安全边界。你可以先看看下面这张图,它把“为什么要有...
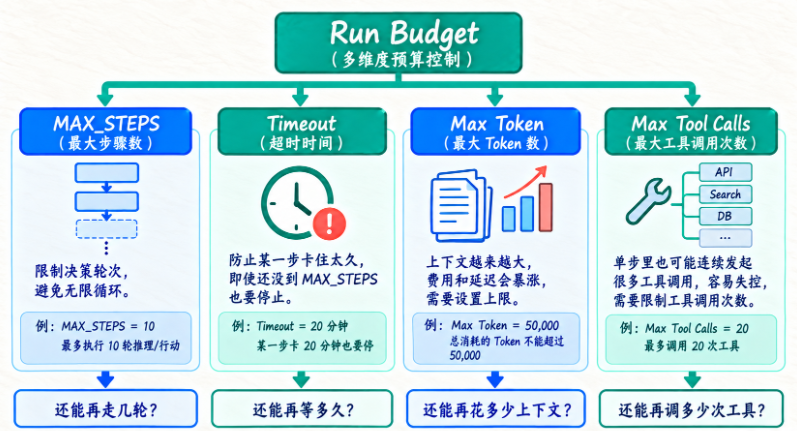
小节三:只有 MAX_STEPS 还不够——Timeout、Max Token、Max Tool Calls 分别在限制什么
只靠步数上限,其实只能回答“还能再走几轮”,却回答不了“还能再等多久、还能再花多少上下文、还能再调多少工具”。所以真正可上线的 Agent,一定不是单一维度的预算控制,而是多维资源一起看...
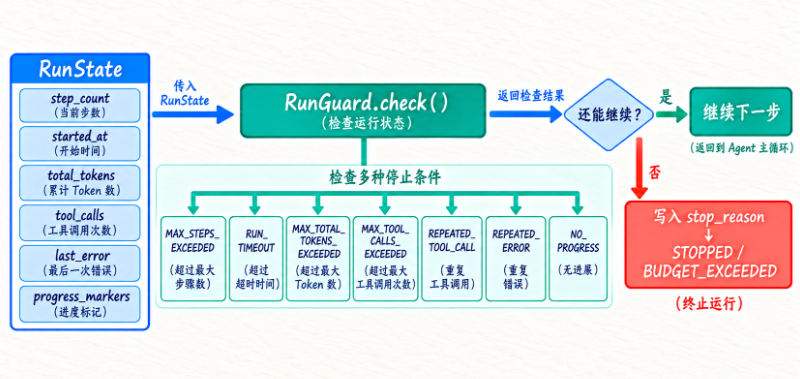
小节四:实现 RunGuard——把步数、时间、Token、Tool Calls 统一变成可检查的资源边界
前面讲的是“应该限制什么”,这一节开始进入“怎么落地”。一个比较顺手的做法,就是把各种预算边界和软停止信号统一交给 RunGuard 来检查。这样 Agent 本身只负责思考和行动,守卫器只负责...
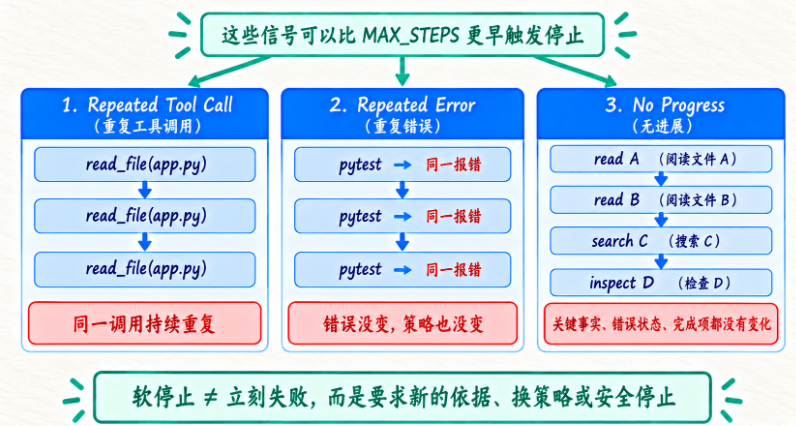
小节五:比 MAX_STEPS 更聪明的停止条件——重复 Tool、重复 Error、No Progress
有了硬预算之后,系统已经不会彻底失控了。但如果每次都非得等到第 30 步、第 300 秒或者第 50,000 Token 才停,那依然会浪费很多资源。所以更成熟的做法,是尽早识别出“虽然还没超预算,但已...
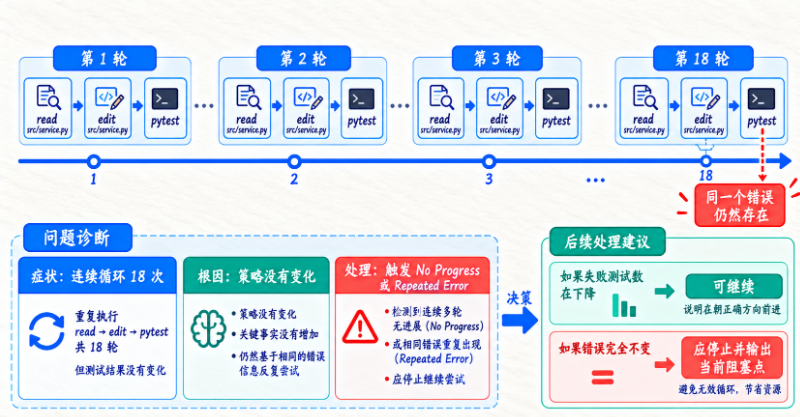
案例分析一:Coding Agent 为什么连续 18 次 read → edit → pytest,却一直修不好?
接下来我们把抽象规则落到具体场景里。Coding Agent 最典型的失控方式,就是不断读取、修改、跑测试,看起来一直很忙,但结果没有任何实质变化。下面这张图,就是把这种“18 轮修不动同一个错误...
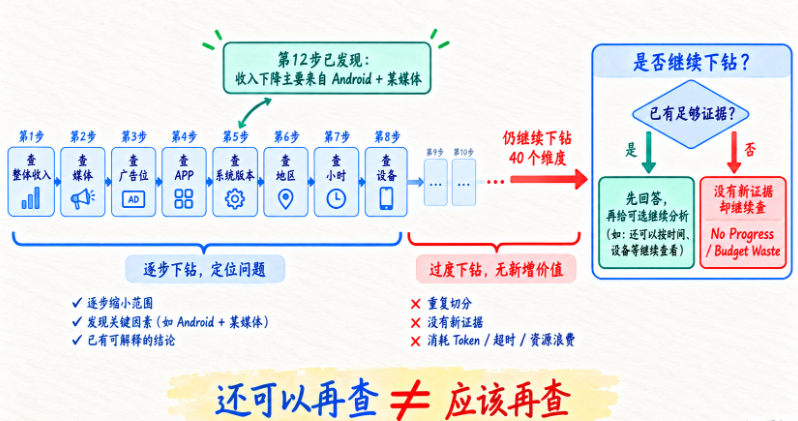
案例分析二:Data Analysis Agent 连续下钻 40 个维度,为什么“还可以再查”不等于“应该再查”?
数据分析场景也很容易出现类似问题。很多时候,Agent 已经顺着媒体、广告位、地区、设备等路径把问题定位得差不多了,但因为“还存在别的切分角度”,它就继续往下钻,最后把本来已经足够的证据...
章末自测
题目 1:为什么一个 while True 的 Agent Main Loop 容易陷入死循环? 请结合“局部动作合理、全局任务无进展”解释,并说明为什么不能完全依赖模型自己判断是否停止。 Agent 每一轮...

