

数据分析场景也很容易出现类似问题。很多时候,Agent 已经顺着媒体、广告位、地区、设备等路径把问题定位得差不多了,但因为“还存在别的切分角度”,它就继续往下钻,最后把本来已经足够的证据查成了无休止的细分。下面这张图把这个误区画得非常清楚。
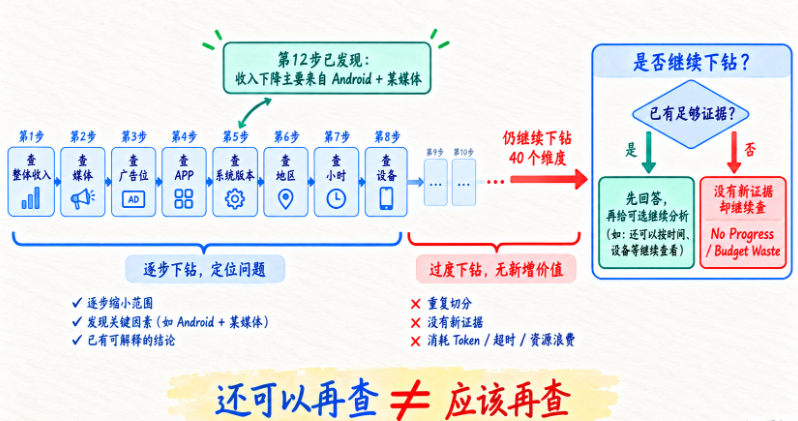
你可以重点看图最下面那句话:“还可以再查 ≠ 应该再查”。 一旦已经有足够证据解释核心问题,正确做法往往是先回答结论,再把“可选继续分析”的方向交给用户,而不是默认继续把预算消耗在没有新增价值的维度切分上。
场景背景
用户问,“昨天收入为什么下降?”
Agent 已经:
查整体
查媒体
查广告位
查 APP
查系统版本
查地区
查小时
查设备
其实在第 12 步已经发现:
media_B
position_17
eCPM -42%
已经有很强结论。
但模型觉得:
还可以继续查机型
还可以继续查网络
还可以继续查版本
于是继续调用 SQL Tool。
没有 Max Tool Calls
很快:
query_sql 30 次大量 Token 和数据库资源被消耗。
结果结论并没有变。
设置预算
例如:
MAX_TOOL_CALLS = 20
MAX_STEPS = 25
MAX_TOKENS = 120K
并且定义:
如果核心结论连续 5 Step 不变,
而新增查询没有产生新异常维度,
触发 no_progress。
Agent 在第 18 步结束。
结果
不是查得越多越专业。
而是,在证据足够时结束。
这其实也是 Agent 资源边界的另一面:
既防死循环
也防过度分析
迁移
类似问题还会出现在:
Research Agent
网页搜索 Agent
SQL Agent
Browser Agent
Code Review Agent
只要 Agent 可以持续:
“再查一点”就必须有预算。
常见误区
误解: 只要 Prompt 里写“不要死循环”,模型就会自己停。
正解: Prompt 可以作为行为提醒,但不能替代 Harness 里的确定性资源边界。模型可能每一步都认为“还有必要继续”,尤其在 Error Recovery 和开放式搜索任务中。MAX_STEPS、Timeout、Max Token、Max Tool Calls 必须由程序强制检查,模型没有权限绕过这些硬限制。
误解: 有 MAX_STEPS 就够了,其他预算都是优化项。
正解: 一个 Step 可能执行非常久,也可能包含巨大 Context 或多个 Tool Call。只有 MAX_STEPS 无法防止某个 Shell Tool 卡 20 分钟,也无法限制 10 步就消耗 300K Token 的情况。真实 Agent 至少应该同时考虑时间、Token 和 Tool Calls,资源边界是多维的。
误解: Agent 失败就说明系统能力差,所以应该尽量不要主动终止。
正解: 生产系统里“安全停止”本身就是能力。如果任务在预算内无法完成,继续无限尝试只会增加成本和风险。成熟 Agent 应该把已经完成的内容、持续阻塞、停止原因和建议下一步整理清楚,然后让 Run 进入明确的 BUDGET_EXCEEDED 终态。可控停止比不可控运行更重要,也不要把预算耗尽和普通执行错误混成同一种 FAILED。
误解: Tool Error Recovery 越强,Agent 越不容易死循环。
正解: Recovery 没有预算时反而可能制造更长循环。Retry、Fallback、重新读取、重新执行都属于继续尝试。如果同一个错误反复出现,必须有错误次数上限和策略变化要求。Error Recovery 与 Error Budget 应该同时设计,否则“自动恢复”会变成“自动重复”。
误解: 重复 Tool Call 检测可以完全解决死循环。
正解: Agent 可能每次调用不同 Tool,但任务仍没有进展,例如 read A、read B、read C、search D。重复检测只能发现明显重复模式,不能识别所有 No Progress。真正的最后保险仍然是硬预算,同时可结合 Working Memory、错误重复和新事实数量做无进展判断。
误解: Token Budget 只跟费用有关,和 Agent 安全没什么关系。
正解: Token 不只是成本指标,它还直接影响 Context Window、延迟和任务持续时间。一个 Agent 如果不断扩展 Context,可能在达到 Step 限制前就把上下文撑满,或者造成极高延迟。因此 Max Token 既是成本边界,也是运行资源边界,应纳入 RunGuard 统一管理。
误解: RunGuard 检查到 300 秒,就能自动杀掉任何正在阻塞的 Tool。
正解: Main Loop 里的时间检查通常是协作式停止,只能阻止下一步。Provider、HTTP、Shell 和 SQL 还要各自接收不超过 Run 剩余时间的 timeout,进程彻底卡死则由 Worker lease 或 watchdog 处理。
误解: 服务重启后重新创建 RunGuard,预算自然从零开始最合理。
正解: 这会让反复崩溃或重试的任务获得无限额度。Usage、deadline 和停止原因要随 Run 持久化;恢复执行时继承已消耗额度,SubAgent 也只能使用父 Run 划分的预算切片。
误解: 并行 Tool Call 启动前,每个线程各检查一次剩余额度就够了。
正解: 多个线程可能同时看到同一份余额并全部通过。应在调度前一次性预留整批额度,预留成功再启动;失败时不执行任何有副作用的动作,或者按明确且可追踪的策略截断。
















请登录后查看评论内容