

只靠步数上限,其实只能回答“还能再走几轮”,却回答不了“还能再等多久、还能再花多少上下文、还能再调多少工具”。所以真正可上线的 Agent,一定不是单一维度的预算控制,而是多维资源一起看。下面这张图就把四种最关键的预算边界拆开讲清楚了。
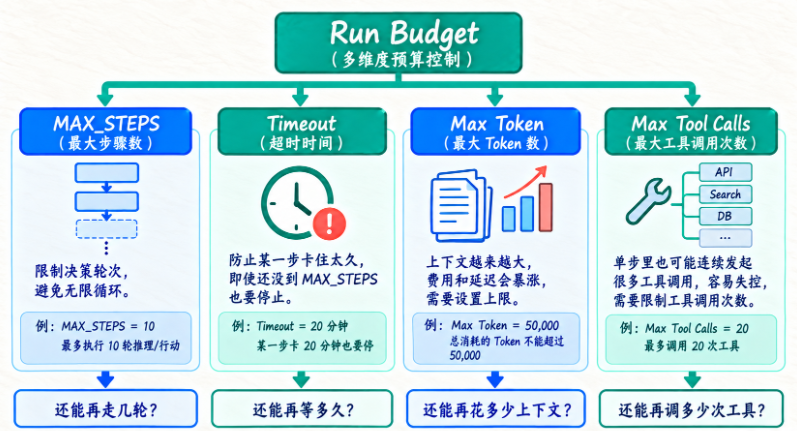
你会发现,MAX_STEPS 管的是轮次,Timeout 管的是时间,Max Token 管的是上下文与成本,Max Tool Calls 管的是工具调用密度。四个指标合在一起,才像一个真正可落地的运行预算系统。
只限制 Step 还不够。
因为:
1 个 Step可能非常贵。
比如某一步:
run_shell卡 20 分钟。
或者一次 LLM Call:
输入 100K Token
输出 20K Token
所以真正的 Run Budget 至少需要四维:
Max Steps
Timeout
Max Token
Max Tool Calls
Timeout:限制总时间
例如:
RUN_TIMEOUT_SECONDS = 300表示一个 Run 最多 5 分钟。
为什么需要?
因为某些 Tool 可能:
网络超时
测试卡死
Shell 不返回
外部 API 卡住
如果只限制 Steps:
Step 8可能永远不结束。
所以需要:
Wall Clock TimeoutTool 自己也要有 Timeout
总 Run Timeout 不等于 Tool Timeout。
例如:
Run 300s
Shell Tool 60s
HTTP Tool 20s
这样单个 Tool 不会吃光全部预算。
这里要分清“检查超时”和“中断执行”。RunGuard 在两轮之间检查 time.monotonic(),只能阻止下一步开始;如果 Provider 或 Tool 已经卡在一次阻塞调用里,它不会凭空把那段代码打断。因此超时要逐层传递:
Run 剩余 42s
Provider 配置上限 90s
本次 Provider timeout = min(42s, 90s)
Shell、HTTP、SQL 和子进程也使用同样思路。更外层还需要 Worker lease 或 watchdog:如果整个进程失去响应,由调度层回收任务并修正 Run 状态。应用内计时、单次调用超时和进程外看门狗,解决的是三层不同问题。
等待人工审批是否消耗 Run 时间也要提前约定。通常我们会暂停“主动执行时间”预算,同时给审批本身设置独立过期时间;否则用户午休回来,任务可能只是因为等人而耗尽计算预算。
Max Token:限制模型资源
Agent 多轮运行很容易不断消耗:
Input Token
Output Token
所以可以定义:
MAX_TOTAL_TOKENS = 200000每次 Provider 返回 usage:
input_tokens
output_tokens
累加:
total_tokens += ...达到预算就停止。
为什么 Token Budget 很重要?
因为即使 Step 很少:
10 Step每一步 Context 都很大。
总成本依然可能很高。
所以:
Step Budget和:
Token Budget不是一回事。
Max Tool Calls:限制动作数量
某些 Agent 会疯狂调用 Tool。
例如:
search
read
search
read
search
read
模型调用次数可能不多。
但 Tool 已经 50 次。
于是可以:
MAX_TOOL_CALLS = 50尤其高成本 Tool:
SQL
Browser
Shell
External API
更值得单独限制。
甚至可以按 Tool 分类预算
例如:
read_file: 30
run_shell: 10
query_sql: 12
write_file: 5
这样比统一 Tool Count 更精细。
并行 Tool Calling 还要先做额度预留。假设只剩 2 次 Tool Call,模型一次返回 5 个动作;如果五个线程各自看到“还有 2 次”,再分别启动,就会瞬间超额。正确顺序是先在一个原子操作里检查并预留 5 个名额,不足就拒绝整批或按明确规则截断,再开始并行执行。
tool_names = [
    call.name
    for call in response.tool_calls
]

guard.reserve_tool_calls(
    tool_names
)

dispatch_tools(
    response.tool_calls
)
配套项目采用整批拒绝,语义最清楚:预留失败时一个 Tool 都不会启动。若产品希望只执行前两个,也要把截断策略写进 Trace,不能静默丢掉后三个动作。
Retry 也必须计入预算。第一次 HTTP 请求失败、框架自动重试三次,不能在指标里仍只算一次动作。否则重试层会悄悄绕过 Harness 的资源边界。对于浏览器、Shell、写文件等高风险或高成本 Tool,我们还可以同时设置重试预算与单工具预算。
一个统一 ResourceBudget
from dataclasses import dataclass


@dataclass
class ResourceBudget:
    max_steps: int = 30
    max_seconds: float = 300.0
    max_total_tokens: int = 200000
    max_tool_calls: int = 50
再加 Usage:
from dataclasses import dataclass


@dataclass
class ResourceUsage:
    steps: int = 0
    elapsed_seconds: float = 0.0
    tokens: int = 0
    tool_calls: int = 0
然后判断:
usage <= budget这就开始像真正 Runtime Resource Guard。
















请登录后查看评论内容