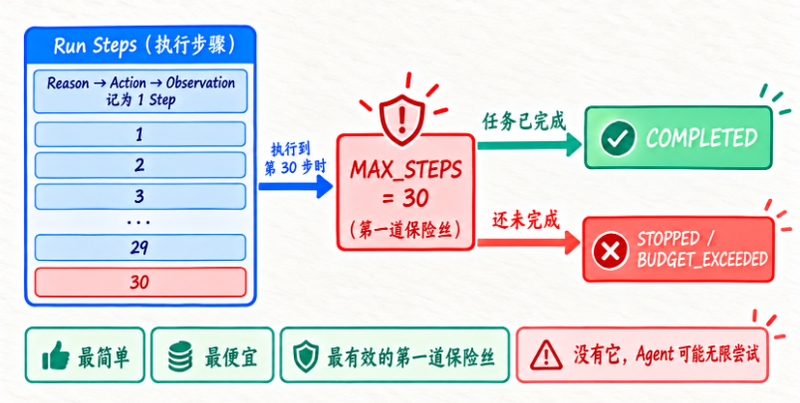


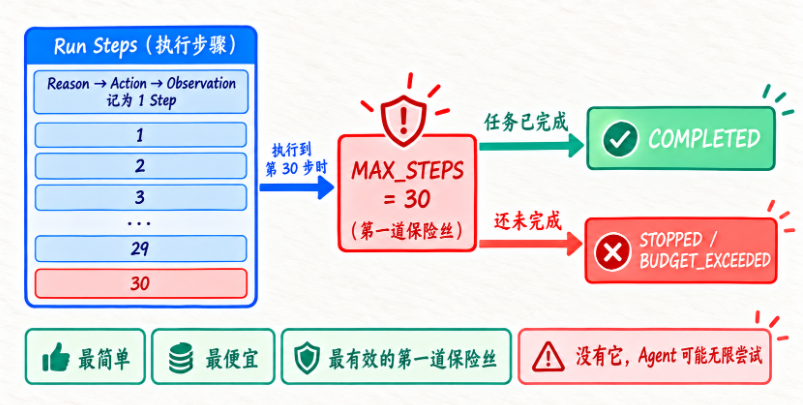
前面讲的是“应该限制什么”,这一节开始进入“怎么落地”。一个比较顺手的做法,就是把各种预算边界和软停止信号统一交给 RunGuard 来检查。这样 Agent 本身只负责思考和行动,守卫器只负责判断“还能不能继续”。
从图里你可以很直观地看到,RunState 里保存了步数、开始时间、累计 Token、工具调用次数、最近错误和进度标记;RunGuard.check() 统一读取这些状态,然后返回“继续执行”还是“写入 stop_reason 并停止”。把职责拆到这个程度,整个系统就会清晰很多。
现在我们正式实现一个:
RunGuard它不负责 Agent 思考。
只负责,检查还能不能继续。
这是非常清楚的职责。
设计停止原因
我们先定义:
MAX_STEPS_EXCEEDED
RUN_TIMEOUT
MAX_TOTAL_TOKENS_EXCEEDED
MAX_TOOL_CALLS_EXCEEDED
未来继续加:
REPEATED_ERROR
REPEATED_TOOL_CALL
NO_PROGRESS
完整可运行代码
注意这里一个细节。
我们在每轮开始前:
guard.check()然后执行。
也可以在执行后再 check。
具体顺序要统一。
为什么使用 time.monotonic()?
不要使用系统时间计算运行时长。
系统时间可能:
被校时
被调整
time.monotonic() 更适合测量持续时间。
这是一个小但很实用的工程细节。
RunGuard 应该在哪里调用?
最自然的位置:
AgentEngine Main Loop例如:
while True:
    guard.check()

    guard.record_step()

    response = provider.chat(...)

    trace.record_model_turn(response)

    guard.record_tokens(
        response.input_tokens,
        response.output_tokens,
    )

    guard.reserve_tool_calls([
        tool_call.name
        for tool_call in response.tool_calls
    ])

    for tool_call in response.tool_calls:
        execute_tool(tool_call)
这样所有资源都统一监控。模型响应先进入 Trace,再登记它实际返回的 Token Usage;如果这一次调用把累计 Token 推过上限,Run 会停止,响应里请求的 Tool 不再执行。Tool Call 也在真正执行前占用额度,避免动作已经产生副作用后才发现预算不足。
这里无法做到“绝不超过一个 Token”。模型调用前只能估算输入和最大输出,真实 Usage 要等响应回来才知道。严格成本场景可以在调用前预留额度,例如用 estimated_input + max_output_tokens 做 admission check,调用完成后再按真实 Usage 结算差额。
达到边界时怎么办?
Service 捕获:
BudgetExceededError然后:
RunManager.mark_budget_exceeded(...)例如:
{
  "status": "budget_exceeded",
  "reason": {
    "code": "MAX_STEPS_EXCEEDED",
    "used": 30,
    "limit": 30
  }
}
Run 不再是失控状态。
而是进入一个可查询、可统计、可解释的预算终态。只有代码异常、依赖故障等执行错误才进入 FAILED。
















请登录后查看评论内容