

很多同学一提到“死循环”,第一反应就是代码里是不是写了 while True。但在 Agent 场景里,真正麻烦的点往往不是循环语句本身,而是 每一步都像是合理尝试,所以系统会觉得“再试一次也没问题”。下面这张对比图,把 Coding Agent 和 Data Analysis Agent 两种常见循环方式摆在了一起。
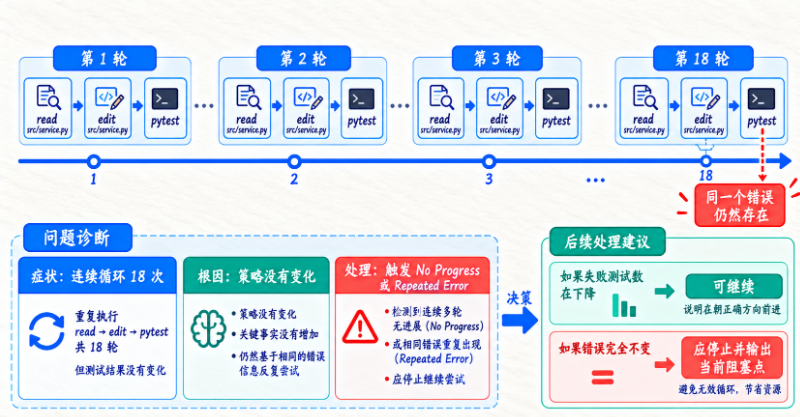
看完这张图你会很直观地发现:代码修复场景里,read → edit → pytest 可以一直重复;数据分析场景里,按媒体、广告位、地区不断下钻也可能一直继续。表面上路径不同,本质却是同一件事——系统没有外部停止边界,完成与否都交给模型自己判断。
最简单的 Main Loop 是:
while True:
    response = llm(...)
    if response.done:
        break
    execute_tool(...)
这个结构本身没有错。
问题在于,什么时候 done?
如果完全交给模型判断,就会出现一种很典型的情况:
模型永远觉得还有下一步可以尝试。Coding Agent 最典型的循环
比如:
read
 ↓
edit
 ↓
test
 ↓
fail
 ↓
read
 ↓
edit
 ↓
test
 ↓
fail
模型每次都能解释:
“刚才改得还不够。”下一轮:
“也许应该看另一个文件。”再下一轮:
“这个错误可能来自配置。”从局部看都合理。
但从全局看:
已经 20 步没有本质进展。这就是 Agent 失控的核心特征,局部动作合理,全局任务无进展。
为什么 Error Recovery 反而可能加重循环?
前面我们实现了:
Tool Error Recovery
Retry
Fallback
这些能力本身是对的。
但如果没有边界:
失败
→ retry
→ fallback
→ 再失败
→ 再 retry
→ 再 fallback
Recovery 也会变成循环放大器。
所以,Error Recovery 必须有 Error Budget。
比如同一个错误:
最多重复 3 次同一个 Tool Call:
最多连续重复 2 次为什么 Working Memory 也不一定能阻止死循环?
Working Memory 可以保存:
completed
errors
next_action
它能帮助 Agent 记住,“我做过什么。”
但它并不会自动强制停止。
如果 Agent 每轮都更新:
next_action = 再试一次它还是会继续。
所以,Memory 负责认知连续性,Guard 负责资源边界。
二者职责不同。
三类典型循环
第一类:
重复 Tool Call例如:
read_file("app.py")
read_file("app.py")
read_file("app.py")
第二类:
重复 Error例如:
pytest
→ ModuleNotFoundError: requests

pytest
→ ModuleNotFoundError: requests

pytest
→ ModuleNotFoundError: requests
第三类:
路径在变,但没有进展比如:
read A
read B
read C
search D
read E
看似不是重复。
但 Goal、Error、验证结果都没改变。
这是最难检测的一类,No Progress Loop。
Agent 为什么会出现 No Progress?
原因可能有很多:
模型没有足够信息
Tool 不够
权限不足
环境无法满足
任务本身不可完成
错误 Observation 太差
Context 已经混乱
所以停止并不代表 Agent “笨”。
有时候停止反而说明,Harness 足够成熟。
资源边界本质上是什么?
它就是告诉 Agent:
你可以自主做决定,
但自主不是无限的。
可以把它想成:
Goal
+
Autonomy
+
Budget
而不是:
Goal
+
无限尝试
这就是这一章最核心的思想。
















请登录后查看评论内容