



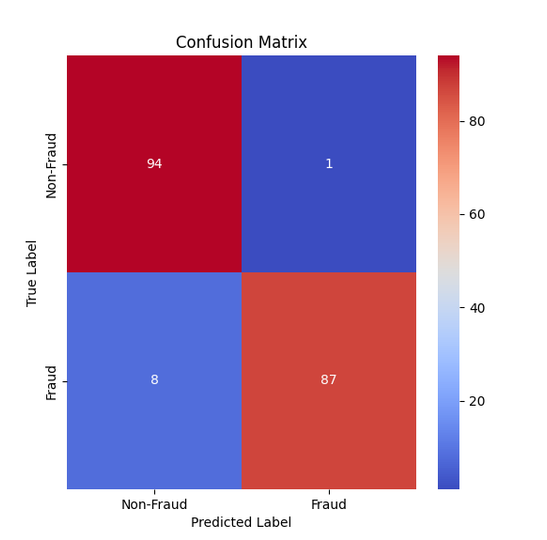
5. 模型训练与评估
在这一部分,我们对 XGBoost 模型进行训练,并使用多种指标评估其性能。 接着,我们会进行超参数优化(使用网格搜索或随机搜索),以提升模型效果,并可视化模型的表现。 5.1 模型训练 在上一部...
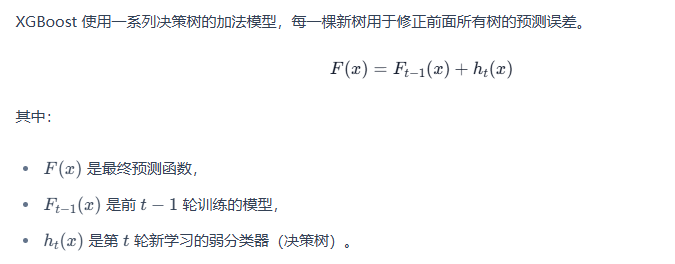
4. 模型选择与构建
选择一个适合的模型进行欺诈交易检测,并详细介绍其原理及适用性。 此外,我们会进行多维度数据分析,以提高欺诈识别的准确性。 4.1 模型选择 在欺诈交易检测问题中,我们面临以下几个挑战: 类...

3. 特征工程
在这一部分,我们将对数据进行特征工程处理,包括特征选择、数据预处理以及数据集划分,为后续建模做准备。 3.1 特征选择 我们需要确定哪些特征对于欺诈交易检测是重要的,可能需要去除无用特征...
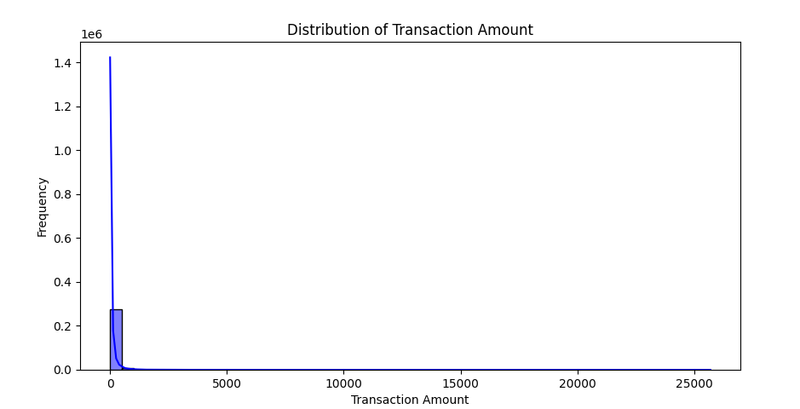
八、信用卡交易数据的基本探索
1. 目标定义和假设设定 1.1 目标定义 本次数据分析的目标是对信用卡交易数据进行基本探索,以识别潜在的欺诈交易模式,并为后续的机器学习建模奠定基础。 具体目标: 数据理解:分析数据的分布...
6. 结果分析与解读
在这一部分,我们将对模型的结果进行详细分析,解释不同聚类方法(K-Means 和 GMM)在客户数据上的表现,并给出具有业务指导意义的解读。 6.1 K-Means 聚类结果分析 6.1.1 K-Means 聚类的特点 ...
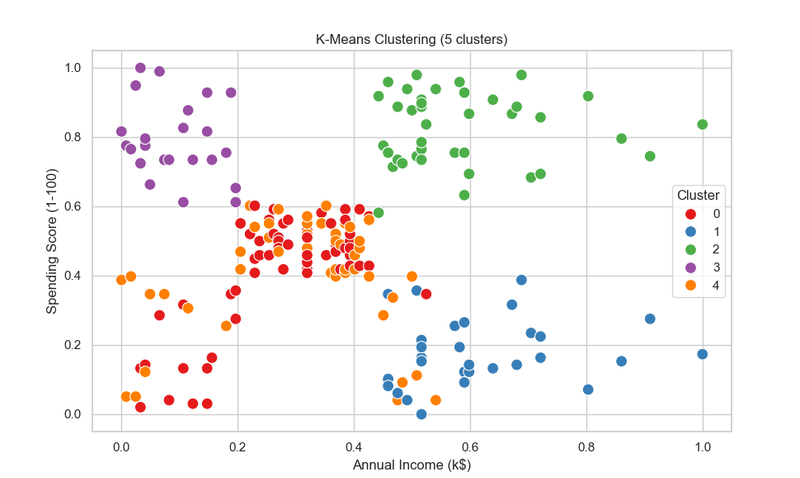
5. 模型训练与评估
在这一部分,我们将通过 Python 实现 K-Means 和GMM 模型的训练与评估,并优化模型参数,最后通过可视化展示模型效果。 5.1 模型训练 5.1.1 训练 K-Means 模型 使用之前的 K 值...
4. 模型选择与构建
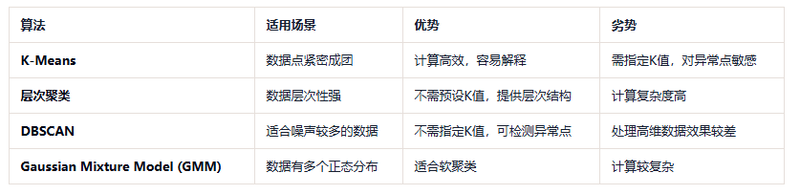
在这一部分,我们将选择合适的聚类算法,并详细介绍其原理、适用性等等。 4.1 模型选择 4.1.1 为什么使用聚类? 本项目的目标是对客户进行分群,而不是预测某个具体值(如收入或消费评分)。这...
3. 特征工程
3.1 选择合适的特征 去除无关特征,数据集中包含以下列: CustomerID(客户ID):是唯一标识符,对聚类没有意义,应当删除。 Gender(性别):可能会影响消费行为,但我们主要关注消费习惯,因...
七、客户分群的基础分析
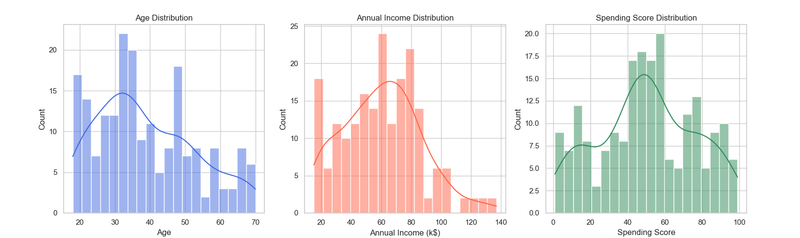
1. 目标定义和假设设定 1.1 分析目标 本案例的目标是 对购物中心的客户进行聚类分析,以便根据其消费行为进行分群。 这有助于商家了解不同类型的客户,从而制定更精准的营销策略,提高客户...
6. 结果分析与解读
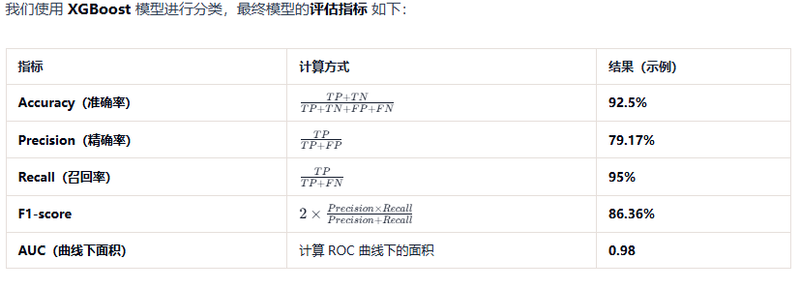
在本部分,我们将深入分析癌症生存率数据集 的模型预测结果,并总结其意义~ 6.1 关键指标回顾 6.2 特征重要性分析 哪些因素对癌症预测影响最大? 6.3 预测概率分析 我们绘制了 预测概...

