



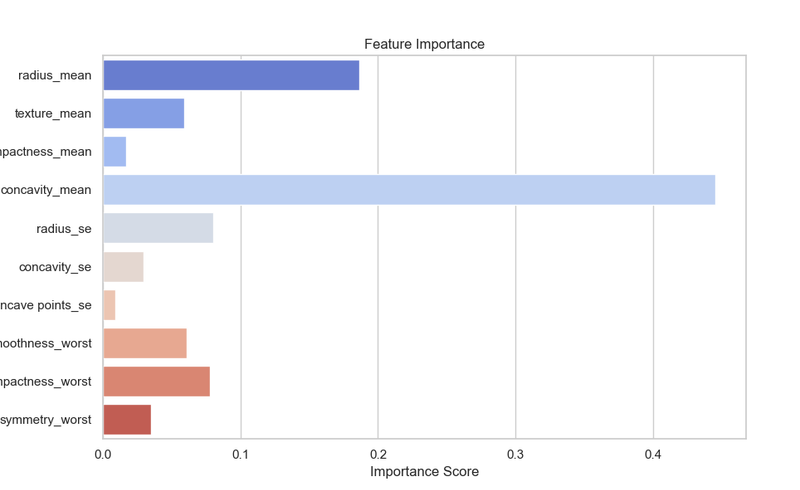
5. 模型训练与评估
在本部分,我们将: 训练 XGBoost 模型 评估模型性能(准确率、召回率、F1-score 等) 使用网格搜索优化超参数 用可视化方法分析模型表现 5.1 模型训练 我们使用 XGBoost 进行训练,...
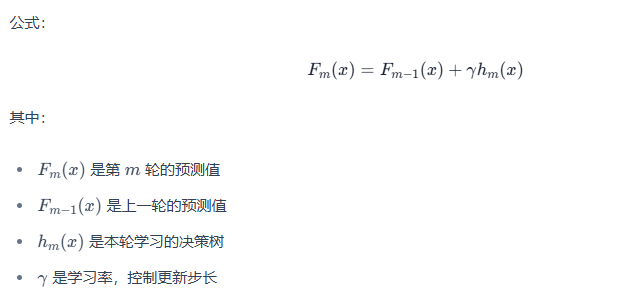
4. 模型选择与构建
4.1 选择适合的模型 我们面临的是一个二分类问题(乳腺癌:良性 or 恶性),适合的模型有: 逻辑回归(Logistic Regression) 支持向量机(SVM) 随机森林(Random Forest) XGBoost(Extreme G...

3. 特征工程
在这部分,我们将对数据进行特征处理,以确保模型能够有效学习数据的模式。 主要步骤: 数据编码(将 diagnosis 变量转换为数值型) 特征选择(去除冗余特征,提高模型效果) 数据标准化(使...
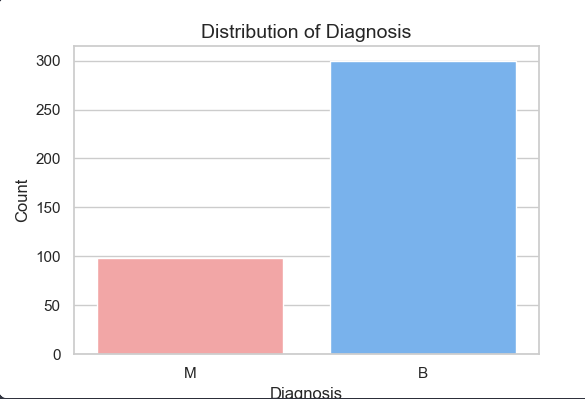
六、基础的癌症生存率数据探索
1. 目标定义和假设设定 1.1 背景介绍 乳腺癌是全球范围内最常见的癌症之一,早期诊断对于提高患者的生存率至关重要。威斯康星乳腺癌数据集(Breast Cancer Wisconsin Dataset)是一份广泛用于机...
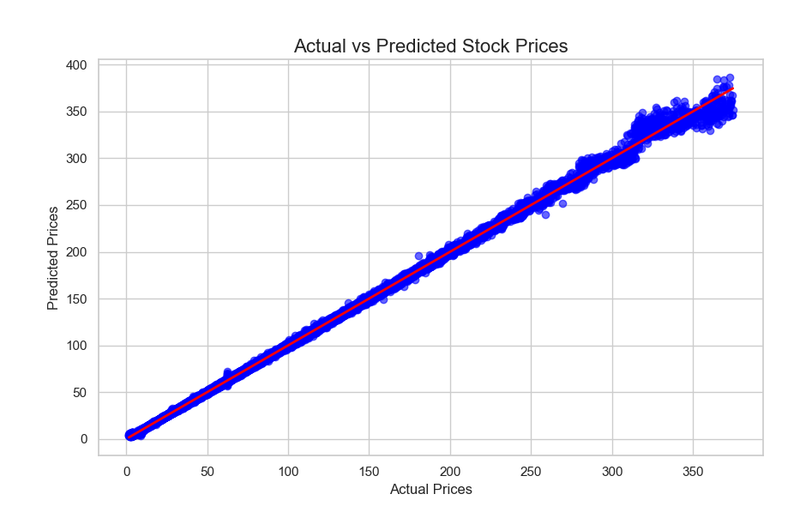
6. 结果分析与解读
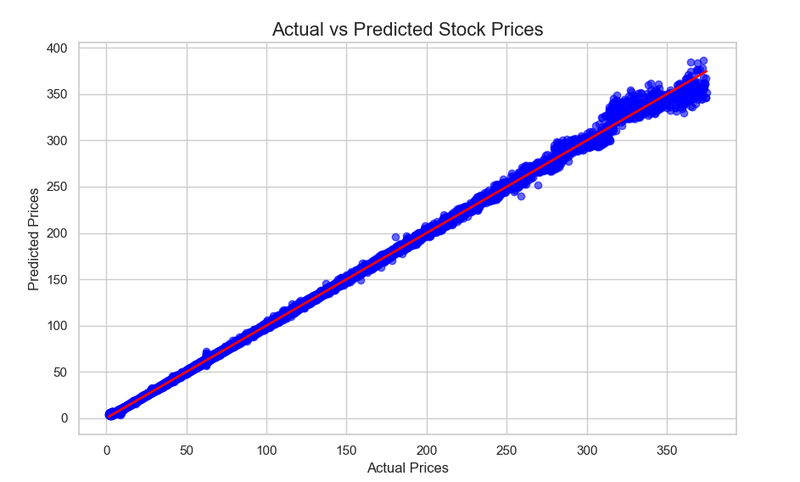
在前面的步骤中,我们使用 XGBoost 模型对股票市场数据进行了训练,并使用均方误差(MSE)、均方根误差(RMSE)和决定系数(R²) 对模型性能进行了评估。 现在,我们将详细分析...
5. 模型训练与评估
上述结论中,我们选择使用 XGBoost 模型进行股票市场的回归预测。 5.1 模型训练 5.1.1 数据准备与分割 首先,我们将数据分为训练集和测试集。一般来说,数据集的 80% 用于训练,20% ...
4. 模型选择与构建
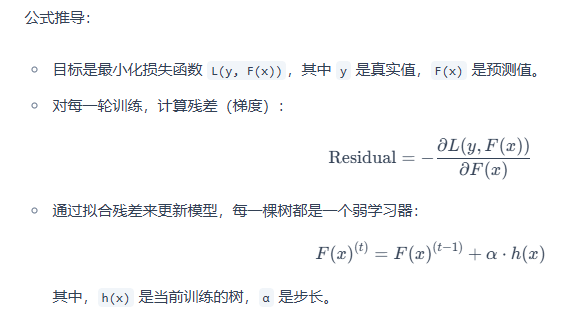
4.1 待选算法模型 在股票市场数据分析中,选择合适的模型是成功的关键。我们面临的任务是回归问题,即预测未来的股票收盘价。股票数据包含历史价格、交易量、技术指标等多个特征,且股市数据通...
3. 特征工程
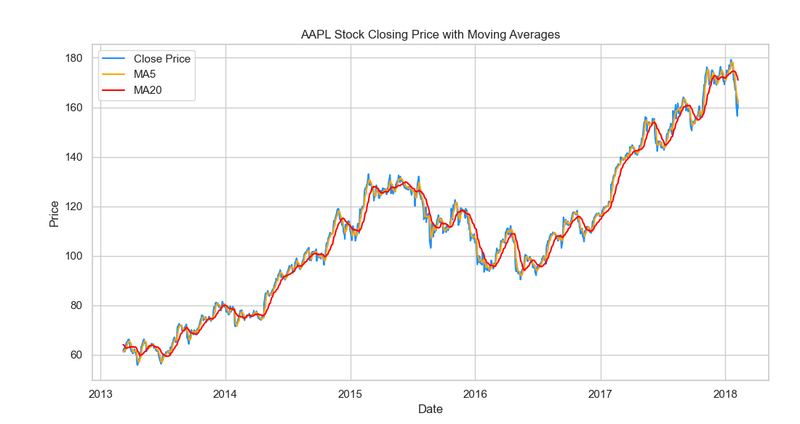
在数据探索后,我们需要进行特征工程,目的是选择合适的特征,并构造新的特征,以便后续的机器学习模型能更好地学习股票价格的变化规律。 3.1 特征选择 我们从原始数据中提取以下特征: 基本价...
五、股票市场历史数据探索
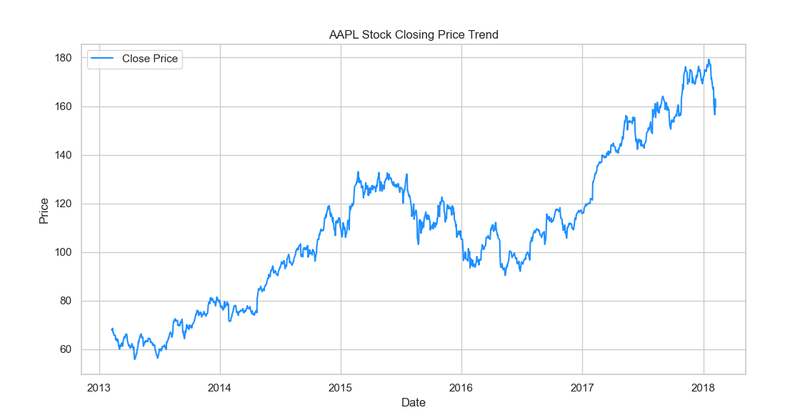
1. 目标定义和假设设定 案例名称:股票市场历史数据探索 数据集来源:Kaggle - Stocks Data 文件路径:./dataset/005/all_stocks_5yr.csv 1.1 背景与业务需求 股票市场是一个复杂的金融系统,价...
6. 结果分析与解读
在这一阶段,我们对模型的训练结果进行详细分析,并从中提炼出对业务具有指导意义的洞察。通过分析模型的性能和数据特征,我们能够提供有关客户流失的重要见解,并为银行的客户管理策略提供指导...

