



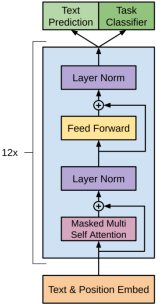
8.3 主流预训练模型详解
8.3.1 GPT 概述 GPT(Generative Pre-trained Transformer)是第一个系统性提出“预训练 + 微调”范式的语言模型。 其核心思想是通过大规模无监督语料进行生成式语言建模预训练,即训练模型根据...

章末自测
题目 1:为什么一个 Agent 已经有 System Prompt 和 Working Memory,仍然需要 System Reminder? 请从长 Context、局部新信息、目标漂移和注意力重新锚定四个角度解释。 System Prompt 提供长...
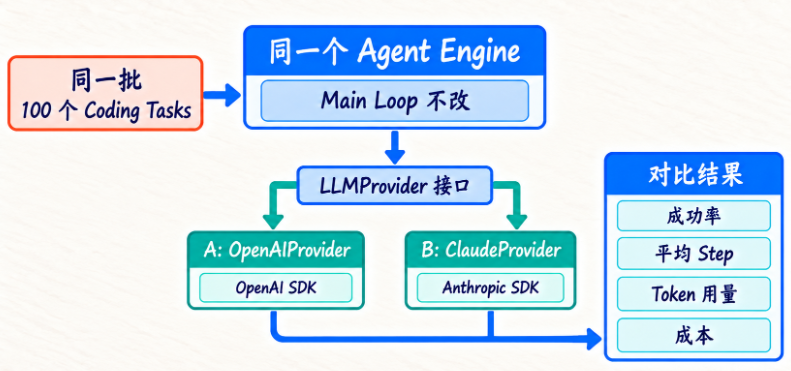
案例分析一:从 OpenAI 切到 Claude,为什么不应该改 Agent Main Loop?
场景背景 假设团队已经有一个 Coding Agent。 Main Loop: THINKING ↓ LLM ↓ TOOL_CALLING ↓ OBSERVING ↓ THINKING 第一版底层使用 OpenAI。 某一天,团队希望在代码分析任务中测试 Claude...
9. 常用内置函数梳理
以下函数是截至目前,我们需要掌握的一些常用函数,注意:下面这些并不是所有,我们后面还会学习到更多的常用内置函数。 9.1. 输入与输出 函数 / 参数功能说明print输出指定内容objects要输出的...
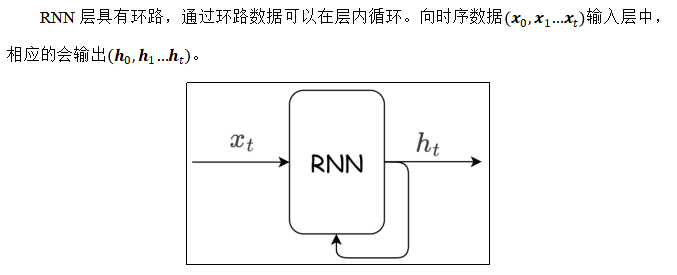
9.3 循环网络层
9.3.1 RNN层介绍 文本是连续的,具有序列特性。如果其序列被重排可能就会失去原有的意义。比如“狗咬人”这段文本具有序列关系,如果文字的序列颠倒可能就会表达不同的意思。 目前我们接触的神...
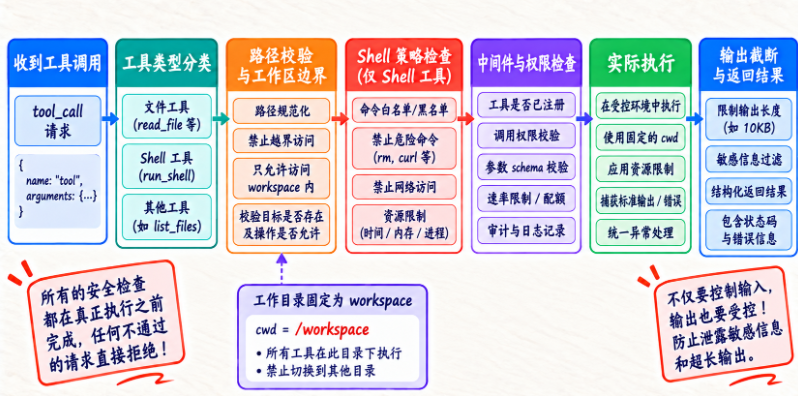
小节四:实现一个统一 SafeToolExecutor——把 Workspace、ShellPolicy、Middleware 真正串起来
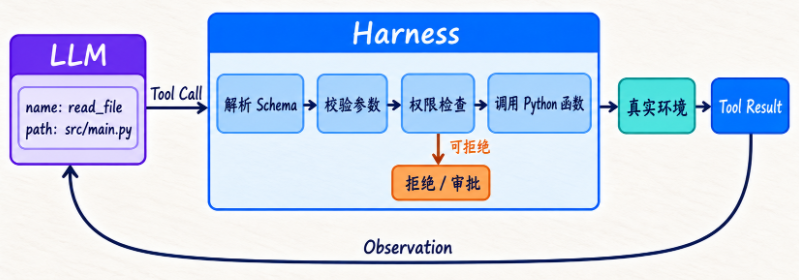
前面几节讲的规则,如果只是分散写在各个工具里,后面很容易失控。所以这一节最核心的思路,就是把安全检查真正收口到一个统一执行入口里。 这张图相当于把整个调用链串起来了:先收到 too...
3.8 案例讲解
# 导入必要的库 import pandas as pd import numpy as np # 1. 数据加载与初步探索 # 读取企鹅数据集,注意解析日期列(虽然这个数据集没有日期列,但展示parse_dates参数的用法) penguins = p...
8.4 HuggingFace快速入门
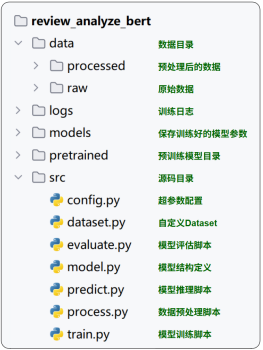
HuggingFace是一个提供预训练模型和相关工具链的平台。 8.5 案例实操(AI智评V3.0) 需求说明 本案例任务是基于预训练 BERT 模型实现评论的情感分析任务。 2.需求实现项目结构 2.完整代码 (1)...
小节一:从“一次调用”到“循环调用”——Agent 真正开始出现的那一刻
我们先从最简单的 LLM 应用开始。 假设现在有一个函数: def chat(prompt: str) -> str: return '模型回答' 用户输入一句话,我们调用一次模型,然后直接返回答案。 这种结构可以完成很多任务:...
小节三:如何设计自己的 Agent Benchmark——任务集比指标公式更重要
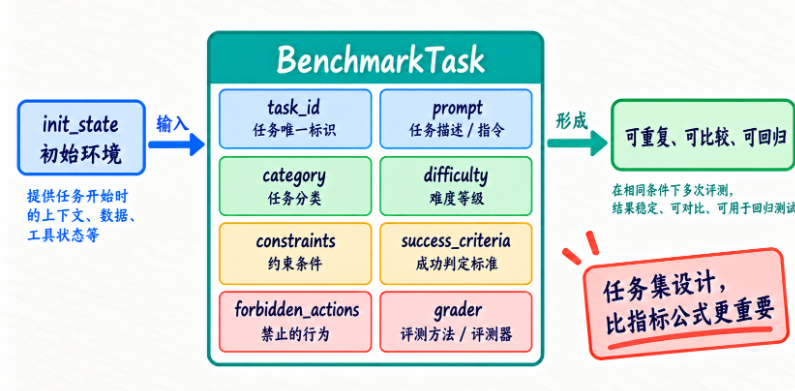
真正决定评测是否可信的,是题目有没有把起点、约束和验收方式说明白。只给一句任务描述,后面即使写出再完整的聚合公式,也没法消除判分歧义。 这张结构图把初始环境、任务字段和重复 Trial 放...

