

真正决定评测是否可信的,是题目有没有把起点、约束和验收方式说明白。只给一句任务描述,后面即使写出再完整的聚合公式,也没法消除判分歧义。
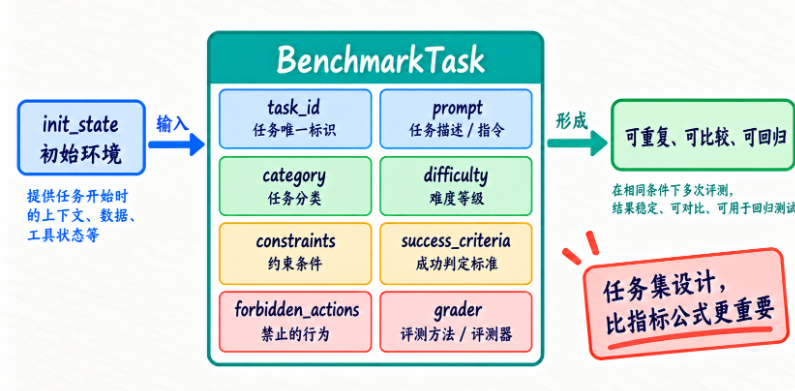
这张结构图把初始环境、任务字段和重复 Trial 放在同一条线上:每次 Trial 都应从独立状态起跑,参考答案与 Grader 信息也不能泄露给被评测 Agent。
很多人一听 Benchmark,会先做:
Excel 表
Dashboard但真正难的是,Benchmark Tasks 设计得好不好。
一个 Benchmark Task 的结构
可以定义:
from dataclasses import dataclass, field


@dataclass
class BenchmarkTask:
    task_id: str
    prompt: str
    category: str
    difficulty: str
    success_criteria: list[str]
    constraints: list[str] = field(default_factory=list)
    expected: list[str] = field(default_factory=list)
    initial_state: dict = field(default_factory=dict)
    grader_names: list[str] = field(default_factory=list)
    tags: list[str] = field(default_factory=list)
timeout_seconds: int = 300这里增加的字段不是为了把数据类写得更长。category 和 difficulty 让我们知道提升发生在哪类任务上;initial_state 用来恢复数据库、文件和权限快照;grader_names 把成功标准落实到具体判分器。尤其是 Reference Output,只能交给 Grader,不能拼进 Agent 的运行上下文,否则评测会在起跑前就泄题。
任务之外还需要一份 Dataset Manifest,至少固定 dataset_version、生成来源、变更说明、Task 列表摘要和内容指纹。任务增删后应生成新版本,比较两个 Agent 时必须选择同一版本。这里容易踩的坑是把线上失败样本补进数据集后,直接拿新结果与旧报表横向比较;Agent 可能完全没变,数字却因为题目变难而下降了。
Coding Agent Benchmark 怎么设计?
不要全是简单任务。
可以分层。
基础:
读取文件并回答
修复单行 Bug
ImportError
TypeError
中等:
多文件修改
测试失败定位
配置迁移
复杂:
陌生项目
多个失败测试
依赖约束
AGENTS.md
Human Approval
Data Analysis Agent Benchmark
可以有:
整体指标异常
量价拆解
维度下钻
多指标冲突
证据不足
异常数据
为什么要覆盖失败场景?
因为一个只测:
“能成功的题”没有意义。
Benchmark 应该包含:
Tool 失败
权限限制
数据缺失
用户约束
高风险动作
长 Context
这样才能测:
Recovery
Safety
Robustness
为什么任务集要固定?
如果 v1 测 20 道题。
v2 换成另外 20 道。
结果不能比较。
所以:
Benchmark Dataset必须相对稳定。
当然可以版本化:
benchmark_v1
benchmark_v2
但对比模型时用同一版本。
为什么同一个任务要多跑几次?
因为 LLM 有随机性。
同一个任务:
Run 1 成功
Run 2 失败
Run 3 成功
很正常。
所以最好:
每个 Task 跑 N 次例如:
3 次
5 次
然后统计:
平均成功率
方差
稳定性
这会比单跑一次可靠得多。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END
















请登录后查看评论内容