

代码读到这里,可以先用下面的执行链核对各个对象的职责。Runner 不是只循环调用模型,它还要保存 Trace、交给 Grader 判定、聚合指标并形成能够复查的报告。
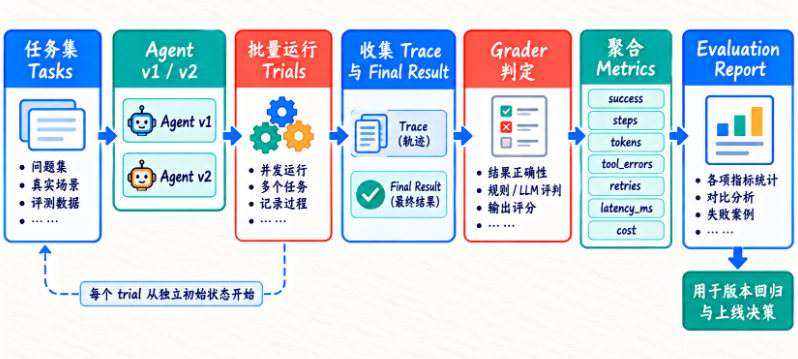
图中回到任务集的箭头代表下一次独立 Trial,不是沿用上一次运行留下的文件或数据库状态。否则重复实验很可能测到环境污染,而不是 Agent 的真实差异。
现在我们实现一个简单版本。
先定义结果。
from dataclasses import dataclass


@dataclass
class EvaluationResult:
    task_id: str
    success: bool
    steps: int
    input_tokens: int
    output_tokens: int
    tool_calls: int
    tool_errors: int
    retries: int
    latency_ms: float
    cost: float
然后聚合。
这个例子已经能输出:
Success Rate
Average Steps
Average Tokens
Tool Error Rate
Retry Rate
Latency
Cost
先别急着把这个最小版本搬进发布流水线。它假设每个 Task 只有一个 Trial,还没有记录数据集、Grader、Agent 版本和约束违规。配套项目中的 EvaluationAggregator 已经补上这些边界:它把 Task 与 Trial 分开,拒绝重复 Trial 和混合版本,并把约束违规作为成功的硬门槛。上面这段代码用来理解基本公式,后面的 Task/Trial 小节再把它推进到可比较实验。
EvaluationRunner 怎么和 Agent 真正连接?
真实流程:
BenchmarkTask
 ↓
AgentService.run()
 ↓
Run / Trace
 ↓
Success Judge
 ↓
MetricsAggregator
 ↓
EvaluationResult
可以做一个:
from __future__ import annotations


class EvaluationRunner:

    def run_task(
        self,
        task: BenchmarkTask,
    ) -> EvaluationResult:
        ...
配套项目已经把这个省略号补成了可运行实现。Runner 接收三样东西:Dataset Case、Agent Callable 和 Grader Callable。每个 Trial 都会真实调用 Agent,再把输出交给 Grader;Agent 或 Grader 抛出的异常不会让整批评测中途消失,而会落成一条带错误信息的失败 Trial。
from agent_harness.observability.evaluation import (
    EvaluationCase,
    EvaluationRunner,
    GradeResult,
    TrialObservation,
)


def agent(case):
    return TrialObservation(
        output=case.input * 2,
        steps=2,
        total_tokens=120,
        tool_calls=1,
    )


def grader(case, output):
    return GradeResult(
        success=output == case.expected,
        details={
            "expected": case.expected,
            "actual": output,
        },
    )


batch = EvaluationRunner(
    agent,
    grader,
    dataset_version="double-v1",
    grader_version="exact-v1",
    agent_version="agent-v1",
).run(
    [EvaluationCase("double-2", 2, 4)],
    trials_per_task=3,
)

print(batch.summary)
这里先采用串行执行,不是 Runner 不会并发,而是 Evaluation 必须先保证 Trial 隔离。若两个 Coding Trial 同时修改同一个 Workspace,或者两个 Data Trial 共享一份会变化的数据库,并发得到的就不是速度提升,而是互相污染。等 Workspace、数据库、时钟和权限快照都能按 Trial 独立创建后,再加并发更稳。
这里 run_task() 里真正调用你的:
AgentEngine然后从:
Run
Trace
读取真实数据。
Success Judge 怎么设计?
Coding Agent 可以比较确定。
例如:
pytest exit code == 0
tests/ 未修改
禁止依赖未变化
目标 Bug 验证通过
Data Analysis 可能需要:
规则判断
人工标签
参考答案
Judge Model
组合。















请登录后查看评论内容