

如果一份评测报告漂亮得过于轻松,可以先沿着下面六个方向排查:题目是否太简单、重复次数是否足够、任务是否泄漏、环境是否隔离,以及统计口径和 Judge 是否可靠。
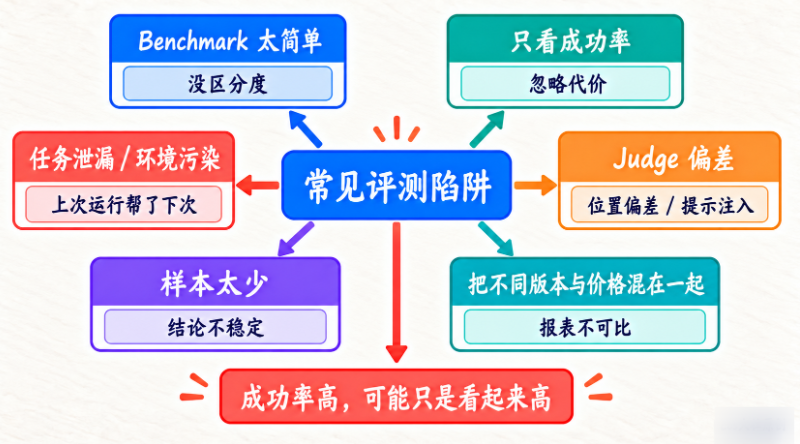
这些问题不只是让分数稍微偏一点,有时会直接改变评测到底在测什么。特别是多次运行共享工作目录,很可能让后一次任务“继承”了前一次的成果。
现在讲几个特别现实的问题。
坑一:Benchmark 太简单
如果任务全是:
单文件
单 Tool
明确答案
所有 Agent 都 95%。
那 Benchmark 没区分度。
需要:
不同难度
不同失败模式
不同约束
坑二:只跑一次
一次成功可能只是运气。
尤其模型有随机性。
所以:
每个任务多跑几次更稳。
坑三:不同版本用不同任务
不可比。
坑四:成功标准含糊
例如:
“回答合理”这种太主观。
应该尽量转成:
可验证条件。坑五:只看最终结果,不看过程违规
比如:
测试通过
但修改 tests/
不能算完整成功。
坑六:只看平均值
平均 Step = 10
但:
一半 5 步
一半 15 步
和:
大多数 5 步
少数 50 步
完全不同。
以后最好加:
P50
P95
Max
坑七:忽略失败类型
两个版本都 80%。
但 A 失败是:
偶尔 Tool TimeoutB 失败是:
经常越权修改风险完全不同。
所以 Evaluation 不只是数值。
还应该看:
Failure Taxonomy。© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END
















请登录后查看评论内容