排序

7.3. sorted 函数
sorted函数:对一组数据进行排序,返回一组新数据。 语法格式:sorted(可迭代对象, key=xxx, reverse=xxx) # 数字排序 nums = [30, 40, 20, 10] result = sorted(nums, reverse=True) print...
 11天前
4.3. 字符串常用方法
1️⃣使用字符串.index(字符),获取『指定字符』在字符串中『第一次』出现的下标,返回值:下标。 # index 方法:获取指定字符,在字符串中第一次出现的下标 msg = 'welcome to dsrw' result = ...
12天前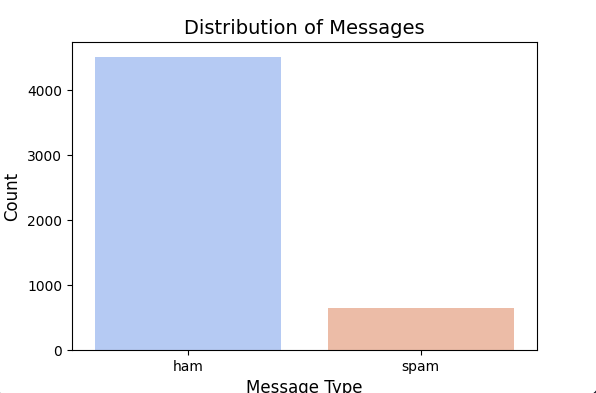
九、垃圾邮件检测的基础探索
1. 目标定义和假设设定 1.1 背景介绍 在现代通信中,垃圾短信(Spam SMS)不仅影响用户体验,还可能涉及诈骗、广告骚扰等问题。因此,自动化垃圾短信检测是一个重要的任务。通过机器学习,我们...
9天前3.4 数据的导入与导出
导出数据 方法说明to_csv() 将数据保存为csv格式文件,数据之间以逗号分隔,可通过sep参数设置使用其他分隔符,可通过index参数设置是否保存行标签,可通过header参数设置是否保存列标签。...
10天前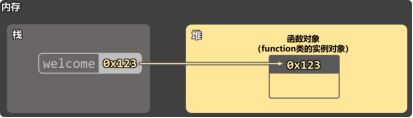
第 8 章 函数进阶
1. 重新认识函数 1️⃣函数也是对象。 a1 = 100 # a1是int类的实例对象 a2 = 'hello' # a2是str类的实例对象 a3 = [10, 20, 30] # a3是list类的实例对象 # welcome函数是function类的实例对...
11天前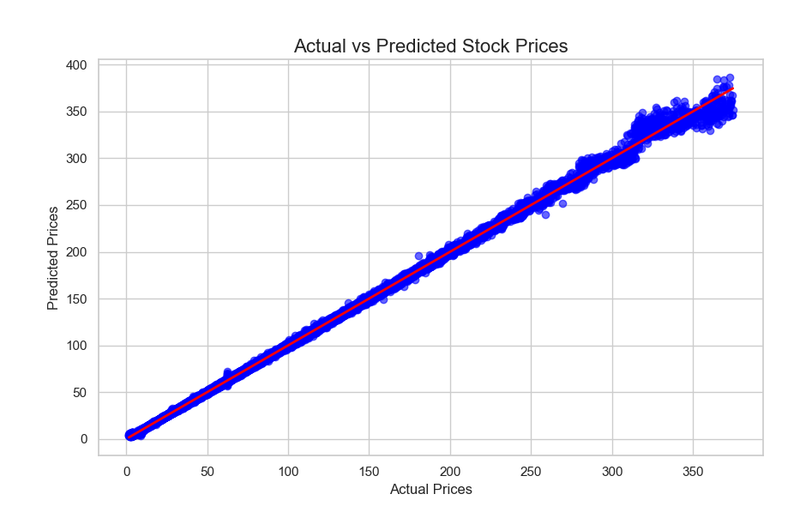
6. 结果分析与解读
在前面的步骤中,我们使用 XGBoost 模型对股票市场数据进行了训练,并使用均方误差(MSE)、均方根误差(RMSE)和决定系数(R²) 对模型性能进行了评估。 现在,我们将详细分析...
9天前7.5. 集合的数学运算
集合的数学运算如下: s1 = {10, 20, 30, 40, 50, 60} s2 = {40, 50, 60, 70, 80, 90} # 并集 result = s1 | s2 print(result) # 交集 result = s1 & s2 print(result) # 差集 result = s1 ...
11天前2.2.6 基本运算
numpy中的数组不用编写循环即可执行批量运算,称之为矢量化运算。 大小相等的数组之间的任何算术运算都会将运算应用到元素级。 arr1 = np.array([[1, 2, 3], [4, 5, 6]]) arr2 = np...
10天前
4. 模型选择与构建
在本阶段,我们将根据业务需求和数据特征,选择最适合的数据分析或预测模型,并详细介绍所选算法的原理和适用性。模型将用于预测客户是否会流失(Exited),这一任务属于二元分类问题。 4.1 模...
9天前3.5 数据清洗与预处理
章节核心内容关键知识点1. 缺失值处理检测、删除和填充缺失值的方法isna(), dropna(), fillna(), 前向/后向填充, 均值/中位数填充2. 重复数据处理识别和删除重复行 duplicated(), drop_dup...
10天前
