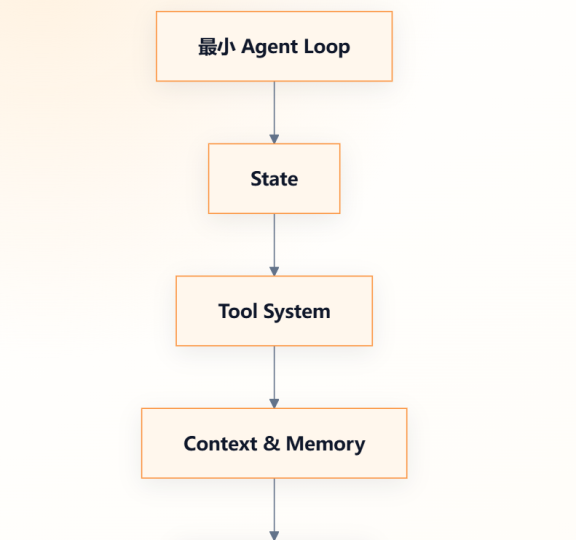


现在我们已经看到终点,也知道为什么要自己搭 Harness,接下来最容易出现的问题是,“这么多模块,是不是一下子要全部写完?”
完全不需要。
我们会用一个非常明确的“逐层加能力”的方式推进。
第一步:先让 Agent 会循环
最开始只有:
Goal
 ↓
Decision
 ↓
Action
 ↓
Observation
 ↓
Decision
这时我们只关注,为什么上一轮的执行结果能影响下一轮。
第二步:让它拥有 State
加入:
goal
step
messages
tool_history
status
这时 Agent 才真正成为一个“有过程”的系统。
第三步:让它长出 Tool
我们会实现:
read_file
write_file
edit_file
list_files
search_files
run_python
run_shell
同时建立 Tool Registry 和 Tool Schema。
模型不需要知道 Python 函数对象,只需要知道:
有哪些工具
每个工具解决什么问题
参数是什么
第四步:处理失败
真实世界不会每次成功。
比如:
read_file("app.py")
 ↓
FILE_NOT_FOUND
Agent 必须看到失败,并决定:
list_files()这就是 Error Recovery。
第五步:控制 Context
随着工具调用越来越多,上下文会越来越大:
用户消息
模型消息
Tool Result
文件内容
运行日志
错误栈
……
我们会学习:
Context Builder
Working Memory
Session
Context Compaction
Long-term Memory
第六步:Flask 服务化
把:
agent.run(...)变成:
POST /api/v1/runs再逐步加入:
Run
Session
Streaming
SQLite
第七步:让 Agent 不会“发疯”
这一阶段非常关键。
我们会明确:
MAX_STEPS
Timeout
Middleware
Human Approval
Workspace Boundary
Path Validation
让模型的自主能力始终处于 Harness 控制之下。
第八步:高级能力
等基础稳定以后,再加入:
Planner
SubAgent
Skills
AGENTS.md
这些能力不是为了“堆高级词”,而是解决更复杂项目里的真实问题。
第九步:AgentOps
最终必须知道,Agent 到底做过什么?
所以要记录:
Prompt
LLM Response
Tool Call
Tool Result
Latency
Token
Status
然后做:
Tracing
Metrics
Evaluation
最后,我们把这些能力全部汇入两个项目。
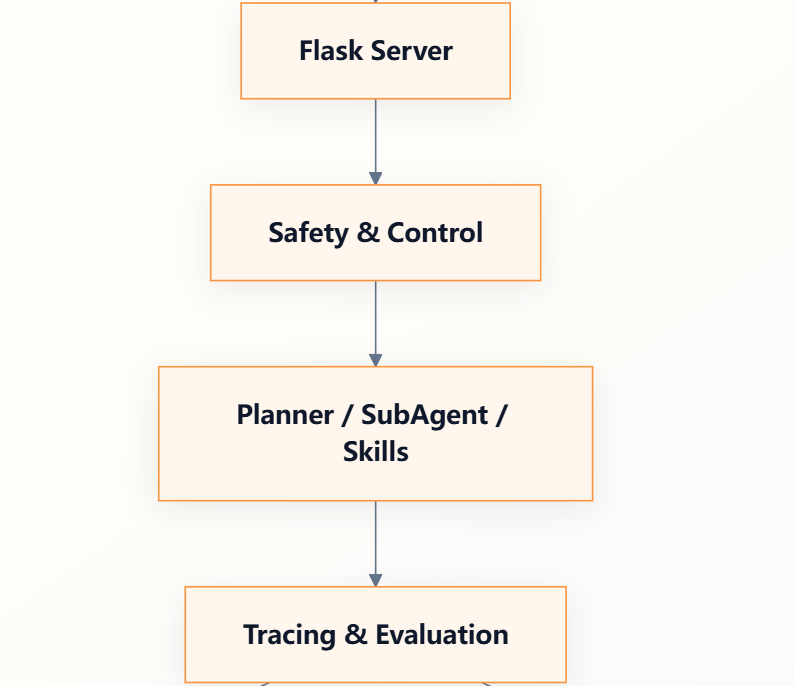
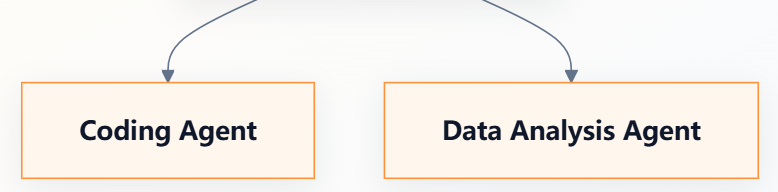
两个最终项目为什么选这两个?
Coding Agent 很适合验证:
- 文件工具;
- Shell;
- Python;
- Test;
- Error Recovery;
- Workspace;
- AGENTS.md;
- Human Approval;
- Trace。
Data Analysis Agent 很适合验证:
- SQL 工具;
- Schema;
- 多轮下钻;
- Context;
- Session;
- SQL Safety;
- Report;
- Evaluation。
一个偏“代码执行环境”,一个偏“数据分析决策”。
这两类任务放在一起,基本可以把整门课的核心能力全部跑一遍。
我们最终追求的不是“越自主越好”
这一点在开篇就要说清楚。
真正成熟的 Agent,不应该是,“你随便干,干完告诉我。”
而应该是:
模型负责动态决策
+
Harness 负责规则与边界
+
Workflow 负责确定性流程
+
Human 负责高风险确认这也是为什么后面我们会反复强调,确定的事情写死,不确定的事情交给 Agent。
这句话落到工程上,可以拆成四层职责:
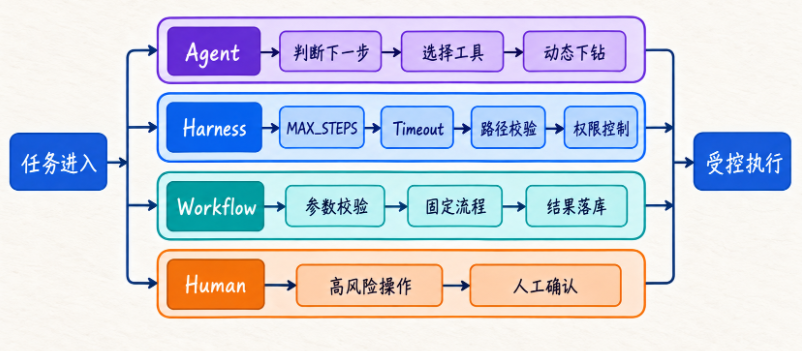
Agent 负责根据现场信息做动态判断;Harness 用最大步数、超时、路径和权限规则约束执行;Workflow 固定那些不能漂移的流程;高风险动作再交给 Human 确认。它们并不是四套互相竞争的方案,而是共同把“自主”限制在可接受的范围内。
这门课的目标不是让模型接管系统,而是教我们怎么把模型放在正确的位置。
除此之外,还有一个学习上的好处:每一节都能看到项目“长大一点”。学 Main Loop 时,它还只是一个循环;学 Tool 时,它第一次能操作文件;学 Context 时,它开始记得自己做过什么;学 Flask 时,它第一次能被外部调用;学 Tracing 时,我们能回看它完整的执行轨迹。这样的项目驱动方式,比把 30 个概念平铺讲完更容易形成整体认识。
从一次交付任务,看清我们要搭建的系统
我们先约定一个能检查结果的小任务:给定一个会报错的 Python 项目,系统找到相关文件,做出最小修改,再运行测试并交付结果。读者看见的虽然是一份报告,背后却有几条不同的工作线:模型提出下一步,工具改变或读取环境,Harness 记录过程并决定是否继续。后面的每一节,都可以回到这个任务上检查新组件究竟解决了什么问题。
学习前,我们需要能读懂 Python 函数、字典、异常和基本文件操作。遇到线程、HTTP 或数据库事务时,课程会在使用位置补解释;如果这些概念还不熟,可以先运行离线示例,观察输入输出,再回到实现。离线策略为了让结果容易复现,只覆盖有限任务;它通过测试,并不代表真实模型也能稳定完成陌生任务。
Flask 是这门课用来演示服务入口的选择。它接收请求、返回任务编号;需要长时间执行时,我们再引入 Worker、持久化状态和独立执行环境。大日志、修改结果等产物可以保存为 Artifact,便于核对。前面看到“可恢复”时也要留意:只有保存了足够状态、实现恢复入口并通过重启实验,才能确认恢复能力成立。
动手走一遍:先检查最终产物
你可以在复制出来的示例目录运行一次离线任务,保留修改前后文件、测试输出和报告。再问自己:哪一项能证明任务完成,哪一项只是过程说明?参考判断是,报告帮助我们理解结果,而测试与文件变化才是独立核对的证据。后面加入成本、审批和 Trace,都围绕这组证据继续推进。
我们可以把这几条工作线放回同一张图中,后续按章节逐步实现:
API → Run Queue / Worker → Sandbox + Harness → Checkpoint / Trace / Artifact Store
                     ↑             ↓
                  cancel        approval













请登录后查看评论内容