

学到这里,很容易出现一个新问题,“既然 State 什么都能放,那 Memory、Session、Trace 还有什么意义?”
这是非常好的问题。
如果这个边界没想清楚,后面项目会出现一个巨大对象:
state = {
    ...
    所有东西
}
最后没人敢改。
我们需要建立职责边界。
State:当前这一刻 Agent 的运行事实
State 更像“现在是什么情况”。
例如:
goal
step
status
current_tool_call
last_error
final_answer
这些字段会影响,Agent 下一步怎么运行。
Memory:需要跨轮次、甚至跨 Session 保留的知识
Memory 解决的不是“当前 Run 跑到第几步”。
而是,过去学到了什么,以后还要继续用。
例如:
用户偏好
项目长期规则
之前做出的决定
历史经验
后面 Long-term Memory 会详细讲。
Session:一段持续交互的会话容器
Session 可能包含多个 Run。
例如:
Session 001
 ├── Run 001:检查项目
 ├── Run 002:修改配置
 └── Run 003:再次测试
Session 更偏“用户交互上下文”。
State 则更偏“某个具体 Agent Run 当前执行状态”。
Trace:发生过什么的历史证据
Trace 主要用于:
审计
调试
复盘
指标统计
比如:
Step 1:调用 LLM,耗时 1.2 秒
Step 2:调用 read_file
Step 3:Tool 返回 404
Trace 不一定全部进入 State。
因为 Trace 可能很大。
我们通常只把会影响当前决策的摘要保留在 State,完整细节写到 Trace。
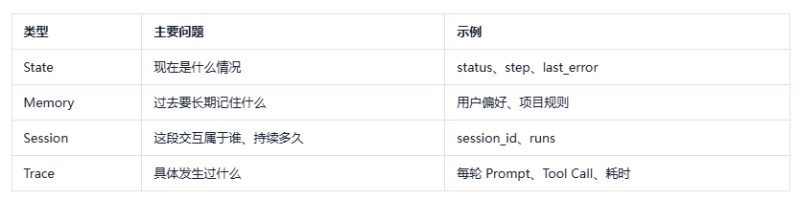
用一个简单表格区分
再用四张并排的卡片对照一次,各自回答的问题就更清楚了:State 说“现在怎样”,Memory 说“以后要记住什么”,Session 管理连续交互,Trace 留下可回看的细节。
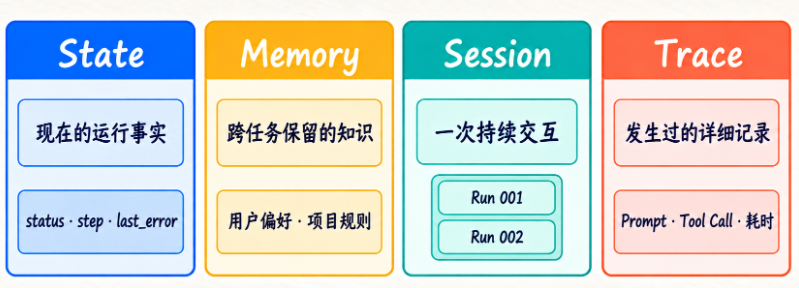
它们可以引用同一轮 Tool Call,但不需要把完整记录复制进同一个大字典。真正影响当前决策的摘要留在 State,逐步细节交给 Trace,更便于后面做持久化和调试。
State 设计的三个原则
第一,字段必须有明确用途。
不要因为“以后也许会用”就塞进去。
第二,能从其他字段稳定推导出来的,不一定重复保存。
比如如果:
step = len(tool_history)始终成立,就要考虑是否真的需要两个字段都维护。
但真实 Agent 一轮可能没有 Tool Call,所以 step 和 tool_history 长度不一定等价,这时两个字段都有意义。
第三,区分“运行事实”和“历史详情”。
完整 Prompt、完整 Token 统计、每次 HTTP Header 等,通常更适合 Trace,而不是当前 State。
状态不可变还是可变?
开篇阶段我们直接修改:
state.status = ...很自然。
生产系统里也有另一种思路,每次状态变化都产生一个新的 State Snapshot。
好处是:
- 更容易回放;
- 更容易调试;
- 更容易 Checkpoint;
- 更适合分布式系统。
但它会增加复杂度。
这门课前半段会先使用“可变 State”,因为更容易理解。
后面做 Run 持久化和 Trace 时,再讨论如何保存关键 Snapshot。
State 也是 Flask 服务化的桥梁
后面 Flask API 很可能返回:
{
  "run_id": "run_001",
  "status": "WAITING_APPROVAL",
  "step": 7
}
前端不需要知道整个 Agent 内部细节。
它只需要读 State 的一部分。
所以状态设计一旦清楚,服务层也会清楚。
这就是为什么这一节虽然还没真正讲 Flask,却已经在为 Flask 做准备。
把任务状态与当前步骤分开记录
假设 Agent 正在等待一次文件读取。此时 Run 仍处于 RUNNING,而当前步骤处于 TOOL_CALLING。这两种状态回答的问题不同:前者帮助 API 判断任务是否结束,后者帮助我们判断执行到了哪里。将 THINKING、OBSERVING 和 COMPLETED 都放进一个状态字段,后面做暂停、审批与并发查询时很容易产生歧义。
这里不妨把“整个任务”和“任务中的一小步”上下分层阅读:上层 Run 可能一直处于 RUNNING,下层 Step 却已在几轮 THINKING → TOOL_CALLING → OBSERVING 中来回切换。
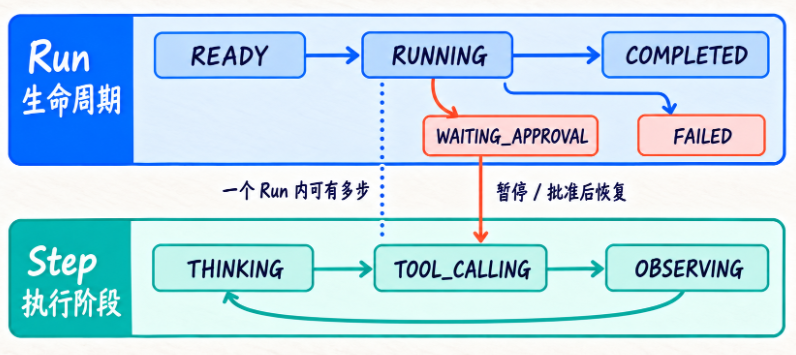
图里两个层级的状态并不是同一套枚举的重复写法。前者适合给 API 和用户看任务是否结束;后者适合定位当前动作正在模型、工具还是结果处理阶段。
我们可以让 Run 保存生命周期、取消请求、当前步骤编号和最终结果;每个 Step 则保存阶段、输入引用与输出引用。真正需要恢复时,还要知道哪些动作已经提交、哪些结果已经确认,以及哪个版本的状态是最新的。只有 step 和 message_count,无法重建丢失的消息,更无法判断外部写入是否发生。
状态转换最好通过明确入口完成。已经完成的 Run 不应因为收到一个迟到的取消请求而变成取消;等待审批的动作也不能因为再次启动循环就被当成普通工具直接执行。重复请求可以返回当前状态,非法转换则应该明确拒绝,并留下原因。
还要注意,保存了一份 State,不等于已经具备恢复能力。 如果快照里只有 step=7 和 status=WAITING_APPROVAL,我们只能知道任务停在了哪里,却未必知道等待批准的是哪个动作、动作是否已经执行、恢复后该从哪条消息继续。真正可恢复还需要调用参数、审批标识、消息或 Artifact 引用、幂等信息以及一致的持久化版本。
动手推演:重启之后还缺什么
你可以写下一份正在等待审批的状态,再假设内存全部丢失。检查它是否包含动作参数、审批标识、历史消息引用和工作区版本。参考判断是:能展示“之前在等待”只证明状态可查;能安全继续同一动作,才证明恢复资料足够。后面的持久化章节会继续补这条链路。














请登录后查看评论内容