

现在我们把前两节合起来。
上一节是 Loop。
这一节是 State。
真正的 Agent 结构应该是:
Loop 推进 State
State 约束 Loop
这句话很关键。
不是 Loop 单方面使用 State。
而是两者互相影响。
比如:
while state.status not in {
    AgentStatus.COMPLETED,
    AgentStatus.FAILED,
}:
    ...
此时 State 决定 Loop 是否继续。
而每一轮 Loop 又更新 State。
最小运行结构
先看:
while state.status not in terminal_statuses:

    state.status = THINKING

    response = llm.chat(state.messages)

    if response.tool_call:
        state.status = TOOL_CALLING
        ...
        state.status = OBSERVING
        ...
    else:
        state.status = COMPLETED
这已经比上一节的:
while True:更清晰。
一个完整可运行的示例
下面我们做一个模拟 Agent。
目标,查找项目入口文件。
from dataclasses import dataclass, field
from enum import Enum
from typing import Optional


class AgentStatus(str, Enum):
    READY = "READY"
    THINKING = "THINKING"
    TOOL_CALLING = "TOOL_CALLING"
    OBSERVING = "OBSERVING"
    WAITING_APPROVAL = "WAITING_APPROVAL"
    COMPLETED = "COMPLETED"
    FAILED = "FAILED"


@dataclass
class ToolCall:
    name: str
    arguments: dict


@dataclass
class LLMResponse:
    answer: Optional[str] = None
    tool_call: Optional[ToolCall] = None


@dataclass
class AgentState:
    goal: str
    messages: list[dict] = field(default_factory=list)
    step: int = 0
    tool_history: list[dict] = field(default_factory=list)
    status: AgentStatus = AgentStatus.READY
    final_answer: Optional[str] = None
    last_error: Optional[str] = None


FILES = {
    "src/main.py": "print('hello agent')",
    "README.md": "Entry: src/main.py",
}


def list_files() -> list[str]:
    return list(FILES.keys())


def read_file(path: str) -> str:
    if path not in FILES:
        raise FileNotFoundError(path)

    return FILES[path]


def execute_tool(call: ToolCall):
    if call.name == "list_files":
        return list_files()

    if call.name == "read_file":
        return read_file(
            call.arguments["path"]
        )

    raise ValueError(
        f"未知工具:{call.name}"
    )


def fake_llm(state: AgentState) -> LLMResponse:
    if len(state.tool_history) == 0:
        return LLMResponse(
            tool_call=ToolCall(
                name="read_file",
                arguments={
                    "path": "app.py"
                }
            )
        )

    if state.last_error == "app.py":
        return LLMResponse(
            tool_call=ToolCall(
                name="list_files",
                arguments={}
            )
        )

    if len(state.tool_history) == 2:
        return LLMResponse(
            tool_call=ToolCall(
                name="read_file",
                arguments={
                    "path": "src/main.py"
                }
            )
        )

    return LLMResponse(
        answer="已找到入口文件 src/main.py。"
    )


def run_agent(goal: str, max_steps: int = 10) -> AgentState:
    state = AgentState(
        goal=goal,
        messages=[
            {
                "role": "user",
                "content": goal,
            }
        ],
    )

    terminal_statuses = {
        AgentStatus.COMPLETED,
        AgentStatus.FAILED,
    }

    while state.status not in terminal_statuses:
        if state.step >= max_steps:
            state.status = AgentStatus.FAILED
            state.last_error = "MAX_STEPS_EXCEEDED"
            break

        state.status = AgentStatus.THINKING
        response = fake_llm(state)

        if response.tool_call is None:
            state.final_answer = response.answer
            state.status = AgentStatus.COMPLETED
            break

        state.status = AgentStatus.TOOL_CALLING

        call = response.tool_call
        state.tool_history.append({
            "tool": call.name,
            "arguments": call.arguments,
        })

        try:
            result = execute_tool(call)
            state.last_error = None

            observation = {
                "ok": True,
                "result": result,
            }

        except FileNotFoundError as exc:
            state.last_error = str(exc)

            observation = {
                "ok": False,
                "error_type": "FileNotFoundError",
                "error": str(exc),
            }

        except Exception as exc:
            state.last_error = str(exc)

            observation = {
                "ok": False,
                "error_type": type(exc).__name__,
                "error": str(exc),
            }

        state.status = AgentStatus.OBSERVING

        state.messages.append({
            "role": "assistant",
            "content": (
                f"TOOL_CALL: "
                f"{call.name} "
                f"{call.arguments}"
            ),
        })

        state.messages.append({
            "role": "tool",
            "content": str(observation),
        })

        state.step += 1

    return state


if __name__ == "__main__":
    final_state = run_agent(
        "找到这个项目的入口文件"
    )

    print("最终状态:", final_state.status)
    print("执行步数:", final_state.step)
    print("工具历史:", final_state.tool_history)
    print("最终答案:", final_state.final_answer)
    print("最后错误:", final_state.last_error)
这个例子已经非常接近真正 Agent Harness 的最小结构。
这里说“接近”,是因为它还把步骤阶段和 Run 生命周期放在同一个枚举里,也没有处理真实 Provider 的调用 ID、持久化和并发更新。先用这份代码观察 State 怎样变化,再看配套工程如何拆层,会比直接从完整模型倒推更容易抓住重点。
你会看到什么?
第一轮:
READY
 ↓
THINKING
 ↓
TOOL_CALLING
执行:
read_file("app.py")失败。
然后:
OBSERVING更新:
last_error = "app.py"第二轮:
THINKING模型读取 State 后知道上一步失败,于是:
list_files()第三轮再读取:
src/main.py最终:
COMPLETED这就是,Loop 在推进 State,State 又在影响下一轮 Loop。
把第一轮失败单独抽出来看,read_file('app.py') 报错后,程序并没有简单结束:错误被包装成 Observation,同时更新 messages、tool_history、last_error 与 step。
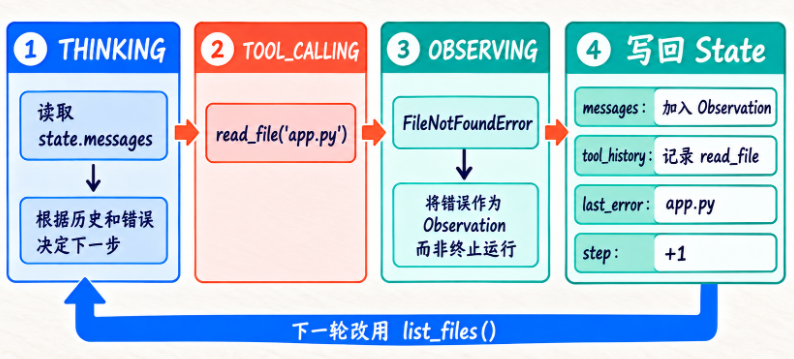
下一轮能够改用 list_files(),依赖的正是这些已经写回的事实。本节教学代码的 step 在工具结果写回后加一;配套 Engine 按模型决策轮数计步,比较日志时记得先统一口径。
为什么 last_error 值得进入 State?
因为错误可能改变下一步。
比如:
last_error = PermissionDenied与:
last_error = FileNotFoundError代表完全不同的处理方式。
前者可能要停止。
后者可能可以恢复。
所以“最近一次关键错误”是典型的运行状态。
final_answer 为什么也放 State?
因为后面 Flask API 很可能不是直接返回字符串,而是拿整个 Run State:
state = run_agent(...)

return {
    "status": state.status,
    "answer": state.final_answer,
    "steps": state.step,
}
这种结构比:
return answer更适合服务化。
State 让调试变得容易
没有 State 时,你看到:
Agent 好像不对很难判断。
有 State 后可以直接打印:
goal
step
status
last_error
tool_history
甚至把整个 State 保存下来。
这就是后面 Checkpoint、Run、Tracing 的基础。
配套实现可以从两个文件对照着看:src/agent_harness/core/models.py 定义 AgentState 与 RunStatus,src/agent_harness/core/engine.py 在 Main Loop 中更新 step、status、messages、tool_history 和 checkpoint。运行上一节的阶段项目时,最后打印出来的 tool_history,就是 State 在真实循环中被更新后的结果:
cd agent_harness_course_projects
python3 projects/01_main_loop/main.py
这次不只看答案 42,还可以顺着历史记录检查三个问题:调用的工具名是否为 double,参数是否为 21,结果是否为 42。最终答案说明任务结束了,State 中的历史才说明它是怎样结束的。














请登录后查看评论内容