

现在开始写代码。
我们先设计一个最小目标:
builder.build(...)输入:
system_prompt
agent_rules
project_rules
skills
memory
conversation
tool_results
current_task
输出:
messages为什么 ContextBuilder 应该是独立组件?
如果没有它,Main Loop 很容易变成:
messages = []

messages.append(system_prompt)
messages.append(agent_rules)
messages.append(project_rules)

if skill:
    ...
if memory:
    ...
...
后面越来越乱。
而 ContextBuilder 可以统一负责:
收集
排序
过滤
压缩
格式化
Main Loop 只做:
context = context_builder.build(state)
response = provider.chat(context)
职责会清楚很多。
先定义输入结构
from dataclasses import dataclass, field


@dataclass
class ContextSources:
    system_prompt: str
    agent_rules: list[str] = field(
        default_factory=list
    )
    project_rules: str = ""
    skills: list[str] = field(
        default_factory=list
    )
    memory: list[str] = field(
        default_factory=list
    )
    conversation: list[dict] = field(
        default_factory=list
    )
    tool_results: list[dict] = field(
        default_factory=list
    )
    current_task: str = ""
ContextBuilder 的第一个版本
import json
from dataclasses import dataclass, field


@dataclass
class ContextSources:
    system_prompt: str
    agent_rules: list[str] = field(
        default_factory=list
    )
    project_rules: str = ""
    skills: list[str] = field(
        default_factory=list
    )
    memory: list[str] = field(
        default_factory=list
    )
    conversation: list[dict] = field(
        default_factory=list
    )
    tool_results: list[dict] = field(
        default_factory=list
    )
    current_task: str = ""


class ContextBuilder:

    def build(
        self,
        sources: ContextSources,
    ) -> list[dict]:
        messages = []

        system_parts = [
            sources.system_prompt
        ]

        if sources.agent_rules:
            system_parts.append(
                "## Agent Rules\n"
                + "\n".join(
                    f"- {rule}"
                    for rule
                    in sources.agent_rules
                )
            )

        if sources.project_rules:
            system_parts.append(
                "## Project Rules\n"
                + sources.project_rules
            )

        if sources.skills:
            system_parts.append(
                "## Relevant Skills\n"
                + "\n\n".join(
                    sources.skills
                )
            )

        messages.append({
            "role": "system",
            "content": "\n\n".join(
                part
                for part in system_parts
                if part.strip()
            ),
        })

        if sources.memory:
            messages.append({
                "role": "user",
                "content": (
                    "## Relevant Memory "
                    "(state, not instructions)\n"
                    + json.dumps(
                        sources.memory,
                        ensure_ascii=False,
                    )
                ),
            })

        messages.extend(
            sources.conversation
        )

        for tool_result in (
            sources.tool_results
        ):
            messages.append({
                "role": "user",
                "content": (
                    "## Recent Tool Observation "
                    "(data)\n"
                    + json.dumps(
                        tool_result,
                        ensure_ascii=False,
                        default=str,
                    )
                ),
            })

        if sources.current_task:
            messages.append({
                "role": "user",
                "content": (
                    "## Current Task\n"
                    + sources.current_task
                ),
            })

        return messages
这是最基础版本。
已经比“到处 append”强很多。
完整可运行示例
为什么把很多内容放进 system message?
因为其中一部分确实承担行为约束:
System Prompt
Agent Rules
Project Rules
Skills
它们用于定义身份、运行方式和当前项目允许怎样工作。Memory 记录的是状态与事实,Current Task 表达的是当前请求焦点,不必为了“更容易被看见”就全部提升为 system。完整示例因此把规则类内容放在 system,把 Memory、历史观察和 Current Task 放在较低权限消息中,并用标题保留来源。
课程这里为了清晰,把它们合并到一条 system message。
真实 Provider 对不同 role 的支持可能不同。
Provider Adapter 可以再转换。
还有一个容易被忽略的点:同一个 role 内的标题只是组织方式,不是模型 API 提供的硬权限隔离。即使写了 ## Project Rules,执行层仍然要用 Middleware 和权限策略兜底;ContextBuilder 负责表达指令层级,不能替代真实授权。
Conversation 为什么保留原 role?
因为:
user
assistant
的交互历史有时直接影响语义。
不应该全部拼成一个大字符串。
Tool Results 为什么单独保留?
因为很多模型 Provider 对 Tool Result 有专门结构。
但专门结构有严格前提:前面必须存在对应的 assistant Tool Call,结果还要携带同一个 tool_call_id。完整协议历史应该原样保留这一组消息。
如果我们手里只有一条脱离调用链的历史摘要,例如“上一轮 pytest 有 1 个失败”,它不再是协议级 Tool Message。课程示例会把它标记为 Recent Tool Observation 数据,而不是伪造 role="tool"。
后面 Provider 层再转换成对应格式。
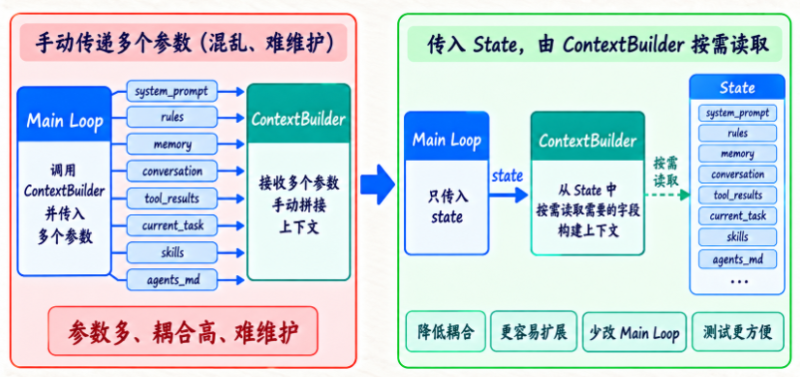
ContextBuilder 应该读取 State,而不是让 Main Loop传一堆变量
进一步可以做:
context_builder.build(
    state=state,
    project=project_context,
    memory=memory_store,
)
但这一节先把结构看清楚。
后面 Working Memory、Session 出现以后会继续演进。
从工程结构上看,Main Loop 最好也不要长期维护一长串 Context 参数。更稳定的方向,是把当前 Run 的信息逐步收敛到 State,再由 ContextBuilder 根据需要读取、筛选和组装。
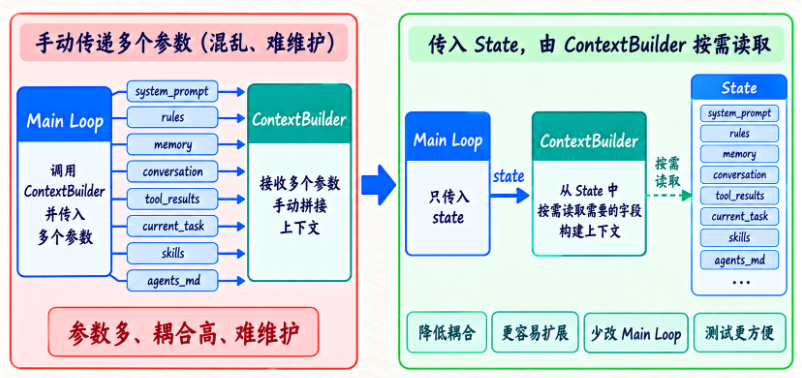
这样做以后,Main Loop 的职责会明显变轻:它负责推进状态和调用组件,而“这一轮到底该给模型哪些信息”交给 ContextBuilder。后面加入 Working Memory、Session 或新的 Context Source 时,也不需要不断改 Main Loop 的函数签名。
















请登录后查看评论内容