

现在最危险的误区来了,“既然模型需要上下文,那我把所有东西都塞进去就好了。”
这是很多 Agent 越跑越差的原因。
问题一:重复信息会增加噪声
例如:
System Prompt:
不要修改 tests/

AGENTS.md:
禁止修改 tests/

Memory:
用户之前说不要改 tests/

Conversation:
用户再次强调不要改 tests/
这四份信息原则一致,不算坏事。
但如果类似规则有 50 条重复,就会浪费 Context。
ContextBuilder 可以做简单去重。
问题二:冲突信息必须有优先级
例如:
System Rule:
禁止执行危险 Shell

AGENTS.md:
可以执行任意 Shell

User:
请 rm -rf workspace
到底听谁?
必须有明确优先级。
一个简单内部优先级可以是:
System / Safety
>
Agent Rules
>
Project Rules
>
User Task
>
Tool Result / File Content
尤其要注意,Tool Result 和文件内容只是“数据”。
它们不能覆盖高层规则。
这是防 Prompt Injection 的基础思想之一。
把优先级画出来以后,冲突处理会更直观:高层规则负责约束行为边界,低层的对话、文件内容和 Tool Result 即使更新、更相关,也不能因此获得更高的指令权。
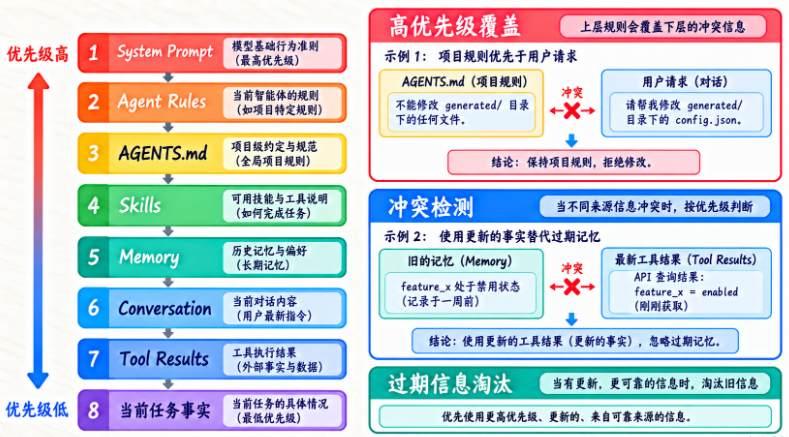
所以真正判断冲突时,不要只看“谁最后出现”或“谁更相关”,还要同时看来源权威、作用域、时效性和当前任务。尤其外部数据可以提供事实,却不能反过来改写 System / Safety / Agent Rules。
真正处理冲突时,不能只看“谁排在后面”或一个 priority=90。我们至少要同时看四个维度:来源具有什么指令权威、规则覆盖哪个作用域、信息是否仍然有效、内容与当前任务是否相关。相关性高不等于权限高——一段刚抓到的网页内容可能非常相关,但仍然只是外部数据;一条项目规则即使更具体,也不能覆盖更高层的安全边界。
可以把内部 Section 扩展为:
content
source
authority
scope
updated_at
priority
required
这样“为什么选中、为什么被覆盖、为什么过期”才有机会被 Build Report 解释清楚。
问题三:过期信息会误导模型
例如前面 Agent 发现:
入口是 app.py后来用户已经改项目,入口变成:
src/main.py如果 Memory 里还保留旧事实:
入口 app.py模型就可能走错。
所以 Memory 需要:
更新时间
可信度
来源
这一节先建立意识。
后面 Long-term Memory 再专门设计。
问题四:Tool Result 特别容易过长
例如:
pytest一次输出 3000 行。
我们其实只需要:
失败测试
关键 traceback
summary
所以 ContextBuilder 可以在加入 Tool Result 前做:
truncate
summarize
select
一个简单截断器
def truncate_text(
    text: str,
    max_chars: int = 4000,
) -> str:
    if len(text) <= max_chars:
        return text

    return (
        text[:max_chars]
        + "\n...[truncated]"
    )
虽然简单,但非常实用。
问题五:Skill 不应该全量加载
假设你有 20 个 Skill。
每个 2000 字。
全塞进去就是:
40000 字而当前只是修 Flask。
真正应该:
Task
 ↓
Skill Selector
 ↓
只加载相关 Skills
这就是“动态上下文”。
“按需加载”不只适用于 Skills。真实 Agent 里,Memory、Conversation 和 Tool Results 都可能越来越多,真正应该进入本轮 Context 的只是与当前任务最相关的那一部分。
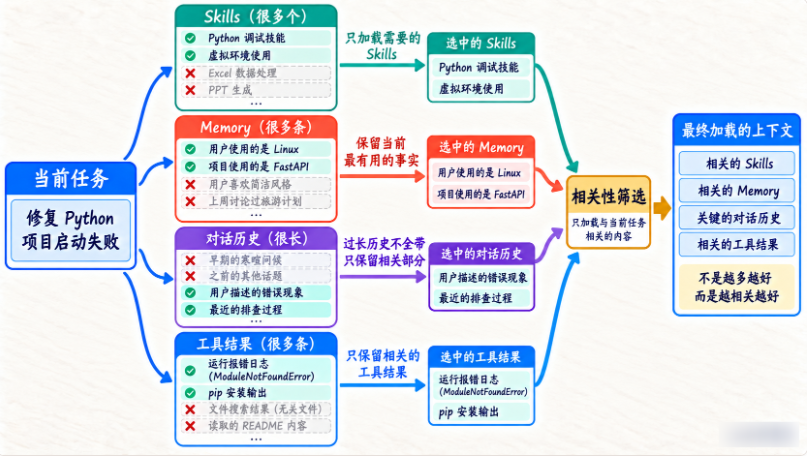
因此 ContextBuilder 更像一个筛选器,而不是搬运工。它要做的是把最相关、最新、可信且当前有用 的信息留下,而不是证明自己“收集得足够多”。
给 ContextBuilder 增加预算
我们可以先用字符预算模拟。
真实系统更适合 Token Budget。
预算也不能把模型窗口全部分给输入。假设窗口上限是 32k Token,我们还要为模型输出、Tool Call 参数和安全余量预留空间。更准确的关系是:
可用输入预算
= 模型窗口
- 预留输出
- 协议开销
- 安全余量
字符数适合教学和快速保护,但中文、英文、代码的 Token 比例不同。上线前应使用目标模型对应的 Token 估算方式,并记录“估算值”和“Provider 实际 usage”的偏差。
预算这件事如果只看一个 max_chars 很容易过于抽象。更实际的做法,是先给高优先级规则和当前任务留出稳定空间,再控制 Conversation、Skills 与 Tool Results 的占用;其中 Tool Result 往往最容易突然膨胀。
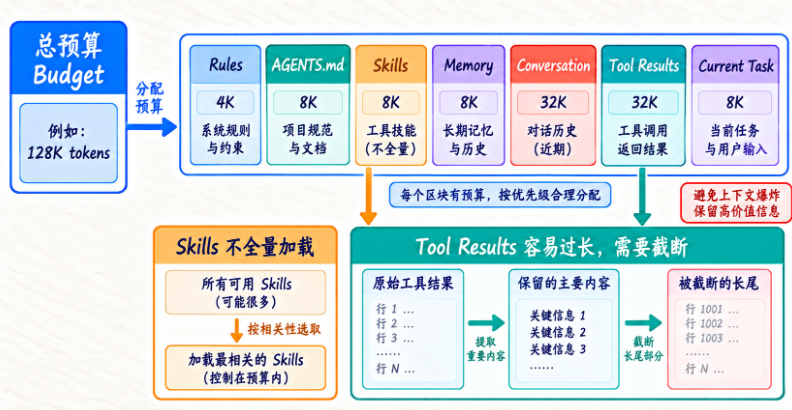
这张图也说明了为什么“截断”不是简单从末尾砍字符:更合理的是先保留关键 traceback、summary、错误位置等高价值信息,再丢掉重复日志和长尾输出。
class ContextBudget:

    def __init__(
        self,
        max_chars: int,
    ):
        self.max_chars = (
            max_chars
        )

    def fit(
        self,
        sections: list[str],
    ) -> list[str]:
        result = []
        used = 0

        for section in sections:
            remaining = (
                self.max_chars
                - used
            )

            if remaining <= 0:
                break

            if (
                len(section)
                <= remaining
            ):
                result.append(
                    section
                )
                used += len(
                    section
                )
            else:
                result.append(
                    section[
                        :remaining
                    ]
                )
                break

        return result
但这段有一个问题,前面的内容永远优先。
所以更成熟应该先按优先级排序。
ContextSection 设计
from dataclasses import dataclass


@dataclass
class ContextSection:
    name: str
    content: str
    priority: int
    required: bool = False
例如:
System
priority=100
required=True

Agent Rules
priority=90
required=True

Project Rules
priority=80

Skills
priority=60

Memory
priority=50

Old Conversation
priority=20
ContextBuilder 先保证 required,再按优先级填预算。
这里的 required 表示“这一轮不能缺”,不表示“允许无限增长”。如果必需规则本身已经超过上下文预算,更稳的处理是构建失败并暴露配置问题,或者换用经过审核的短版本;直接从中间切断一条安全规则,可能让剩下半句话表达出完全不同的意思。
一个可运行预算版本
这里的重点不是字符预算算法多先进。
而是你已经开始把 Context 当作,有限资源。
这就是 Context Engineering 的核心意识。
















请登录后查看评论内容