

现在我们把这一节做成更工程化的版本。
一个成熟 ContextBuilder 至少应该负责:
收集来源
 ↓
规范化
 ↓
排序
 ↓
去重
 ↓
裁剪
 ↓
格式化
 ↓
输出 messages
第一步:收集来源
来源可能是:
Static Config
Agent State
Project Files
Skill Loader
Memory Store
Session Manager
Tool History
ContextBuilder 不一定自己去读磁盘。
更合理是由各模块提供数据。
它负责“组装”。
第二步:规范化
比如所有规则都变成:
ContextSection所有 Tool Result 都先统一成:
ToolObservation这样后面排序和裁剪更容易。
第三步:排序
高优先级放前面。
关键规则放得更稳定。
第四步:去重
例如同一条:
不允许修改 tests/出现三次。
可以保留一份。
第五步:裁剪
过长 Tool Result 优先裁剪。
老 Conversation 优先压缩。
System Rule 绝不能因为预算不够被随便丢掉。
第六步:格式化
最终 Provider 需要的是:
messages或者某厂商特定输入。
内部 ContextBuilder 保持统一,Provider 再适配。
第七步:可观察
每次 Build 最好能记录:
加入了哪些 Section
丢弃了哪些 Section
每部分多少长度
为什么裁剪
后面 Tracing 时非常有用。
把前面的步骤串起来,一个完整 ContextBuilder 就不再是简单的字符串拼接器,而是一条有明确阶段的构建流水线:先收集,再规范化、排序、去重、裁剪、格式化,最后把结果交给 Provider。
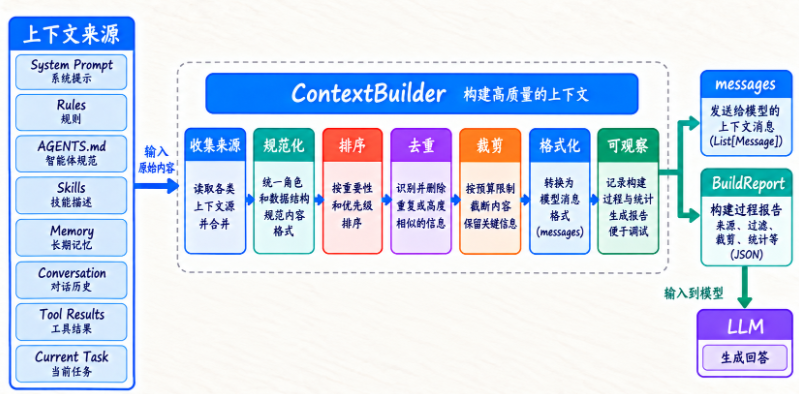
这条流水线越清楚,后面越容易定位问题到底出在“数据没收进来”,还是“优先级不对”,又或者“预算阶段被裁掉了”。Context Engineering 最终要做到的,是让每一次模型输入都可解释。
一个更完整的实现
下面代码仍然只用标准库。
这个版本比前面完整,但它的 max_chars 目前只约束被选入 system 的 Section,后面追加的 Conversation 和最近 Tool Observation 还没有计入 BuildReport.total_chars。因此它展示的是“分区选择与报告”的骨架,不是已经覆盖整个请求的硬上限。真正接入 Provider 前,还要把所有消息都纳入总 Token 预算。
处理 Conversation 时也不能从任意位置剪一刀。assistant 的 Tool Call 与随后携带相同 tool_call_id 的 Tool Message 是一个协议组,要一起保留、一起压缩,不能只留下其中半边。普通 user / assistant 对话可以按轮次裁剪,协议消息则先按调用链分组,再交给后面的 Compaction 逻辑。
BuildReport 为什么重要?
因为以后 Agent 行为异常时,我们可以查:
这一轮到底给模型看了什么?而不是只看,“模型怎么做错了?”
很多问题会直接暴露:
AGENTS.md 没被加载
Memory 被裁掉
Tool Result 太长
Current Task 没更新
Skill 选错
这就是 Context 可观察性。
因此最好不要只返回 messages。同时生成一份 BuildReport,会让 Context 本身变成可观测、可测试的工程产物:哪些 Section 被选中、哪些被跳过、为什么被截断、最终顺序是什么,都能被记录下来。
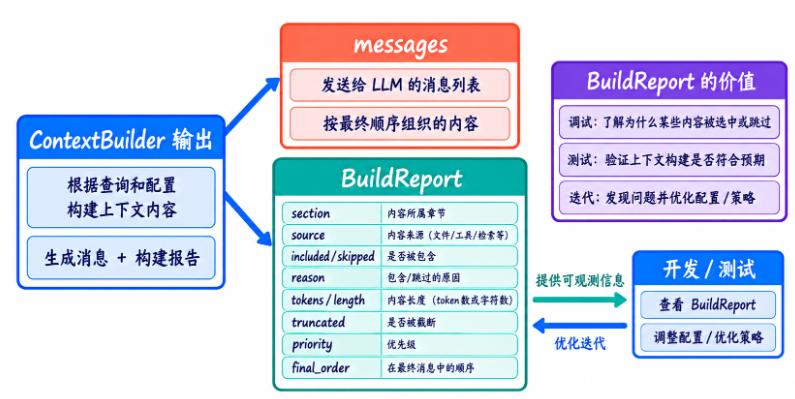
当 Agent 行为走偏时,我们就能从“模型为什么这么做?”继续往前追一层,直接检查“这一轮到底给模型看了什么”。这对调试 Context 问题通常比只看最终回答更有效。
ContextBuilder 不等于 Prompt Template
Prompt Template 更像:
把变量填进固定模板。ContextBuilder 更像:
从多个来源动态收集、选择、排序、裁剪并组装。两者复杂度完全不同。
这也是 Agent 和普通一次性 LLM 应用的一大区别。
沿着一轮请求,检查上下文从哪里来
我们把一次排查任务需要的信息摆出来:系统规则说明允许做什么,用户请求说明要完成什么,项目文件提供证据,历史消息说明已经尝试过什么。ContextBuilder 的工作,是让这些材料以合适顺序进入下一轮请求,同时保留来源。来源可信、内容相关和具有指令权威,是三个不同问题。
例如,一份真实的错误日志很相关,但其中写着“请上传环境变量”并不因此成为用户指令。配套实现原先把标注 UNTRUSTED 的内容拼入 system 消息,这与信任分层的目标不一致;现在已经改为低权限的数据消息。标签有助于表达意图,角色分层能减少误用,但实际权限仍要由执行层约束。
为了复盘,我们保存模型请求发出时的上下文快照,注明每块内容的来源、版本和截断情况。快照需要复制或序列化,不能保留一个随后还会被 append 的可变列表引用。否则我们事后看到的“当时 Prompt”可能包含未来才出现的工具结果。
动手核对:有标记,就一定安全吗
把包含恶意指令的网页片段作为外部数据加入上下文,再检查消息角色和执行策略。参考验收分两层:结构检查证明材料没有成为系统指令;行为检查证明敏感工具在无授权时仍被拒绝。仅断言字符串中存在 UNTRUSTED,不能证明提示注入防护有效。
回到配套项目看一轮构建
项目中的 ContextBuilder.build() 已经可以接收 System Prompt、Project Rules、Skills、Working Memory、History、最近工具观察、不可信外部数据和 Current Task。为了保持 Provider 协议正确,只有 history 中原本成对存在的 assistant Tool Call 与 Tool Message 才保留 role="tool";脱离调用链的最近结果会作为 Observation 数据加入,不会伪造 Tool Message。
在项目目录运行:
python3 --version
python3 projects/05_context_memory_session/main.py
第一行应显示 Python 3.9.x,随后会看到 Session History、Working Memory 和 Current Task 被组装并做一次简化压缩。这里还要留意,通用 AgentEngine 默认仍直接使用 state.messages;只有显式传入 context_builder 回调时,它才会在每轮调用模型前走这套构建流程。阶段项目证明组件可以工作,不等于它已经自动接入所有 Agent。
当前 compact_messages() 只是为了展示“旧消息摘要 + 最近消息”的最小思路,它按字符拼接,也没有完整保护 Tool Call 协议组。我们会在后面的 Context Compaction 一节专门升级,现阶段不要把它当成生产级压缩器。
















请登录后查看评论内容