

先从最基础字段开始。
用户给出的结构是:
session_id
   ↓
messages
   ↓
working_memory
   ↓
tool_history
   ↓
runs
这五个字段已经非常接近真正可用的 Session。
session_id
这是最核心的索引。
可以理解为,“这段会话的身份证”。
例如:
sess_b7741d所有后续请求只要带这个 ID,系统就能恢复对应 Session。
为什么不用用户 ID 直接当 Session ID?
因为一个用户可以同时有多个会话。
例如:
Session A:
Coding Agent 修 Bug

Session B:
Data Analysis Agent 查收入下降

Session C:
另一个项目
所以:
user_id和:
session_id通常是两个概念。
还要多记一句:session_id 只是定位符,不是登录凭证。随机 ID 可以降低被猜中的概率,却不能代替身份校验。服务端每次读取和写入时仍要检查,这个 Session 是否属于当前用户或当前租户。
这一点可以和 user_id 一起看。一个用户可以同时拥有很多 Session,所以 user_id 表示“谁”,session_id 表示“哪一段会话”;真正访问数据时,还要再做一次归属校验。
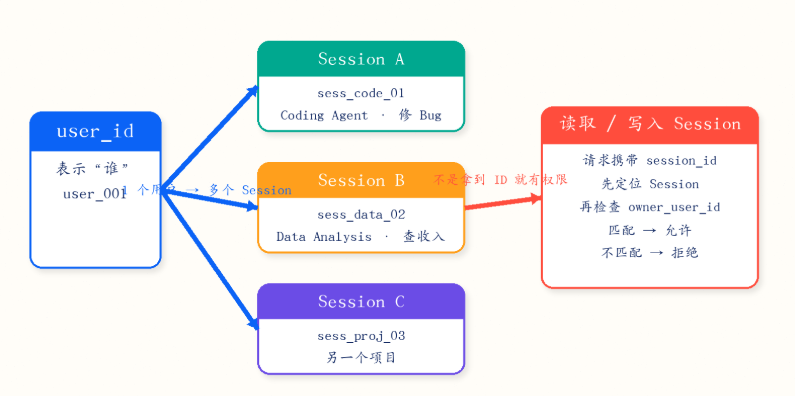
图里右侧这一步经常被忽略:能根据 session_id 找到数据,不代表当前请求就有权读取或修改它。 随机 ID 只是降低猜测概率,真正的安全边界仍然是服务端的用户/租户归属检查。
messages
记录多轮对话。
例如:
[
    {
        "role": "user",
        "content": "修复启动失败"
    },
    {
        "role": "assistant",
        "content": "我先检查项目结构"
    }
]
注意,messages 是 Conversation History,不是完整 Agent State。
前面已经讲过,Working Memory 仍然需要独立存在。
消息本身也不应该只有 role 和 content 两个字段。到了持久化与流式输出阶段,我们通常还会需要 message_id、created_at、递增序号以及关联的 run_id。时间戳可以用于展示,真正决定顺序时更适合依赖单调递增的序号;多条消息恰好落在同一时间时,只按时间排序容易出现顺序漂移。
API 入口还要替调用方决定 role。客户端可以提交消息内容,但不应该随意声明“这是一条 system 消息”;否则普通用户输入就可能越过原有指令层级。Session Store 可以保存合法角色,角色的来源和权限仍应由服务端控制。
working_memory
保存当前会话或当前任务的短期认知。
例如:
Goal
Plan
Completed
Errors
Important Files
Next Action
这里有一个值得讨论的问题,如果一个 Session 有多个 Run,Working Memory 到底属于 Session 还是 Run?
实际项目有两种设计。
简单版:
Session 只有一个当前任务
→ Working Memory 直接放 Session
复杂版:
Session 可以同时有多个任务
→ Working Memory 更应该属于 Run
本课程现在采用第一种简化设计,Session 保存当前 Working Memory。
等后面正式实现 Run 时,再把“Run 级状态”和“Session 级状态”进一步区分。
tool_history
Tool History 保存:
Tool Name
Arguments
Result
Status
Timestamp
例如:
{
    "tool": "read_file",
    "arguments": {
        "path": "app.py"
    },
    "ok": True
}
它的价值有三个。
第一,帮助重复 Tool Call 检测。
第二,帮助恢复 Session 后知道之前执行过什么。
第三,后续 Tracing / Audit 可以关联。
runs
一个 Session 可以有多次 Run。
例如:
run_001
run_002
run_003
现在先简单保存:
runs: list[str]后面 Run 章节再扩展成完整 Run 对象。
Session 还需要哪些字段?
真实项目通常还会有:
status
created_at
updated_at
closed_at
metadata
user_id
例如:
status:
ACTIVE
CLOSED
EXPIRED
为什么有状态?
因为,读取一个 Session 和“允许继续写入它”不是同一回事。
关闭后的 Session 可以读历史,但默认不再接受新任务。
一个最小 Session 数据类
from dataclasses import dataclass, field
from datetime import datetime, timezone
from typing import Any, Optional


def utc_now() -> str:
    return datetime.now(
        timezone.utc
    ).isoformat()


@dataclass
class WorkingMemory:
    goal: str = ""
    plan: list[str] = field(
        default_factory=list
    )
    completed: list[str] = field(
        default_factory=list
    )
    errors: list[str] = field(
        default_factory=list
    )
    important_files: list[str] = field(
        default_factory=list
    )
    next_action: str = ""


@dataclass
class Session:
    session_id: str
    messages: list[dict] = field(
        default_factory=list
    )
    working_memory: WorkingMemory = field(
        default_factory=WorkingMemory
    )
    tool_history: list[dict] = field(
        default_factory=list
    )
    runs: list[str] = field(
        default_factory=list
    )
    status: str = "ACTIVE"
    created_at: str = field(
        default_factory=utc_now
    )
    updated_at: str = field(
        default_factory=utc_now
    )
    metadata: dict[str, Any] = field(
        default_factory=dict
    )
    version: int = 0


if __name__ == "__main__":
    session = Session(
        session_id="sess_demo"
    )

    session.messages.append({
        "role": "user",
        "content": "修复启动失败",
    })

    session.working_memory.goal = (
        "修复启动失败"
    )

    print(session)
这个对象已经把前几节的多个概念真正组织到一起了。
为什么 updated_at 很重要?
后面你会需要:
列出最近 Session
找出 30 天未使用 Session
自动过期
恢复最近一次会话
都依赖更新时间。
所以每次修改 Session,都应该:
touch updated_atSession 是状态容器,不是执行器
这点也要明确。
Session 自己不应该负责:
调用 LLM
执行 Tool
跑 Main Loop
这些属于:
Agent Engine
Tool Executor
Session 只负责,保存这段会话目前有哪些状态。
职责越清楚,后面越容易服务化。
















请登录后查看评论内容