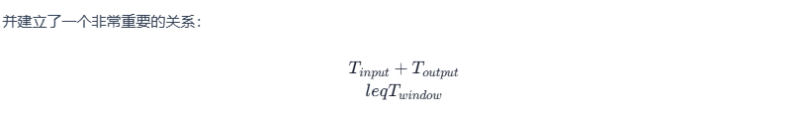


题目 1:Context Window、Input Token、Output Token 三者是什么关系?
请用一个“总窗口 100K、Input 80K、希望输出 10K”的例子解释为什么不能只看 Input 有没有超过 100K。
Context Window 可以理解为模型一次调用可使用的总预算。Input Token 是当前请求中 System Prompt、Conversation、Tool Result、Working Memory、Tool Schema 等输入占用,Output Token 是模型本轮生成内容占用。若总窗口为 100K,Input 已经 80K,再预留 10K Output,总占用约 90K,仍在范围内;如果 Input 98K 还要求 10K Output,就会超过整体预算。因此工程上必须给输出预留空间,而不是只比较 Input 和窗口大小。
题目 2:判断题——用户只问了一句话,所以 Agent 不可能产生很大的 Context,对吗?
请结合 Tool Calling 解释。
不对。用户只问一句“帮我修 Bug”,Agent 内部可能运行几十个 Step,每一步新增模型输出、Tool Call、Tool Result、代码文件、测试日志和错误栈。用户消息可能只有几十 Token,但内部环境反馈可以增长到几万甚至更多 Token。因此 Agent Context 的主要增长常常来自内部执行过程,而不是用户消息本身。
题目 3:为什么 Agent 比普通 Chatbot 更容易撑爆 Context?
请至少从 Tool Result、Step 数、代码日志、Working Memory / Tool Schema 四个角度说明。
普通 Chatbot 主要积累 User 与 Assistant 消息,而 Agent 每个用户任务内部可能有很多 Step,每一步都可能增加 Tool Call 和 Tool Result。Coding Agent 还会读取代码、测试日志、异常栈,Data Analysis Agent 会产生 SQL 结果。除此之外,Agent 每轮通常还要带 Working Memory、Project Rules、Skills 和 Tool Schema。因此它既有更多固定上下文,又有更多动态环境反馈,增长速度明显高于普通聊天。
题目 4:编程实现——实现一个 ContextUsage 监控类
要求输入 input_tokens、reserved_output_tokens、context_window,计算使用率,并按照 <60%、60%-80%、80%-90%、>=90% 返回状态。
from dataclasses import dataclass


@dataclass
class ContextUsage:
    input_tokens: int
    reserved_output_tokens: int
    context_window: int

    @property
    def ratio(self) -> float:
        total = (
            self.input_tokens
            + self.reserved_output_tokens
        )

        return (
            total
            / self.context_window
        )

    @property
    def level(self) -> str:
        value = self.ratio

        if value < 0.60:
            return "NORMAL"

        if value < 0.80:
            return "WATCH"

        if value < 0.90:
            return "COMPACT_SOON"

        return "CRITICAL"


if __name__ == "__main__":
    usage = ContextUsage(
        input_tokens=82000,
        reserved_output_tokens=6000,
        context_window=100000,
    )

    print(
        usage.ratio
    )

    print(
        usage.level
    )
题目 5:综合应用——为什么只保留最近 N 条消息可能导致严重问题?
请用“禁止修改 tests/”的项目规则举例,并说明更合理的保存方式。
如果用户或项目在第1轮明确要求“禁止修改 tests/”,但 Agent 运行到第30轮时系统只保留最近20条消息,这条关键规则可能被截掉,模型随后就可能直接修改测试文件。更合理的方式是把这种高优先级约束提升到 System Rule、Agent Rule 或 Project Rule,每轮稳定注入;Conversation 只负责最近交互。这样历史可以裁剪,但关键规则不会丢失。
题目 6:Tool Result 很大时,为什么不应该“直接删除原始数据”?
请说明 Context、Trace、Session Store 三者的关系。
Context 只代表当前这一轮真正发送给模型的内容,不等于系统全部存储。大日志或完整 SQL 结果可以不再进入当前 Context,但仍然保存在 Trace、Session Store 或外部文件中,后续如果需要可以再次读取。这样既控制 Token,又保留可审计证据。真正应该减少的是“重复发送给模型的内容”,而不是永久删除所有原始数据。
题目 7:概念理解——为什么 Context Window 大不等于可以无限塞内容?
请从成本、延迟、相关性和模型行为稳定性四个方面解释。
更大的 Context Window 只是提高硬上限,并不会消除每轮 Input Token 带来的成本和传输延迟。上下文越长,里面的重复、过期和无关内容越多,模型越难稳定聚焦 Current Task,也更容易被旧错误、旧计划和大段日志干扰。因此即使模型支持非常大的窗口,真实 Agent 仍然需要 Working Memory、Relevant Context Selection、Tool Result Truncation 和后续 Compaction。
题目 8:指标判断——current_input_tokens 和 run_total_tokens 分别回答什么问题?
假设一个 Run 已经调用模型 10 次,每次实际使用 8K Token,当前第 11 次请求预计 Input 为 13K、预留 Output 为 2K,模型窗口为 16K。请分别判断累计成本和当前请求是否超限。
前 10 次调用的累计用量约为 80K,它用于成本和整段任务效率分析,不直接与 16K 单次窗口比较。第 11 次预计使用 13K + 2K = 15K,暂未超过 16K;但只剩 1K 余量,若还没有预留估算误差和协议开销,就已经很接近危险区。Harness 应看当前请求的使用率决定是否压缩,同时把完成后的实际 usage 继续累加到 Run 指标。
进一步阅读
- LLM Tokenization 相关资料:理解不同文本、代码和语言为什么会产生不同 Token 数。
- Context Window 相关资料:重点理解模型上下文容量、输入与输出预算之间的关系。
- Prompt / Context Budgeting:学习如何给不同上下文来源分配预算。
- Summarization 与 Context Compaction:下一节会正式实现压缩旧历史。
- Retrieval 相关资料:长期信息不一定每轮都塞入 Context,可以按需取回。
- Observability / Token Usage:后续会统计每个 Run 的输入 Token、输出 Token 和总成本。
- Log Truncation / Error Summarization:适合 Tool Result 很长的 Agent 场景。
- Long-context Model Behavior:帮助理解“窗口更大”为什么仍然不等于“所有信息都应该放进去”。
术语表
- 上下文窗口(Context Window):模型单次调用能够接收和处理的上下文容量上限,通常需要同时考虑输入和输出占用。
- Token:模型处理文本的基础单位。一个 Token 不固定等于一个汉字或一个英文单词,代码、JSON、中文和英文的切分方式都不同。
- 输入 Token(Input Token):本轮模型调用之前传入的所有上下文所占 Token,包括 System Prompt、Conversation、Tool Results、Working Memory、Tool Schema 等。
- 输出 Token(Output Token):模型本轮生成自然语言、Tool Call 或结构化结果所占的 Token。
- 上下文预算(Context Budget):在 Context Window 内为输入、输出和各类上下文来源分配的可用容量,是 Agent Runtime 的重要资源约束。
- 上下文膨胀(Context Growth):Agent 多轮运行过程中,随着消息、Tool Result、代码、日志和错误不断累积,模型输入持续增长的现象。
- 上下文截断(Context Truncation):在内容过长时只保留部分信息的处理方式。简单按时间截断可能丢失关键规则,因此通常需要结合优先级。
- 上下文使用率(Context Usage Ratio):当前 Input Token 与预留 Output Token 之和,占总 Context Window 的比例,可用于提前触发压缩或裁剪策略。
- 请求前估算(Preflight Estimate):模型调用前,根据 tokenizer 或近似算法预测当前输入占用,用来提前阻止明显超限的请求。
- 实际用量(Actual Usage):模型调用完成后由 Provider 返回的 Input / Output Token 统计,更适合计费、Trace 和估算误差校准。
- Run 累计 Token(Run Total Tokens):同一 Run 中多次模型调用实际用量之和,用于衡量总成本,不等于某一次请求的 Context 大小。
本章总结
这一节,我们真正解释了,为什么 Agent 的 Context Window 会爆。
关键原因不是单一因素,而是整个 Agent Runtime 都在持续制造上下文。
一个普通 Chatbot 主要积累:
User
Assistant
而 Agent 会持续积累:
用户消息
模型消息
Tool Call
Tool Result
代码文件
运行日志
异常信息
SQL 结果
Working Memory
Project Rules
Skills
Tool Schema
而且一个用户任务内部可能有几十个 Step。
所以即使用户只说一句,“帮我修这个 Bug。”
内部也可能产生几万甚至更多 Token。
我们先明确了四个最基础概念:
Context Window
Token
Input Token
Output Token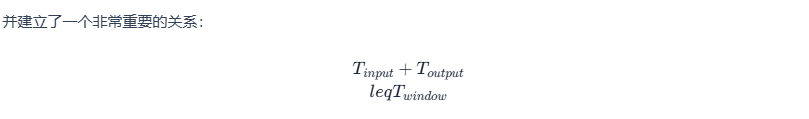
也就是说,模型上下文不是只给 Input 用的。
还要为 Output 预留空间。
我们还看到,Agent 最容易膨胀的来源通常不是用户消息,而是:
Tool Result
代码文件
日志
异常栈
SQL 结果
尤其 Tool Result 长度很不稳定。
这也是为什么前面我们已经给基础 Tool 加:
max_chars
max_results
output truncation
这些不是可有可无的优化,而是 Context 管理的一部分。
这一节还建立了另一个非常重要的认识,Context 没到硬上限,也可能已经“太长”。
过长上下文会让:
成本上升
延迟增加
关键规则被淹没
旧错误干扰当前判断
Agent 重复调查
Tool 选择变差
所以 Context Engineering 的目标不是,“别让 API 报 ContextLengthExceeded。”
而是,让每一轮输入都尽可能相关、清晰、稳定。
我们还实现了一个简单:
ContextUsage监控:
Input Token
Reserved Output
Context Window
Usage Ratio
并根据:
NORMAL
WATCH
COMPACT_SOON
CRITICAL
提前发现风险。
真正成熟的 Agent 不应该等到超过窗口才压缩。
而且压缩也不能简单:
messages = messages[-20:]因为这样可能把最早但最重要的规则删掉。
真正应该稳定保留:
System Rules
Safety Rules
Project Rules
Current Task
Working Memory
关键 Observation
而优先压缩:
旧 Conversation
重复 Tool Result
大日志
完整 traceback
过期信息
如果你现在已经能回答,“为什么 Agent 比普通 Chatbot 更容易把 Context 撑爆?”
那么这一节最核心的目标就完成了。
下一节,我们会正式解决这个问题,Context Compaction:让 Agent 学会压缩记忆。
也就是把:
旧消息
旧 Tool Result
长日志
历史细节
提炼成:
任务摘要
关键结论
已完成事项
当前错误
最近几轮
让 Agent 即使运行很久,也能继续保持稳定上下文。
















请登录后查看评论内容