

上一节,我们已经回答了一个很重要的问题,为什么 Agent 不能永远停留在 agent.run("分析这个项目") 这种本地 Python 调用里?
因为真实系统的调用方可能是:
Frontend
App
飞书
其他后端服务
它们需要一个稳定的网络入口。
所以我们把架构从:
Python Script
  ↓
AgentEngine
升级成:
Client
  ↓
HTTP API
  ↓
Flask
  ↓
AgentService
  ↓
AgentEngine
这一节不再只讲架构。
我们正式写出第一个真正的 Agent API:
POST /api/v1/chat请求:
{
  "message": "检查这个 Python 项目"
}
响应:
{
  "answer": "...",
  "run_id": "...",
  "status": "completed"
}
这一步非常关键。
因为从这一节开始,我们的 Agent 不再只是,“一个可以运行的 Python 程序。”
而开始变成,一个可以被其他系统通过 HTTP 调用的 Backend Service。
开场引入
先回忆一下本地版本。
最简单的时候,我们可能写:
result = agent.run(
    "检查这个 Python 项目"
)

print(result)
这种调用方式非常舒服。
代码里有 Agent 对象,直接调函数就行。
但真实 Web 页面里,浏览器不可能直接运行服务器上的 Python 方法。
前端更常做的是:
POST /api/v1/chat请求体:
{
  "message": "检查这个 Python 项目"
}
服务端收到以后,再:
Flask Route
  ↓
AgentService
  ↓
AgentEngine
最后返回 JSON。
也就是说,我们这次真正要完成的,不只是“写一个 Flask 接口”。
而是把:
函数参数变成:
HTTP Request把:
Python 返回值变成:
HTTP Response同时还要加入:
参数校验
错误码
run_id
status
这些都意味着系统边界变得正式。
“正式”不等于第一版就堆满功能,而是这条小接口的行为要说得清:只接受 JSON 对象,message 必须是非空字符串;失败时始终返回 JSON;内部异常有可关联的请求标识,却不会把 traceback 暴露出去。接口小一点没有关系,边界含糊才会让后面越来越难补。
为什么第一版 API 不要做得太复杂?
很多人一开始就想:
用户鉴权
数据库
异步任务
WebSocket
SSE
多模型
上传文件
工作区
回调
队列
结果第一个 API 两天都跑不通。
这一节我们刻意只解决一件事,把 Agent 通过 HTTP 真正调用起来。
所以第一版接口只接收:
{
  "message": "..."
}
返回:
{
  "answer": "...",
  "run_id": "...",
  "status": "completed"
}
等这条链路稳定以后,下一节再正式把 Run 生命周期做完整。
为什么现在就加 run_id?
有人会问,“既然这一节还没讲 Run,为什么响应里已经有 run_id?”
因为真实 Backend Service 从第一天开始就应该为任务提供一个唯一标识。
即使当前任务同步执行、立即返回,run_id 依然有价值:
日志关联
错误排查
Trace
后续状态查询
性能统计
所以这一节先生成 run_id。
下一节再让它拥有真正的:
READY
RUNNING
COMPLETED
FAILED
生命周期。
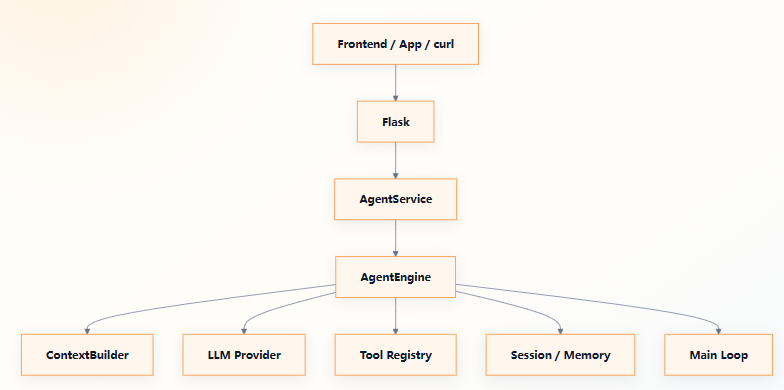
知识地图
















请登录后查看评论内容