

到了这里,问题已经不是“API 能不能回一段字符串”,而是“这套 API 能不能真正接上你前面已经写好的 Harness”。如果只盯着当前这个 Flask Route,你很容易把视角放窄;从更大的接入关系看,会更容易理解为什么 Harness 这一层这么关键。
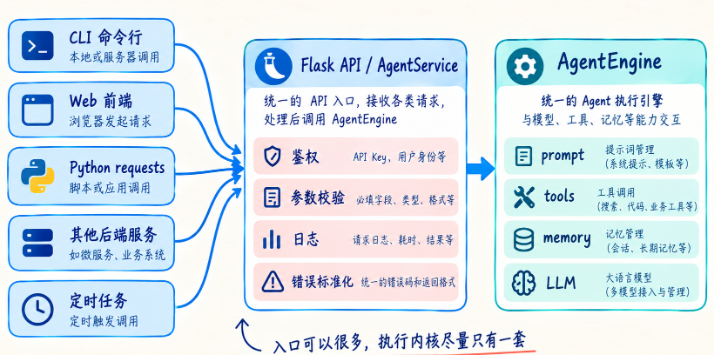
图里左边列出的 CLI、Web、Python requests、其他后端服务、定时任务,本质上都只是不同入口。中间的 Flask API / AgentService 负责把这些入口统一接住,鉴权、参数校验、日志、错误标准化也都放在这里做。真正的执行核心尽量保持只有一套,也就是后面的 AgentEngine。这样你前面实现的 Harness 才不是“只在某个页面里能用一次”,而是能被不同场景稳定复用。
上一段为了演示,AgentEngine.run() 只是:
return "已完成..."真实课程里,我们当然要接前面实现的 Harness。
你可以把它理解成:
class AgentEngine:

    def __init__(
        self,
        provider,
        registry,
        context_builder,
        session_manager,
    ):
        self.provider = provider
        self.registry = registry
        self.context_builder = (
            context_builder
        )
        self.session_manager = (
            session_manager
        )

    def run(
        self,
        task: str,
    ) -> str:
        # 这里执行前面已经实现的 Main Loop
        ...
Flask 完全不需要知道里面有多少组件。
它永远只调用:
service.chat(...)一个模拟 Harness 的完整例子
下面代码模拟一个两步 Agent:
先检查任务
再输出结论这个结构以后可以直接把 AgentEngine.run() 内部替换成:
ContextBuilder
 ↓
Provider
 ↓
Tool Call
 ↓
Observation
 ↓
Main Loop
HTTP 层完全不用动。
为什么这是架构的关键?
因为真正优秀的后端设计不是,“接口能跑。”
而是,接口与核心能力之间的边界稳定。
这样未来增加:
SSE
Session
Run API
SQLite
权限
都可以逐层扩展。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END















请登录后查看评论内容