

如果你只看最小代码:
while True:
    response = llm.chat(messages)
    ...
很容易觉得 Main Loop 很简单。
真正做项目以后,你会发现,“循环”本身简单,控制循环 才难。
至少要回答四个问题。
第一个问题:什么时候算完成?
最简单判断:
if response.tool_call is None:
    return response.answer
意思是模型不再请求 Tool,而是给出最终答案。
但这并不一定永远可靠。
模型可能:
- 过早结束;
- 信息不足却直接猜答案;
- 明明应该验证却没有验证。
后面我们做 Coding Agent 时,会进一步加入“完成条件”。
例如修 Bug:
不能仅仅是“模型说修好了”还应该:
测试通过
+
没有新的错误
+
模型给出最终总结
这就是 Agent 从 Demo 走向工程时非常重要的变化。
第二个问题:什么时候必须强制停?
最基本的是:
max_steps比如:
MAX_STEPS = 20到了 20 步,无条件终止。
为什么必须有?
因为可能发生:
read_file
 ↓
search_file
 ↓
read_file
 ↓
search_file
 ↓
……
甚至同一个动作反复执行。
真实系统还会增加:
Timeout
Max Token
Max Tool Calls
Cost Budget
这些后面再细讲。
现在先记住,任何 Agent Loop 都必须有资源边界。
第三个问题:Tool 失败怎么办?
错误不应该直接让整个 Agent 崩掉。
例如:
result = execute_tool(...)如果抛异常:
FileNotFoundError一种更稳的做法是捕获,并转换成 Observation:
try:
    result = execute_tool(tool_call)
except Exception as exc:
    result = {
        "ok": False,
        "error": str(exc)
    }
然后让模型看到:
Observation:
工具执行失败,原因是 FILE_NOT_FOUND
它才有机会恢复。
下面给一个完整最小版本:
from dataclasses import dataclass
from typing import Optional


@dataclass
class ToolCall:
    name: str
    arguments: dict


@dataclass
class Response:
    answer: Optional[str] = None
    tool_call: Optional[ToolCall] = None


def read_file(path: str) -> str:
    if path != "README.md":
        raise FileNotFoundError(path)

    return "Agent Harness Demo"


def execute_tool(call: ToolCall):
    if call.name == "read_file":
        return read_file(call.arguments["path"])

    raise ValueError(f"未知工具:{call.name}")


def run_tool_safely(call: ToolCall) -> dict:
    try:
        result = execute_tool(call)
        return {
            "ok": True,
            "result": result
        }
    except Exception as exc:
        return {
            "ok": False,
            "error_type": type(exc).__name__,
            "error": str(exc)
        }


def fake_llm(messages: list[dict]) -> Response:
    tool_messages = [
        message
        for message in messages
        if message["role"] == "tool"
    ]

    if not tool_messages:
        return Response(
            tool_call=ToolCall(
                name="read_file",
                arguments={"path": "app.py"}
            )
        )

    last = tool_messages[-1]["content"]

    if '"ok": False' in last:
        return Response(
            tool_call=ToolCall(
                name="read_file",
                arguments={"path": "README.md"}
            )
        )

    return Response(
        answer="第一次读取失败后已经恢复,并成功读取 README.md。"
    )


def run_agent(max_steps: int = 5) -> str:
    import json

    messages = [
        {
            "role": "user",
            "content": "读取项目说明"
        }
    ]

    for step in range(max_steps):
        response = fake_llm(messages)

        if response.tool_call is None:
            return response.answer or "任务结束"

        observation = run_tool_safely(response.tool_call)

        messages.append({
            "role": "assistant",
            "content": (
                f"TOOL_CALL: {response.tool_call.name} "
                f"{response.tool_call.arguments}"
            )
        })

        messages.append({
            "role": "tool",
            "content": json.dumps(
                observation,
                ensure_ascii=False
            )
        })

    return "达到最大步数"


if __name__ == "__main__":
    print(run_agent())
这个结构特别重要。
后面我们的 Tool Error Recovery,本质上就是把这里做得更系统。
第四个问题:怎么避免重复动作?
如果模型连续三次:
read_file("app.py")通常说明 Loop 出问题了。
可能原因有:
- Observation 没进入 Context;
- Tool Result 格式不清;
- 模型不知道之前做过;
- 当前任务描述不明确;
- State 缺少“已完成动作”;
- 模型陷入局部循环。
最简单可以先做重复检测:
recent_calls = []

call_key = (
    response.tool_call.name,
    str(response.tool_call.arguments)
)

recent_calls.append(call_key)

if len(recent_calls) >= 3:
    if len(set(recent_calls[-3:])) == 1:
        return "检测到重复 Tool Call,停止执行"
后面我们会把这些信息放入 State。
但现在先知道,Main Loop 不只是“循环”,还需要监控循环是否健康。
把继续、完成、强制停止和等待审批放进同一张分流图,可以更准确地理解一次循环结束后系统要做的判定。
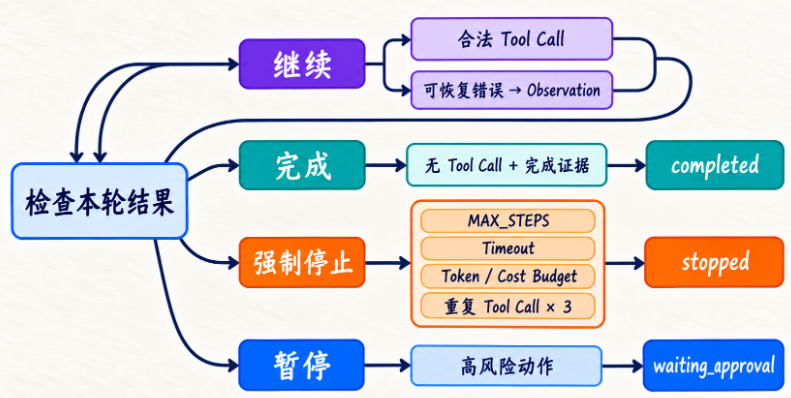
有有效 Tool Call 或可恢复错误时进入下一轮;没有 Tool Call 且证据完整时才算完成。触发预算、超时或重复调用则应停止,高风险动作还需要单独进入 waiting_approval,而不是混进普通成功或失败状态。
一个更接近真实工程的最小 Main Loop
把今天讲的内容合起来,可以得到一个比最初几行更完整的版本:
def run_agent(llm, messages, max_steps: int = 20):
    recent_calls = []

    for step in range(max_steps):
        response = llm.chat(messages)

        if response.tool_call is None:
            return {
                "status": "completed",
                "answer": response.answer,
                "steps": step + 1
            }

        call_key = (
            response.tool_call.name,
            str(response.tool_call.arguments)
        )

        recent_calls.append(call_key)

        if len(recent_calls) >= 3:
            if len(set(recent_calls[-3:])) == 1:
                return {
                    "status": "stopped",
                    "reason": "检测到连续重复 Tool Call"
                }

        try:
            result = execute_tool(response.tool_call)
            observation = {
                "ok": True,
                "result": result
            }
        except Exception as exc:
            observation = {
                "ok": False,
                "error": str(exc)
            }

        messages.append({
            "role": "assistant",
            "content": str(response.tool_call)
        })

        messages.append({
            "role": "tool",
            "content": str(observation)
        })

    return {
        "status": "stopped",
        "reason": "达到最大执行步数"
    }
这里已经出现:
- 循环;
- 完成退出;
- Tool Call;
- Tool Execution;
- Observation;
- 错误回传;
- 最大步数;
- 重复检测。
下一节我们会进一步解决一个现在还比较“散”的问题,这些 messages、当前 step、最近 Tool Call、状态,到底应该放在哪里?
答案就是,Agent State。
把一轮工具调用完整送回下一轮
我们先沿消息走一遍。用户提出任务后,模型返回一条包含工具调用的 assistant 消息,Harness 保存它,再执行工具,并把结果与原调用关联起来。下一轮模型才能同时看到“刚才请求了什么”和“实际得到了什么”。只往历史里塞一条工具结果,会让消息协议失去上下文关联;离线函数可能容忍,真实接口却不一定接受。
当我们接入 OpenAI 兼容的真实模型时,前面的教学伪代码还差一个容易被忽略的细节:模型先前发出的 assistant 消息里,必须保留 tool_calls;随后每一条 tool 消息还必须带回对应的 tool_call_id。两者一前一后,模型才能确认“这份 Observation 回答的是哪一个动作”。
课程配套主循环会把这一轮整理成下面的形状。没有真实调用 ID 的 Fake Provider,也会得到一个仅供本轮使用的稳定 ID,方便我们先离线验证消息往返:
messages.append({
    "role": "assistant",
    "content": response.content or None,
    "tool_calls": [{
        "id": call_id,
        "type": "function",
        "function": {
            "name": call.name,
            "arguments": json.dumps(call.arguments)
        },
    }],
})

messages.append({
    "role": "tool",
    "tool_call_id": call_id,
    "name": call.name,
    "content": json.dumps(result),
})
这里最常见的坑,是只留下第二条消息。Fake LLM 往往不会介意,真实 Provider 却可能直接拒绝请求,或者让模型把结果误认成普通对话。我们在离线回归里验证了调用 ID 从第一轮保留到第二轮,也验证了工具结果确实进入下一轮 Context。
建议用一个很短的轨迹检查实现:第一轮请求读取文件,工具返回“文件不存在”;第二轮请求列目录;第三轮基于新路径读取文件。我们记录每一轮的消息角色、调用标识和结果。这里的 Reason 表示模型做出决策的阶段,不要求模型输出完整内部推理;可观察的调用和反馈已经足够检查控制流。
循环的出口也要区分。COMPLETED、FAILED、CANCELLED 和 BUDGET_EXCEEDED 可以是终态;PAUSED 与 WAITING_APPROVAL 通常表示本次推进停下,但任务仍可继续。配套 Engine 目前只在轮次边界检查取消,检查点也仅记录计数;这些还不等于中断中的工具能被终止,或进程重启后能恢复执行。
动手验证:让失败变成下一步的依据
给模拟 Provider 安排“读错路径→列目录→读取正确文件→回答”的响应序列。参考验收是:第一次工具失败进入 Observation,后续仍能推进;最终结果通过完成条件检查。再删除中间一条结果,观察模拟器是否能发现消息不完整。我们检查的是整个往返过程,而不只是循环是否退出。














请登录后查看评论内容