

很多人第一次看 Agent 会觉得,“是不是因为现在大模型特别会规划,所以才能连续做几十步?”
规划能力当然有帮助。
但 Main Loop 更基础。
即使模型没有先生成完整计划,只要它能做到:
看当前情况
 ↓
选一个合理动作
 ↓
获取结果
 ↓
重新判断
它就能持续推进。
这和人做排障其实很像。
你不会一开始就准确知道所有步骤。
例如电脑打不开某个服务,你可能:
先看错误
 ↓
发现端口占用
 ↓
查哪个进程占用
 ↓
发现旧进程
 ↓
停止旧进程
 ↓
重新启动
第二步是第一步结果决定的。
第三步又是第二步结果决定的。
这就是反馈驱动。
一次性 Plan 的问题
假设模型第一次就生成:
1. 读取 app.py
2. 读取 requirements.txt
3. 运行 pytest
4. 修改 app.py
5. 再次测试
但第一步返回:
app.py 不存在如果系统仍然机械执行原计划,后面就会不断偏离真实项目。
所以 Main Loop 的价值在于,每一步都允许计划被真实环境修正。
我们可以把两者对比成:
静态计划:

Plan
 ↓
Step 1
 ↓
Step 2
 ↓
Step 3
 ↓
Finish
和:
Agent Loop:

Goal
 ↓
Action 1
 ↓
Observation 1
 ↓
重新决定
 ↓
Action 2
 ↓
Observation 2
 ↓
重新决定
后面我们会专门学习 Planner。
但你要提前建立一个判断,Planner 是 Main Loop 的增强,不是 Main Loop 的替代。
静态 Plan 和反馈驱动的 Loop 放在一起比较时,差别不在于有没有步骤,而在于步骤能否被最新 Observation 改写。
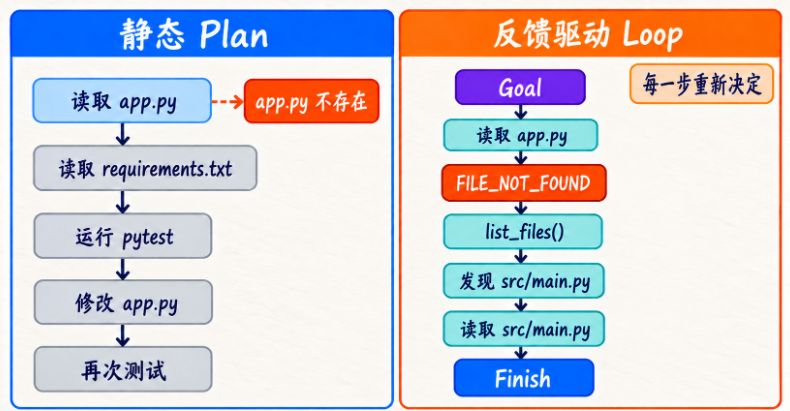
左侧一旦第一步假设错误,后续动作仍会沿旧计划推进;右侧则把 FILE_NOT_FOUND 变成新证据,随即改用 list_files() 探索真实结构。这个“允许改道”的能力,才是动态决策的落点。
多步任务为什么可以越做越具体?
因为 messages 在积累证据。
第一次:
用户:
为什么项目启动失败?
第二轮:
用户:
为什么项目启动失败?

工具:
目录中有 pyproject.toml、src/main.py
第三轮:
用户:
为什么项目启动失败?

工具:
目录中有 pyproject.toml、src/main.py

工具:
src/main.py 导入 requests
第四轮:
工具:
pyproject.toml 没有 requests
模型掌握的信息越来越完整。
于是决策从,“我需要先看看项目。”
逐渐变成,“根因大概率是依赖未声明。”
这就是 Agent 的“渐进式确定”。
不是一次性全知,而是通过环境反馈逐渐缩小不确定性。
把四轮 messages 摊开,就能看到结论不是凭空生成的,而是随着工具证据一层层收敛出来的。
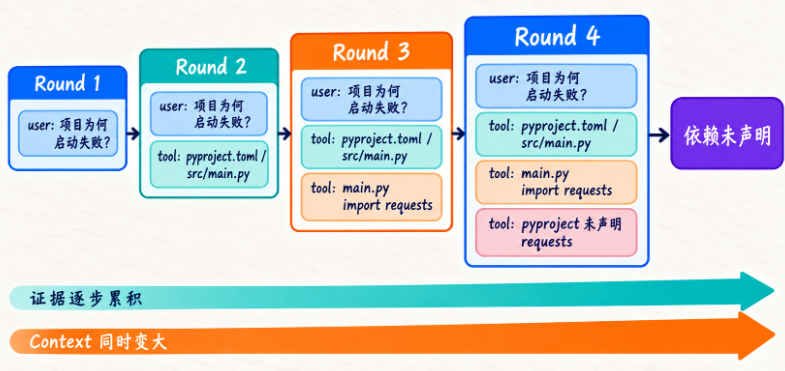
目录结构、源码导入和依赖声明分别来自不同轮次;当它们共同留在 Context 中,模型才有足够依据判断“依赖未声明”。与此同时,Context 也在持续变大,这正好引出下面的上下文治理问题。
但 messages 也会越来越大
这里先埋一个后面的伏笔。
Main Loop 每走一轮,都可能追加:
assistant message
tool call
tool result
如果任务很长:
30 Step
50 Step
100 Step
上下文会越来越大。
尤其 Tool Result 可能非常夸张:
- 一个文件几千行;
- pytest 错误几百行;
- SQL 返回上千行;
- Shell 日志几 MB。
所以 Main Loop 虽然让 Agent 能连续工作,但也自然引出了后面的 Context Engineering。
这就是为什么课程顺序是:
Main Loop
 ↓
State
 ↓
Tool
 ↓
Context
 ↓
Memory
我们不是随便排章节。
每一个模块都是 Main Loop 跑起来以后真实出现的问题。
多步任务的停止也很关键
如果模型每轮都认为,“我还可以再查一点。”
那 Loop 永远不会结束。
所以 Main Loop 最终一定要有至少两类退出条件。
第一类:模型主动完成。
response.tool_call == None然后:
return response.answer第二类:系统强制停止。
例如:
max_steps = 20哪怕模型还想继续,也必须停。
这是非常重要的工程边界。
我们改写最初的无限循环:
def run_agent(llm, messages, max_steps: int = 20):
    for step in range(max_steps):
        response = llm.chat(messages)

        if response.tool_call:
            result = execute_tool(response.tool_call)
            messages.append(result)
        else:
            return response.answer

    return "达到最大执行步数"
这比:
while True:更安全。
为什么最大步数不是“笨办法”?
因为 LLM 的决策具有概率性。
即使 Prompt 很好,也可能:
- 重复搜索;
- 在两个工具之间来回切换;
- 一直想获得更多证据;
- 因 Observation 格式不清导致误判;
- 因工具失败不断重试。
因此系统必须有硬边界。
后面我们会专门讲:
Max Steps
Timeout
Max Token
Max Tool Calls
现在先把最基础的 max_steps 放进心智模型。
一个“证据逐步累积”的完整示例
下面我们模拟一个数据分析 Agent。
from dataclasses import dataclass
from typing import Optional


@dataclass
class ToolCall:
    name: str
    arguments: dict


@dataclass
class Response:
    answer: Optional[str] = None
    tool_call: Optional[ToolCall] = None


def query_total_revenue() -> dict:
    return {
        "yesterday": 80,
        "day_before": 100,
        "change": -0.20,
    }


def query_by_media() -> dict:
    return {
        "media_A": -0.02,
        "media_B": -0.32,
        "media_C": 0.01,
    }


def query_media_b_metrics() -> dict:
    return {
        "request_change": 0.01,
        "exposure_change": -0.03,
        "ecpm_change": -0.35,
    }


def execute_tool(call: ToolCall):
    if call.name == "query_total_revenue":
        return query_total_revenue()

    if call.name == "query_by_media":
        return query_by_media()

    if call.name == "query_media_b_metrics":
        return query_media_b_metrics()

    return {"error": "unknown tool"}


def fake_llm(messages: list[dict]) -> Response:
    tool_results = [
        message["content"]
        for message in messages
        if message["role"] == "tool"
    ]

    if len(tool_results) == 0:
        return Response(
            tool_call=ToolCall(
                name="query_total_revenue",
                arguments={}
            )
        )

    if len(tool_results) == 1:
        return Response(
            tool_call=ToolCall(
                name="query_by_media",
                arguments={}
            )
        )

    if len(tool_results) == 2:
        return Response(
            tool_call=ToolCall(
                name="query_media_b_metrics",
                arguments={}
            )
        )

    return Response(
        answer=(
            "收入下降主要集中在 media_B。"
            "media_B 请求量基本稳定,但 eCPM 下降约 35%,"
            "因此当前证据更支持变现价格下降,而不是整体流量减少。"
        )
    )


def run(max_steps: int = 10) -> str:
    messages = [
        {
            "role": "user",
            "content": "为什么昨天收入下降?"
        }
    ]

    for step in range(max_steps):
        response = fake_llm(messages)

        if response.tool_call is None:
            return response.answer or "无最终结论"

        result = execute_tool(response.tool_call)

        messages.append({
            "role": "assistant",
            "content": (
                f"TOOL_CALL: {response.tool_call.name} "
                f"{response.tool_call.arguments}"
            )
        })

        messages.append({
            "role": "tool",
            "content": str(result)
        })

    return "达到最大步数"


if __name__ == "__main__":
    print(run())
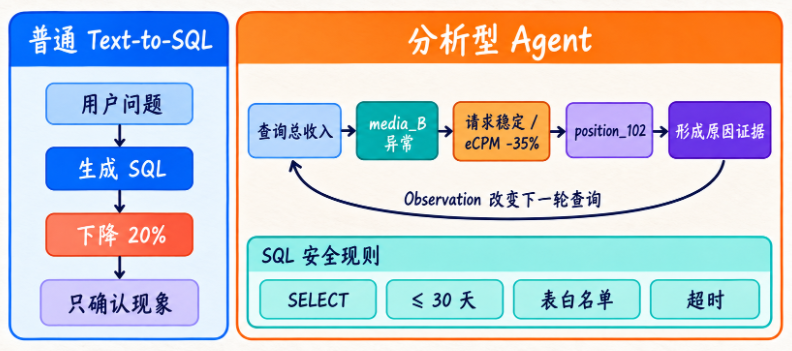
这个 Agent 并不是一开始就知道,“media_B 的 eCPM 有问题。”
它是:
先确认总收入下降
 ↓
再拆媒体
 ↓
发现 media_B
 ↓
再查 media_B 指标
 ↓
形成结论
这就是 Main Loop 让多步任务成为可能的原因。














请登录后查看评论内容