

上一节我们已经把 Tool Registry 搭起来了。
现在 Harness 已经知道:
read_file
write_file
run_python
run_shell
这些 Tool 到底对应哪个 Python 函数,也可以:
registry.get("read_file")
registry.execute(...)但接下来会出现一个非常现实的问题,Registry 知道工具怎么执行,不代表模型知道工具怎么用。
比如我们只有:
你有一个工具叫 read_file它可能输出:
{
  "name": "read_file",
  "arguments": {}
}
也可能输出:
{
  "name": "read_file",
  "arguments": {
    "filename": "app.py"
  }
}
甚至:
{
  "name": "read_file",
  "arguments": {
    "path": 123
  }
}
所以我们需要把 Python 函数的“使用说明”转换成模型能稳定理解的结构化协议。
也就是:
{
  "name": "read_file",
  "description": "读取指定文件",
  "parameters": {
    "type": "object",
    "properties": {
      "path": {
        "type": "string"
      }
    },
    "required": [
      "path"
    ]
  }
}
这一节我们就把这个过程亲手实现出来。
重点不是背 JSON,而是理解一句话,Tool Schema 本质上是 Agent 与程序之间的协议。
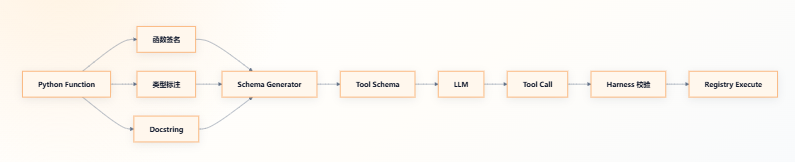
我们可以先把它放进一条完整链路里:
Python 函数签名
  ↓
Harness 内部 Tool Schema
  ↓
Provider 转成目标模型需要的格式
  ↓
模型生成 Tool Call
  ↓
Harness 校验参数后再执行
这里最容易混淆的是最后一步。Schema 能帮助模型把参数“写得更像正确答案”,但它不会自动拦住所有错误输入。只有执行前真的运行了校验,Schema 才从一份说明升级为可执行的约束。
模型按协议产生 Tool Call。
Harness 应按协议校验参数。
Registry 根据工具名找到真实函数。
Executor 最后执行。
这条链一旦打通,Tool 系统就开始真正稳定起来。
把这几个角色放到一张图里会更容易建立整体直觉。下面这张图重点看两条线:上半段是“函数信息怎样变成模型能理解的协议”,下半段是“模型按协议提出调用以后,Harness 怎样接住并真正执行”。这样再往后看 name、required、类型映射时,就不会把 Schema 当成一段孤立的 JSON。
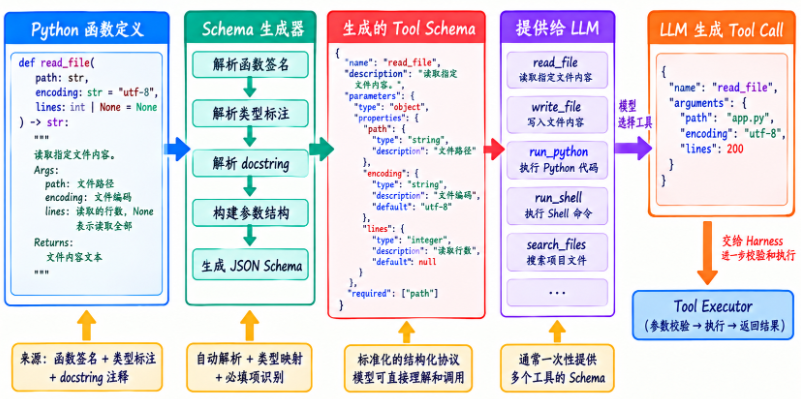
图里最需要记住的不是箭头数量,而是职责边界:模型只根据 Schema 生成 Tool Call,真正的校验和执行仍然发生在 Harness 一侧。 Schema 把两边连起来,但不会把两边合成一层。
开场引入
我们先想象一个没有 Tool Schema 的 Agent。
Harness 里已经注册:
@tool()
def read_file(path: str) -> str:
    """读取指定文件。"""
    ...
开发者很清楚它怎么用。
但模型看到什么?
如果我们只是写一句 Prompt:
你可以使用 read_file 工具读取文件。模型会自己猜参数。
第一次可能猜:
{
  "name": "read_file",
  "arguments": {
    "path": "app.py"
  }
}
正好猜对。
于是我们会误以为,“这不就能用了?”
但第二次模型可能生成:
{
  "name": "read_file",
  "arguments": {
    "file": "app.py"
  }
}
Harness 执行:
read_file(file="app.py")直接:
TypeError再比如 query_metric:
def query_metric(
    metric: str,
    date_start: str,
    date_end: str,
    limit: int = 100,
):
    ...
如果没有 Schema,模型根本不知道:
- 参数到底叫
date_start还是start_date; limit是字符串还是整数;- 哪些参数必须传;
- 哪些参数有默认值;
metric应该表达什么;- 这个 Tool 到底什么时候适合用。
所以 Tool Calling 要想稳定,模型必须拿到一份清晰协议。
这份协议至少回答四个问题:
工具叫什么?
它是干什么的?
它有哪些参数?
哪些参数必须提供?
更进一步还可以回答:
参数是什么类型?
有哪些枚举值?
数值范围是什么?
数组里面是什么类型?
对象里还有哪些字段?
这就是 Tool Schema。
最关键的一点在于,它不是“给人看的 API 文档”。
它是直接进入模型上下文、参与模型动作选择的结构化信息。
也就是说,Schema 写得好不好,会直接影响:
模型是否选对 Tool
模型是否传对参数
Harness 是否容易校验
错误率高不高
很多 Tool Calling 问题,表面看起来像,“模型怎么老是不会调用工具?”
最后查下来其实是,工具协议写得太模糊。
例如 Tool 描述:
query模型根本不知道它查什么。
参数描述:
value模型也不知道应该填什么。
所以这一节不仅要学会“自动生成 Schema”,还要理解,Schema 设计本身就是 Agent 能力设计的一部分。
自动生成只是减少重复劳动。
真正决定质量的,仍然是函数签名、类型标注、命名与描述是否清晰。
知识地图
这一节承接 Tool Registry,下一节就会开始批量打造基础 Tool。
















请登录后查看评论内容