

先看最简单的函数:
def read_file(path: str):
    """读取指定文件"""
对于 Python 开发者来说,这个接口已经很清楚。
但对于模型来说,它需要被翻译。
最基础可以转换成:
{
  "name": "read_file",
  "description": "读取指定文件",
  "parameters": {
    "type": "object",
    "properties": {
      "path": {
        "type": "string"
      }
    },
    "required": [
      "path"
    ]
  }
}
这里每一个字段都有意义。
先别急着逐字段背定义,可以先把这份 Schema 当成一张“机器可读的工具说明卡”。name 解决“调用谁”,description 解决“什么时候调用”,parameters 解决“参数长什么样”,而 required 则直接告诉模型哪些字段不能漏。下面这张图把这几个字段放回一次真实调用链里,关系会更清楚。
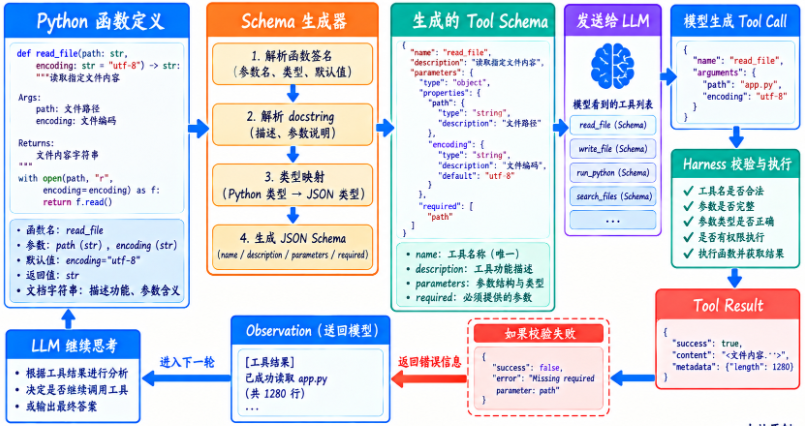
后面逐个看字段时,可以不断回到这张图:字段不是为了把 JSON 写完整,而是在减少模型猜测。 模型需要猜的东西越少,Tool Call 通常就越稳定。
name:模型最终会返回的动作名
"name": "read_file"它必须和 Registry 能查到的 Tool Name 对上。
如果 Schema 叫:
read_text_file但 Registry 只有:
read_file模型产生 Tool Call 后就会执行失败。
所以,Schema Name 与 Registry Name 必须保持一致。
这也是为什么上一节强调,Registry 应该成为单一事实来源。
description:模型为什么要选择这个 Tool
这是最容易被低估的字段。
例如:
读取指定文件比:
读文件更清晰一点。
如果再具体:
读取工作目录内 UTF-8 文本文件的完整内容,适合查看代码、配置和 Markdown 文件。模型就更容易判断什么时候使用。
Tool Description 实际上参与的是:
Tool Selection而不仅是“帮助文档”。
如果你有两个 Tool:
描述必须让模型知道区别。
例如:
read_file:
已知具体路径时读取文件完整内容。

search_files:
不知道具体文件位置时,根据关键词搜索文件名或内容。
这会显著减少,明明不知道路径,却一直乱猜 read_file()。
parameters.type = object
为什么参数整体是对象?
因为 Tool Call 通常以:
{
  "path": "app.py",
  "encoding": "utf-8"
}
这样的键值对形式传递。
它本质上对应 Python:
func(**arguments)所以参数集合天然是一个 object。
properties:每个参数的结构
例如:
path: str对应:
"path": {
  "type": "string"
}
limit: int:
"limit": {
  "type": "integer"
}
recursive: bool:
"recursive": {
  "type": "boolean"
}
这就是 Python Type Hint 到 JSON Schema 的基础映射。
required:哪些参数必须存在
看:
def read_file(
    path: str,
    encoding: str = "utf-8",
):
    ...
这里:
path没有默认值。
是必填。
encoding 有默认值。
是可选。
所以应该:
"required": [
  "path"
]
如果 required 写错,模型可能每次都被迫生成没必要的字段。
更严重的是,如果必填字段没标 required,模型更容易漏参数。
Schema 实际上同时服务两边
很多同学只想到,Schema 是给模型看的。
但更理想的是:
同一份 Schema
  ├─ 给模型:知道怎么调用
  └─ 给 Harness:知道怎么校验
这就是“协议”的意义。
如果模型看到一份规则,Harness 又用另一份规则校验,很容易不一致。
因此我们真正想实现的是:
Python Function
 ↓
统一生成 Schema
 ↓
Provider 给模型
 ↓
Tool Call
 ↓
Harness 按相同定义校验
这比:
人工写 Prompt 参数说明
+
Python 函数签名
+
另一套校验规则
稳定得多。
不过我们要区分“理想设计”和“当前配套项目已经实现的能力”。本节配套项目会登记并输出 Schema,Provider 也可以把它交给模型;当前 Registry.execute() 仍然是直接调用 Python 函数,还没有自动执行完整 JSON Schema 校验。也就是说,同一份 Schema 服务两边是我们正在搭建的方向,不是看到 parameters 字段后就天然获得的能力。
一个最小 Schema 手写示例
def build_read_file_schema() -> dict:
    return {
        "name": "read_file",
        "description": "读取指定文件",
        "parameters": {
            "type": "object",
            "properties": {
                "path": {
                    "type": "string"
                }
            },
            "required": [
                "path"
            ],
        },
    }


if __name__ == "__main__":
    import json

    schema = build_read_file_schema()

    print(
        json.dumps(
            schema,
            ensure_ascii=False,
            indent=2,
        )
    )
这段代码当然可以用。
但问题是,每个 Tool 都手写一份 Schema,非常容易和函数签名失去同步。
所以我们下一步要自动生成。
















请登录后查看评论内容