

前面几节,我们已经把 Agent 的基础 Tool 系统搭出来了。
Agent 现在可以:
list_files
read_file
search_files
write_file
edit_file
run_python
run_shell
工具失败以后,也已经可以通过:
Tool Exception
  ↓
Error Observation
  ↓
Retry / Fallback
继续恢复。
但到这里,Tool Execution 还有一个明显特点,一轮只执行一个 Tool。
例如 Agent 想快速了解一个陌生项目,可能先后读取:
README.md
app.py
requirements.txt
config.py
如果每个文件读取都要等待 1 秒,那么串行执行需要大约 4 秒。
可这四个读取动作之间根本没有依赖。
读取 README.md,不需要先知道 app.py 的结果。
读取 requirements.txt,也不依赖 config.py。
那为什么不能:
             ┌→ README.md
             ├→ app.py
Agent ───────┼→ requirements.txt
             └→ config.py
同时发出去?
这就是这一节要解决的问题,并行 Tool Calling。
先把两个动作分开:模型一次返回多个 tool_calls,只代表它提出了一批动作;Harness 是顺序执行、线程并发还是异步调度,是另一层决定。前者是模型与 Provider 的协议能力,后者才是执行器的并发能力。只完成第一步却仍在 for call in calls 里逐个执行,功能上支持“多调用”,性能上依然是串行。
严格说,线程和 asyncio 主要提供的是并发:多个任务在一段时间内交错推进。对 I/O 任务,它们能显著减少等待;对纯 Python CPU 计算,线程通常不能直接换来同等的并行加速。课程沿用行业里常见的“并行 Tool Calling”叫法,但我们做技术判断时要记住这层区别。
不过,这一节真正重要的不是学会 asyncio 或 ThreadPoolExecutor 两个 API。
真正重要的是先形成一个非常清晰的工程判断,不是所有 Tool 都适合并发。
独立读取多个文件,适合并行。
同时查四个互不依赖的数据维度,适合并行。
但:
read_file
  ↓
edit_file
  ↓
run_test
明显不能并行。
因为 edit_file 依赖前面读到的内容,run_test 又必须等修改完成以后再验证。
如果把这种流程也并发,Agent 不仅不会更快,反而会得到错误结果。
所以这一节我们会围绕四个问题展开:
什么时候能并发?
同步 Tool 怎么并发?
异步 Tool 怎么并发?
多个并发结果怎么重新进入 Agent Loop?
最终我们会实现:
多个独立 Tool Call
  ↓
并发调度
  ↓
分别执行
  ↓
分别捕获错误
  ↓
统一合并 Tool Result
  ↓
形成 Observation
  ↓
回到 Agent Main Loop
开场引入
我们先从一个非常真实的 Coding Agent 场景开始。
用户给了一个陌生项目:
project/
├── README.md
├── app.py
├── requirements.txt
└── config.py
用户问,“帮我快速判断这个项目是做什么的、怎么启动、依赖什么、配置在哪里。”
如果我们的 Agent 一次只允许一个 Tool Call,它可能这样跑:
Step 1
read_file("README.md")

Step 2
read_file("app.py")

Step 3
read_file("requirements.txt")

Step 4
read_file("config.py")

Step 5
总结
这当然能完成任务。
但仔细看前四步:
read README
read app.py
read requirements
read config
彼此之间没有依赖。
它们都是“信息采集”。
最理想的执行图应该是:
                 ┌─ read README.md ───────┐
                 ├─ read app.py ──────────┤
Agent Decision ──┼─ read requirements.txt ┤→ 合并 Observation
                 └─ read config.py ───────┘
假设每个 Tool 平均耗时:
800 ms串行大约:
0.8 + 0.8 + 0.8 + 0.8 = 3.2 秒理想并行可能接近:
max(0.8, 0.8, 0.8, 0.8) ≈ 0.8 秒现实中还有调度开销,但差距仍然明显。
尤其以后 Agent 调的是:
HTTP API
数据库
文件系统
搜索服务
对象存储
远程 Tool这些任务大量时间都花在,等待 I/O。
所以并发会非常有价值。
但如果你因此得出,“那以后所有 Tool 都一起执行。”
就会出问题。
比如:
Tool 1:
read_file("app.py")

Tool 2:
edit_file("app.py", ...)

Tool 3:
run_shell("python3 app.py")
如果三者同时开始:
edit_file可能在read_file之前完成;run_shell可能在修改完成之前启动;read_file读到的可能是修改前,也可能是修改后;- 最终 Observation 顺序与真实逻辑失去意义。
这就是典型的并发竞态。
所以并行 Tool Calling 的第一原则从来不是,“能并发就并发。”
而是,先判断动作之间有没有依赖和冲突。
这一节,我们会把这个判断正式放进 Harness。
知识地图
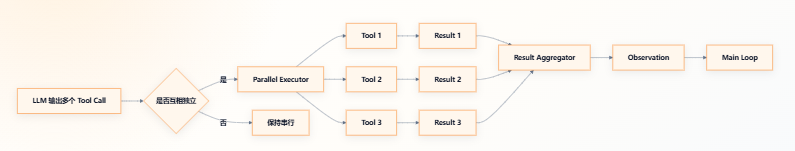
这一节还会比较两种常见方式:
同步 Tool
  ↓
concurrent.futures
和:
异步 Tool
  ↓
asyncio
把这一节的主线先画成一条完整链路,会更容易理解后面的代码为什么要分成“判断、调度、聚合”三部分。模型一次可以提出多个 Tool Call,但 Harness 仍然要先判断它们是否真正独立;能并发的进入 Parallel Executor,不能并发的继续保持顺序执行。
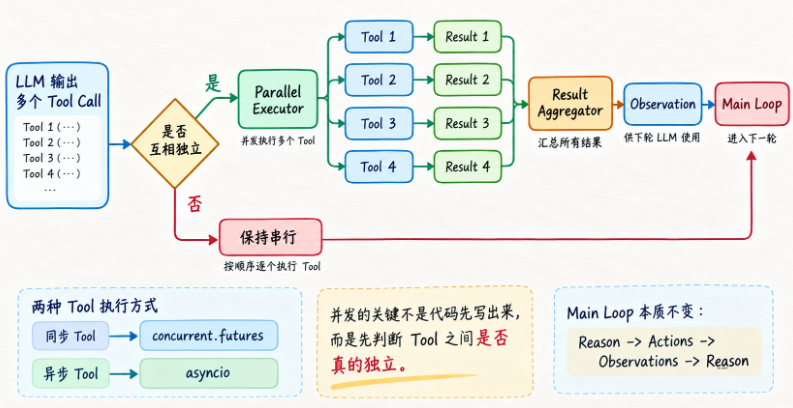
这张图最值得记住的是中间那个判断节点:并发不是模型输出多个 Tool Call 后自动发生的,而是 Harness 在执行层做出的调度决定。 最后无论串行还是并发,结果都还要重新形成 Observation,再回到 Main Loop。
















请登录后查看评论内容