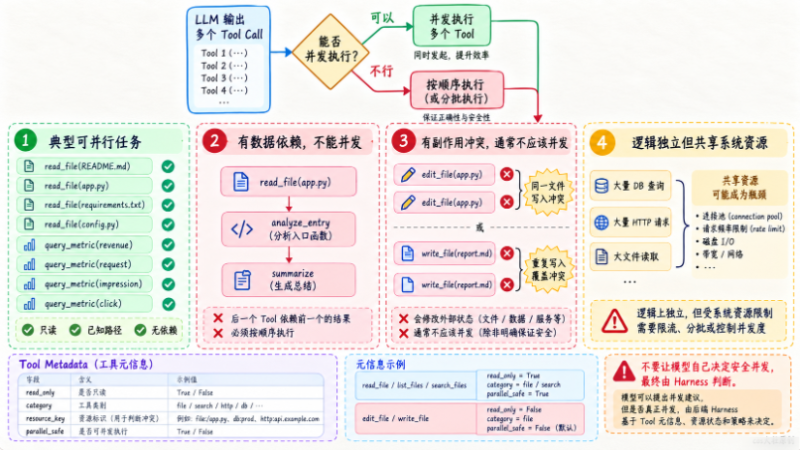


并行执行之前,最重要的问题不是,“代码怎么写?”
而是,这些 Tool 到底能不能同时跑?
我们先定义一个最简单的判断标准,如果 Tool B 的输入不依赖 Tool A 的结果,并且二者执行不会互相修改同一个关键资源,那么它们通常可以考虑并行。
第一类:典型可并行任务
比如:
read_file("README.md")
read_file("app.py")
read_file("requirements.txt")
read_file("config.py")
四个动作都是只读。
而且路径已经确定。
互不依赖。
适合并发。
再比如数据分析:
query_metric("revenue")
query_metric("request")
query_metric("impression")
query_metric("click")
如果四个查询是独立 SQL,也可以并行。
再比如 HTTP:
fetch_api("service_a")
fetch_api("service_b")
fetch_api("service_c")
也很适合。
第二类:有数据依赖,不能并发
例如:
search_files("DATABASE_URL")
  ↓
read_file(搜索结果里的文件)
第二步参数依赖第一步结果。
所以不能同时发出。
因为在搜索完成之前,你甚至不知道 read_file 的 path。
可以抽象成:
A → B这就是依赖。
第三类:有副作用冲突,通常不应该并发
例如:
edit_file("app.py", ...)
write_file("app.py", ...)
都要写同一个文件。
如果同时执行,谁最后写入,结果就可能取决于线程调度。
这类行为不可预测。
所以不能并发。
再比如:
run_shell("pip install x")
run_shell("pip uninstall x")
理论上是两个不同命令,但操作的是同一个环境,也不应该并发。
第四类:逻辑上独立,但共享系统资源
例如同时跑:
20 个 pytest虽然任务可能独立,但 CPU 和内存会被打满。
所以还要考虑,资源层依赖。
因此并行判断不只是:
参数之间有没有依赖还要看:
是否写同一资源
是否消耗大量共享资源
是否访问有限连接池
是否有并发配额
建立一个简单 Tool Metadata
为了让 Harness 更容易判断,可以给 Tool 增加:
read_only
category
resource_key
parallel_safe
例如:
from dataclasses import dataclass
from typing import Callable, Any


@dataclass
class Tool:
    name: str
    func: Callable[..., Any]
    read_only: bool = True
    parallel_safe: bool = True
对于:
read_file
list_files
search_files
可以:
read_only=True
parallel_safe=True
而:
edit_file
write_file
默认:
parallel_safe=False这并不是说写操作永远不能并发。
只是基础 Harness 宁可保守。
parallel_safe=True 也不是看见后就无条件放行。很多冲突取决于参数:两次 edit_file 修改不同文件可能互不影响,修改同一个文件就会竞争;两个查询使用不同连接池可能独立,共用同一事务却不能拆开。因此 resource_key 往往需要根据参数动态计算,例如先把文件路径解析、规范化,再得到 file:/workspace/app.py。只比较模型传来的原始字符串,会把 app.py 和 src/../app.py 错当成两个资源。
一个实用的调度判断顺序是:先检查调用之间有没有数据依赖,再检查读写模式和规范化后的资源键,最后检查连接池、速率限制与总并发预算。任何一层无法确认,都先串行执行。
实际工程里,可以把“能不能并发”拆成几个很具体的问题,而不是只看 Tool Name。只读、路径不同、没有前后依赖,通常是最容易并发的一类;一旦涉及同一资源写入、结果依赖或共享连接池,就需要保守很多。
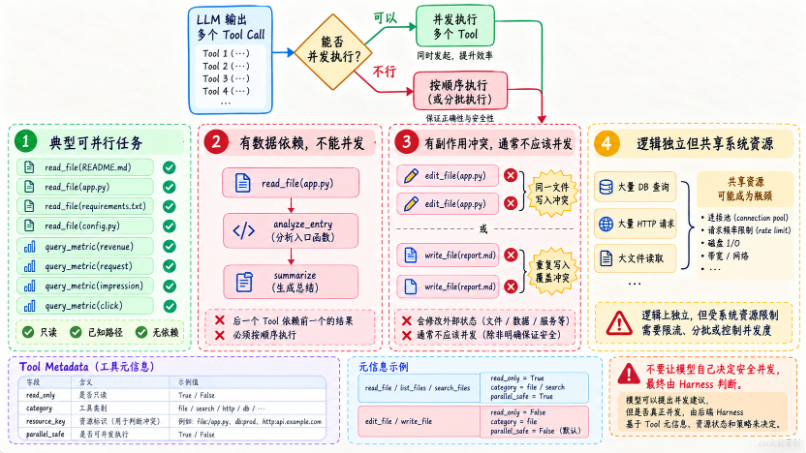
所以 parallel_safe=True 更像一个候选信号,而不是最终结论。最终是否放进同一批并发任务,还应该结合本次 arguments 解析出的真实资源键和系统资源状态一起判断。
不要让模型自己决定“安全并发”
模型可以建议:
这四个读取可以一起做。但最终是否并行,应该由 Harness 校验。
因为模型可能产生:
edit_file A
edit_file A
并认为它们独立。
真正执行层仍然要判断。
这和前面 Tool Safety 的思想完全一致,模型提出动作,Harness 决定动作怎么执行。
用依赖图理解
假设任务有:
A = read README
B = read app.py
C = read requirements
D = 根据 B 分析入口
E = 根据 C 检查依赖
F = 汇总结论
依赖:
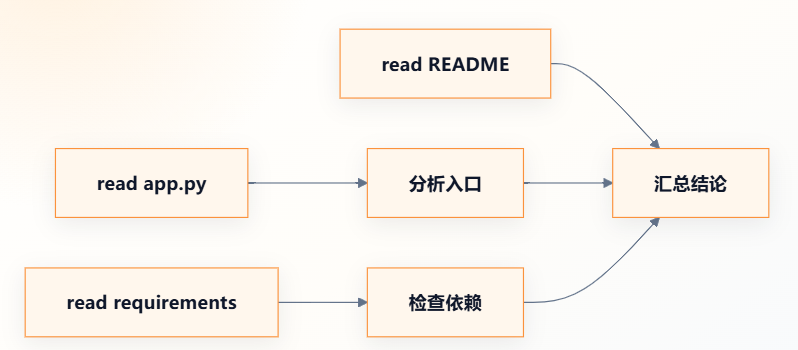
这里 A、B、C 可以并行。
但 D 必须等 B。
E 必须等 C。
F 必须等 A、D、E。
你会发现,并行 Tool Calling 本质上又回到了“依赖关系”。
但和前面 DAG 不同的是,这个依赖图可能是 Agent 在运行时临时产生的。
所以实际 Agent 里会存在:
动态决策
+
局部并发
这是非常常见的组合。
一个简单判断函数
from dataclasses import dataclass


@dataclass
class ToolCall:
    name: str
    arguments: dict


READ_ONLY_TOOLS = {
    "read_file",
    "list_files",
    "search_files",
    "query_metric",
}


def can_run_in_parallel(
    calls: list[ToolCall],
) -> bool:
    if not calls:
        return False

    for call in calls:
        if (
            call.name
            not in READ_ONLY_TOOLS
        ):
            return False

    return True


if __name__ == "__main__":
    calls = [
        ToolCall(
            name="read_file",
            arguments={
                "path": "README.md"
            },
        ),
        ToolCall(
            name="read_file",
            arguments={
                "path": "app.py"
            },
        ),
    ]

    print(
        can_run_in_parallel(
            calls
        )
    )
这个判断很保守。
但在 Agent Harness 早期阶段,保守往往比“过度聪明”更好。
并行的真正原则
你可以先记一句,读操作更容易并行,写操作默认串行;无依赖更容易并行,有依赖必须串行。
后面如果要优化,再逐步放宽。
















请登录后查看评论内容