

我们的很多 Tool 都是普通同步函数:
def read_file(...):
    ...
如果为了并发全部改成:
async def不一定值得。
这时 Python 标准库:
concurrent.futures非常实用。
为什么先讲 ThreadPoolExecutor?
Agent Tool 中大量任务是 I/O 型:
读文件
请求 HTTP
查数据库
等待外部服务
线程在等待 I/O 时,可以让其他线程继续工作。
所以:
ThreadPoolExecutor非常适合基础 Tool 并发。
最小例子
from concurrent.futures import (
    ThreadPoolExecutor,
)


def task(name: str) -> str:
    return f"done: {name}"


if __name__ == "__main__":
    with ThreadPoolExecutor(
        max_workers=4
    ) as executor:
        futures = [
            executor.submit(
                task,
                name,
            )
            for name in [
                "A",
                "B",
                "C",
                "D",
            ]
        ]

        results = [
            future.result()
            for future in futures
        ]

    print(results)
这里:
executor.submit()会把多个任务提交到线程池。
future.result() 再等待结果。
把它用于 Tool
我们定义:
ToolCall然后:
registry.execute(call)每个调用提交到线程池。
一个完整并行 Tool Executor
这段代码已经具备:
多个 Tool Call
 ↓
线程池
 ↓
并发执行
 ↓
分别返回 ToolResult
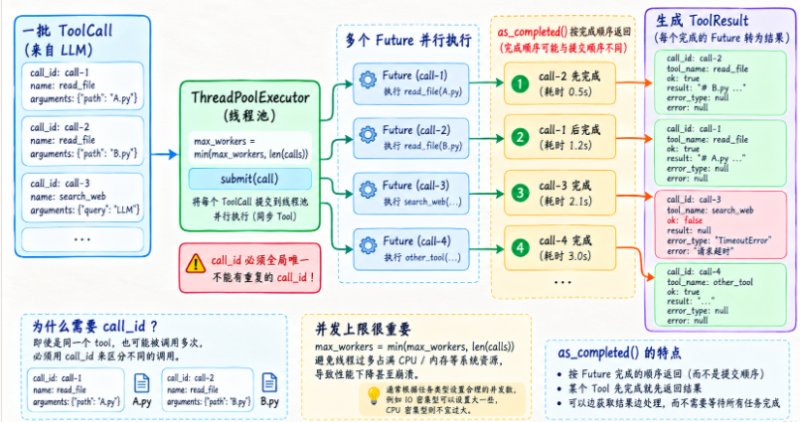
把 ThreadPoolExecutor 放回 Tool Calling 语境里看,核心动作就是把一批同步 Tool Call 分别提交为 Future,再按完成情况收集结果,并逐个还原成标准 ToolResult。
这里线程池只是“怎么同时跑”的机制,真正保证结果不会串线的仍然是 call_id。即使同一个 read_file 被调用四次、完成顺序完全不同,每个结果也必须能准确回到原来的请求。
为什么要 call_id?
因为并发时,完成顺序不一定等于提交顺序。
比如:
call-3可能最先完成。
所以不能只靠:
results[0]猜它对应哪个调用。
每个 Tool Call 最好有唯一:
call_id然后 Tool Result 也保留同一个 ID。
这样后面可以准确关联。
这在真实 Provider Tool Calling 里也非常重要。
并发以后,调用的提交顺序和完成顺序往往不一致,因此仅靠 Tool Name 根本不够。下面这个例子里两个调用都是 read_file,如果不保留 call_id,先返回的结果到底属于 A.py 还是 B.py 就会变得含糊。
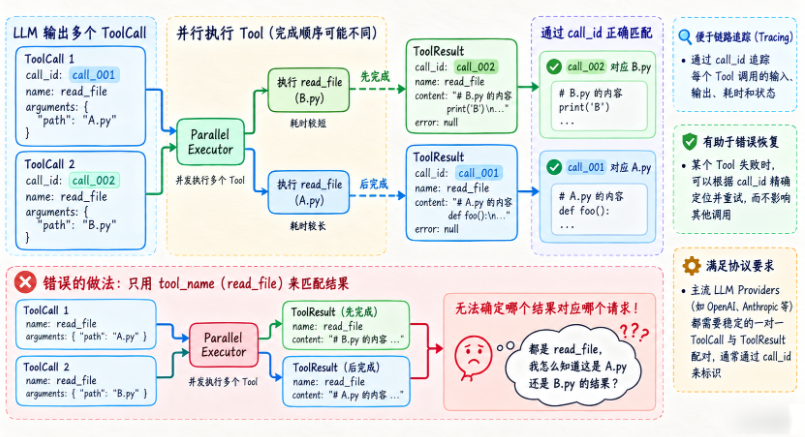
所以 call_id 最好从模型输出开始一路贯穿 ToolResult、Trace、Observation 和 Provider 回传。它不只是一个字段,而是整个并发链路里的关联键。
as_completed() 的意义
它会按,实际完成顺序
返回 Future。
这样某个任务先完成,就可以先处理。
如果我们只是:
for future in futures:
    future.result()
最终也能并发执行,但结果等待顺序固定。
as_completed() 更适合想逐个接收结果的场景。
因此上面的 execute_parallel() 返回的是完成顺序,而不是提交顺序。call_id 负责正确关联,两种顺序都可以;只是进入 Trace、测试快照或 Provider Tool Message 之前,我们最好明确采用哪一种,必要时再按原始调用顺序重排。不要一边依赖数组位置,一边又使用 as_completed()。
并行错误怎么处理?
比如:
README.md 成功
app.py 成功
requirements.txt 不存在
config.py 成功
整个批次不应该因为一个文件失败而全部失败。
所以我们需要,错误隔离。
每个 Tool 自己返回:
ToolResult(ok=False)最终聚合:
3 success
1 failed
再把整体 Observation 给 Agent。
模型可以决定:
requirements.txt 不存在,
是否需要搜索 pyproject.toml?
这就是并行 Error Recovery。
并行与上一节的 Retry 叠加时要更谨慎。8 个调用如果各自立即重试 3 次,会突然变成 24 次请求,原本的短暂限流可能被放大成重试风暴。除了每个调用的 Retry Budget,还要有批次级请求预算、统一退避和外部服务的速率限制。
并发上限为什么很重要?
不要:
max_workers=len(calls)无脑创建。
如果模型一次生成 100 个 Tool Call,就可能创建大量线程。
所以 Harness 要有:
MAX_PARALLEL_TOOLS例如:
4
8
根据资源确定。
模型不能决定无限并发。
这里的 max_workers 应来自 Harness 配置,而不是 Tool Call 参数。函数仍然校验它大于 0,并把实际线程数收敛为 min(max_workers, len(calls));模型一次提出很多调用时,执行器还可以分批排队,而不是为每个调用创建一个线程。
















请登录后查看评论内容