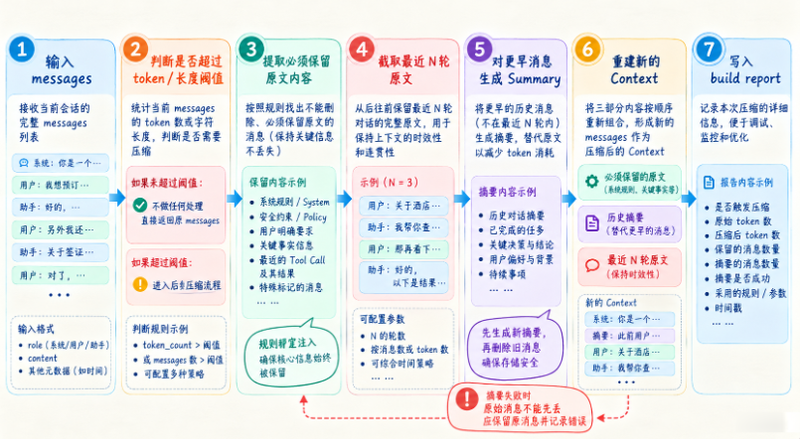


正式写代码前,先把执行流程在脑子里过一遍。下面这张流程图把 compact_context() 从输入 messages、判断阈值、提取必须保留内容、截取最近几轮、生成摘要、重建新 Context,到写入 build report 的完整链路都画出来了。
你可以把它理解成一条很实用的工程流水线:先判断要不要压,再决定保留哪些原文,最后才去摘要和重组。尤其图里标出来的那条原则很重要——新摘要要先生成成功,旧消息才能删除,否则一旦摘要失败,历史就真的丢了。
现在我们正式实现:
compact_context()先从不依赖真实 LLM 的版本开始。
为什么?
因为我们先要看清楚压缩流程。
真正的 Summary 以后可以让 LLM 生成,但 Harness 的控制流程应该独立存在。
我们先定义消息结构
{
    "role": "user",
    "content": "..."
}
然后把消息分成:
old_messages
recent_messages
例如:
总共 30 条
最近 8 条保留
前 22 条压缩
最简单的压缩器
可以先通过规则提取:
用户约束
错误
文件
工具结果中的关键内容
下面写一个完整可运行示例。
为了先看清摘要流程,下面处理的是已经扁平化的内部事件,工具观察用 kind="tool_observation" 标记;它不是可以直接发送给模型 API 的原生 Tool 协议。真正的 Assistant Tool Call 和 Tool Result 必须按 Call ID 成组处理,我们会在后面的工程实现里补上这层保护。
这段代码已经体现完整流程:
old_messages
 ↓
summary

recent_messages
 ↓
原样保留
真实 Agent 为什么适合让 LLM 做 Summary?
因为纯规则提取很难理解语义。
例如旧历史里:
用户最开始怀疑数据库
后来确认数据库没问题
真正应该保留的是:
数据库方向已排除而不是两句话都存。
LLM 很适合做这种语义压缩。
但这里必须强调,LLM Summary 也不是绝对可信。
所以高优先级规则不应该依赖 Summary 才保住。
例如:
禁止修改 tests/应该独立存进 Project Rules。
而不是期待 Compaction Model 每次都正确摘要。
一个更成熟的压缩接口
可以设计成:
compact_context(
    messages,
    working_memory,
    project_rules,
    keep_recent=8,
)
返回:
historical_summary
recent_messages
然后 ContextBuilder 重新组合:
System
Project Rules
Working Memory
Historical Summary
Recent Messages
Recent Tool Results
Current Task
为什么 Summary 应该有版本?
因为会发生多次压缩。
例如:
第 20 步压一次
第 40 步再压一次
第 60 步再压一次
可以保存:
summary_v1
summary_v2
summary_v3
或者只保留当前 historical_summary,旧版本写 Trace。
真实运行时:
Current Session
只保留最新 Summary

Trace
保留每次 Compaction Snapshot
这样方便复盘。















请登录后查看评论内容