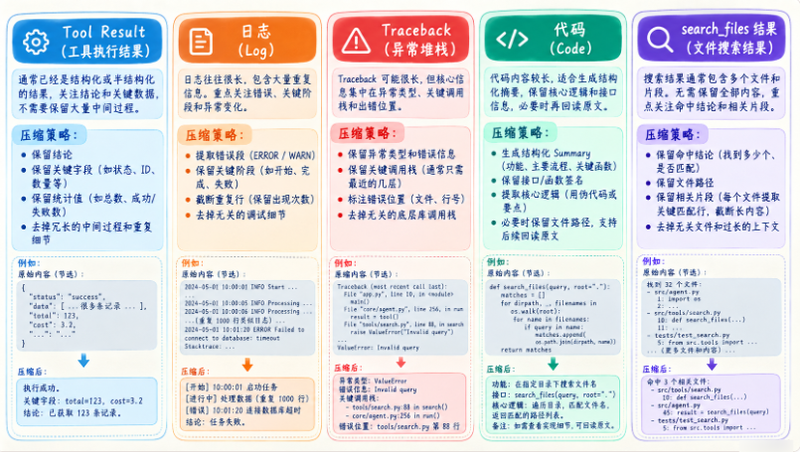


这一节非常适合边看图边往下读。因为真正做工程时,最容易踩坑的地方就是“所有内容都用同一种摘要方式处理”。但 Tool Result、Log、Traceback、Code、search_files 命中结果,它们的结构和用途完全不同,压缩策略也一定不同。
图里其实已经给了一个很清晰的判断原则:结构化结果看结论和关键字段,日志看阶段与错误,Traceback 看异常类型和关键调用栈,代码看结构化功能摘要,搜索结果看命中结论和关键片段。这样处理之后,压缩出来的内容才真的能继续服务后续推理。
这是 Context Compaction 真正最重要的工程部分。
很多系统只做:
旧消息摘要但 Agent 真正最占 Context 的往往不是 Conversation,而是 Tool Result。
所以必须按内容类型处理。
1. Tool Result 怎么压缩?
假设:
list_files返回 500 个文件。
下一轮真正需要的可能只是:
src/
tests/
config/
README.md
pyproject.toml
所以可以做:
完整结果
→ 保存到 Trace

Context 中
→ 只保留 top-level + relevant matches
例如:
Tool Summary:
项目包含 src/、tests/、config/;
入口候选 src/main.py;
依赖文件 pyproject.toml。
2. search_files 怎么压缩?
原始返回:
60 条 API_TOKEN 命中不需要全部带。
可以:
保留最相关 5~10 条
+
总命中数量
例如:
共 60 条命中。
关键位置:
- src/config.py:12
- src/api.py:38
- tests/test_api.py:17
这样模型知道,搜索结果很多,但核心位置在哪。
3. 日志怎么压缩?
最不推荐的是:
保留日志开头 4000 字因为真正异常常在最后。
日志更适合:
保留开头少量环境信息
+
最后 N 行
+
包含 ERROR / WARN / Traceback 的行
+
摘要
例如:
Command:
pytest -q

Result:
1 failed, 18 passed

Key Error:
ModuleNotFoundError: requests

Relevant Test:
tests/test_service.py::test_startup
比 500 行日志有用得多。
4. Traceback 怎么压缩?
完整 traceback 放 Trace。
给模型保留:
Exception Type
Exception Message
最后几层调用栈
与 workspace 相关的文件行
例如:
Exception:
ModuleNotFoundError: requests

Relevant Stack:
src/main.py:5
src/service.py:18
这样更聚焦。
5. 代码内容怎么压缩?
这是最难的一类。
代码不能简单“摘要成一句话”以后就永远丢掉。
因为如果后面要修改:
具体函数签名
变量名
调用关系
仍然需要原始代码。
更合理是三层。
第一层:
当前正在修改的文件
→ 保留相关代码片段原文
第二层:
已读但暂时不活跃的文件
→ 保留结构摘要
例如:
src/service.py
- Service.start()
- Service.stop()
- 依赖 API_TOKEN
- 调用 requests.get()
第三层:
原始全文
→ 不放当前 Context
→ 需要时再次 read_file
这非常关键。
Agent Tool 体系已经有:
read_file
search_files
所以没有必要永久背着所有代码全文。
一个简单代码压缩器
可以先用 AST 提取 Python 结构。
import ast


def summarize_python_code(
    code: str,
) -> str:
    tree = ast.parse(
        code
    )

    items = []

    for node in tree.body:
        if isinstance(
            node,
            ast.FunctionDef,
        ):
            args = [
                arg.arg
                for arg in node.args.args
            ]

            items.append(
                "function "
                + node.name
                + "("
                + ", ".join(args)
                + ")"
            )

        elif isinstance(
            node,
            ast.AsyncFunctionDef,
        ):
            items.append(
                "async function "
                + node.name
            )

        elif isinstance(
            node,
            ast.ClassDef,
        ):
            items.append(
                "class "
                + node.name
            )

        elif isinstance(
            node,
            (
                ast.Import,
                ast.ImportFrom,
            ),
        ):
            items.append(
                "import statement"
            )

    return "\n".join(
        f"- {item}"
        for item in items
    )


if __name__ == "__main__":
    sample_code = """
import requests

class Service:
    def start(self, token):
        return requests.get(
            "https://example.com",
            headers={"Authorization": token}
        )

def build_service():
    return Service()
"""

    print(
        summarize_python_code(
            sample_code
        )
    )
这个摘要很粗,但它说明了一个关键思路,代码压缩不一定只能让 LLM 总结,也可以利用程序结构。
代码什么时候必须重新读原文?
当下一步是:
edit_file
patch
精确定位 Bug
应该重新获取当前最新代码。
因为摘要可能已经过期。
尤其 Agent 刚刚修改过文件以后,旧 Summary 不能继续当作真实源码。
所以可以规定:
Summary 用于理解
Raw Code 用于修改
这是一条非常实用的工程原则。















请登录后查看评论内容