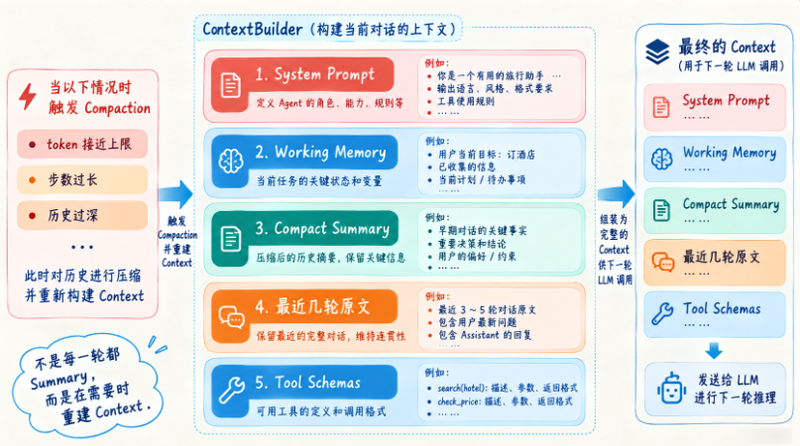


前面我们分别讲了“压什么”和“怎么压”,到这一节就要真正接进 ContextBuilder 里了。下面这张图把触发条件、ContextBuilder 内部的拼装块,以及最终送给 LLM 的 Context 全部放在了一起,看完之后你会对接入位置和运行时机更有感觉。
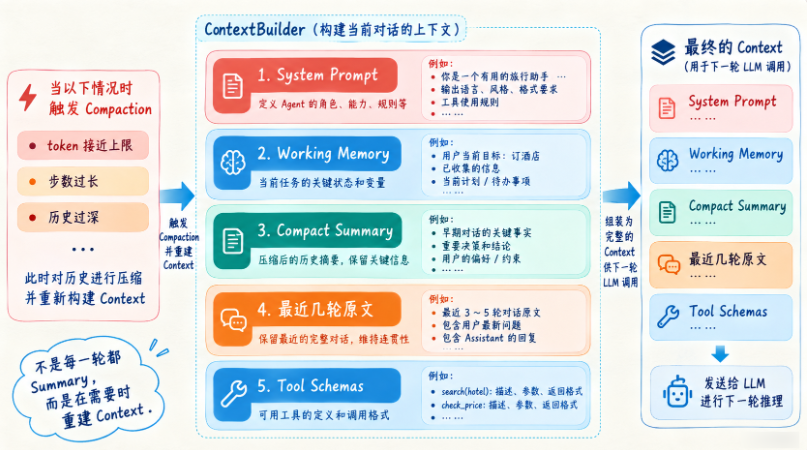
图里有一个点特别值得记住:不是每一轮都去做 Summary,而是在真的需要时才重建 Context。 也就是说,Compaction 本质上是一个按需触发的上下文重构动作,而不是每轮对话都必须执行的固定流程。
现在我们把前几节真正串起来。
当前有:
ContextUsage
ContextBuilder
WorkingMemory
Session
compact_context()
一个成熟流程可以变成:
Session
 ↓
ContextBuilder.build()
 ↓
估算 Input Token
 ↓
ContextUsage
 ↓
如果 >= 阈值
 ↓
compact_context()
 ↓
更新 historical_summary
 ↓
保留 recent_messages
 ↓
ContextBuilder 重新 build()
什么时候触发?
有三种常见策略。
第一种:
按 Token 使用率例如:
>= 80%
触发
第二种:
按消息数量例如:
messages > 40第三种:
按 Tool Result 体量例如:
累计 Tool Result > 50000 chars真实系统通常组合使用。
为什么不要每一轮都 Summary?
因为 Compaction 自己也有成本。
如果每轮都调用一个 Summary LLM:
成本增加
延迟增加
摘要反复重写
所以更适合,达到阈值时再压缩。
一个完整最小 Compaction Manager
下面做一个完全可运行版本。
这段代码实现了:
超过阈值
 ↓
把旧消息摘要
 ↓
保留最近 6 条
 ↓
Session 中只留 compacted summary + recent
为什么 Summary 自己也要限制长度?
因为如果每次 Compaction 都:
旧 Summary + 新 Summary无限拼接,Summary 最终也会爆。
所以 Summary 本身也需要再次压缩。
真实方案可以:
旧 Summary
+
新旧历史
 ↓
重新总结成新的统一 Summary
而不是简单字符串拼接。
课程这里用:
只保留合并摘要的最后 6000 个字符只是演示预算概念。
Compaction 后怎么验证没有“压坏”?
压完之后,不是“看起来短了”就算结束,更关键的是确认它还能不能支持后续任务继续推进。下面这张图左边是常见的验证清单,右边则是 Build Report 建议记录的关键字段,两部分放在一起看,会非常实用。
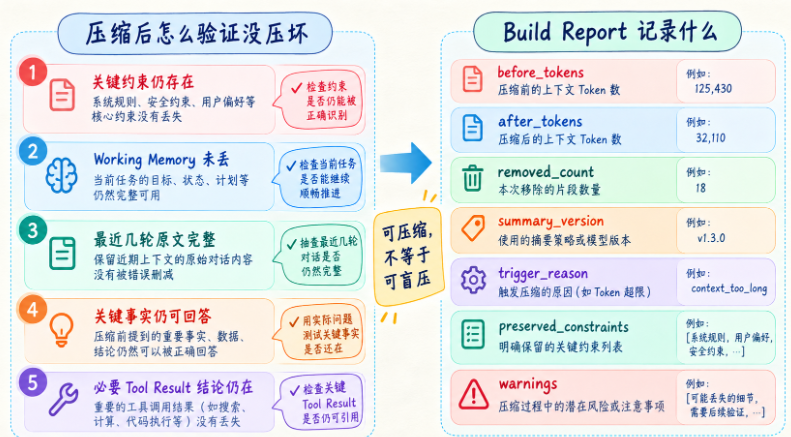
你会发现,真正需要检查的并不复杂:关键约束还在不在、Working Memory 有没有丢、最近几轮原文是否完整、关键事实还能不能回答、必要的 Tool Result 结论是否仍可引用。与此同时,把这些信息记录进 Build Report,后面排查“到底是压坏了,还是模型自己推错了”时会轻松很多。
这是非常重要的一步。
至少检查:
Goal 是否还在
硬约束是否还在
当前 unresolved errors 是否还在
重要文件是否还在
Current Task 是否还在
最近 Tool Result 是否还在
最好把这些放在:
Working Memory
Project Rules
Current Task
而不是只依赖 Summary。
因为 Summary 有信息损失。
压缩率高不代表压缩质量高。我们可以准备一组 Compaction 回归样例,逐项检查:硬约束召回率、未完成动作是否保留、关键数字和实体是否一致、事实与假设有没有串位、Tool 协议是否完整,以及压缩后的 Agent 能否继续完成同一任务。Token 从 80K 降到 8K 很漂亮,但如果“禁止修改 tests/”也一起消失,这次压缩仍然是不合格的。
数值、文件路径、错误码这类信息尤其适合做确定性校验。摘要生成后可以从原记录和摘要中抽取这些关键字段进行比对;发现冲突时宁可保留更多原文,也不要让一份看起来流畅的摘要覆盖证据。
Build Report 还应该记录什么?
可以增加:
compaction_triggered
before_tokens
after_tokens
compressed_messages
summary_size
以后 Tracing 可以看到:
Before: 82K
After: 31K
Saved: 51K
这就非常有价值。
压缩之前,先列出不能丢失的东西
我们先从一段真实轨迹挑出三类材料:仍然生效的约束、已验证且影响下一步的发现、尚未完成的动作。再把重复日志和已结束的探索过程压缩。最近消息并不天然更重要,最早的用户限制可能仍控制整个任务;总结应保留它的原始来源。
工具消息也需要成组处理。模型发出两次调用后,结果与调用标识存在关联;仅按最后六条消息切片,可能保留结果却丢掉请求。压缩器应在完整交互边界切分,或按接口支持的机制处理历史,避免生成协议不合法的下一轮请求。
压缩最好按“生成候选摘要 → 校验 → 提交替换”三步完成,而不是先删除旧消息再尝试总结。校验失败、模型超时或摘要反而更长时,我们仍能继续使用旧 Context,或者退回确定性的裁剪策略。原始轨迹、摘要版本和覆盖的消息范围都写进 Trace,后面才能知道一条结论是从哪些记录压出来的。
配套 compact_messages() 已经从简单截断升级为按完整交互单元处理:System Rules 和 Working Memory 独立保留;Assistant Tool Call 与对应 Tool Result 要么一起留下,要么一起进入历史摘要;摘要作为普通上下文数据,不会被提升成 System 指令。如果工具结果失去对应的 Call ID,压缩器会明确报错,而不是构造一份协议不合法的请求。
压缩器还会比较重建前后的估算 Token。如果加上摘要标签以后反而更长,就直接返回原 Context,并把 compacted_count 保持为 0。短历史本来就没有必要硬压;“调用了 compact”不代表一定要改写状态。
它仍然是一套确定性教学摘要器,不会真正理解“哪个业务结论最重要”。生产版可以把旧交互单元交给专门的 Summarizer,但仍要由 Harness 控制输入边界、输出 Schema 和验证规则。尤其要防止摘要模型把外部日志里的指令当成自己的任务,或把“可能是依赖问题”改写成“已确认依赖问题”。
在配套项目里运行 Compaction
相关实现位于:
src/agent_harness/context/compaction.py
src/agent_harness/context/builder.py
projects/05_context_memory_session/main.py
进入 agent_harness_course_projects 后运行:
python3 --version
python3 projects/05_context_memory_session/main.py
示例先输出 Context Usage,再把较早的历史压成 COMPACTED HISTORY,同时保留 System、Working Memory 和最近交互。课程代码统一按 Python 3.9 编写。这里的 keep_recent 计算的是完整交互单元,不是裸消息条数;一次 Assistant Tool Call 加上多个 Tool Result 属于同一个单元,不会从中间切断。
动手做一份压缩前后对照
给历史加入“禁止修改 tests”、一次失败查询和一个尚未完成的工具请求,然后压缩。参考验收是:禁止项仍可见,失败原因没有被改成成功,工具请求与结果关系完整,原记录仍能找回。只比较 Token 是否减少,还不足以判断压缩质量。
如果“尚未完成”意味着 Tool Call 还没有对应结果,此时不应该为了凑出下一轮请求而伪造结果。更稳妥的做法是先等待工具完成或恢复执行检查点;只有准备发送给模型的协议消息组完整后,才进入下一次模型调用。















请登录后查看评论内容