

这一部分最容易被误解,所以我专门补了一张说明图。图的中心是“HTTP API 作为服务协议”,周围围绕着语言解耦、部署解耦、API 版本化、统一鉴权与审计、错误标准化,以及 Streaming 支持几个关键点。
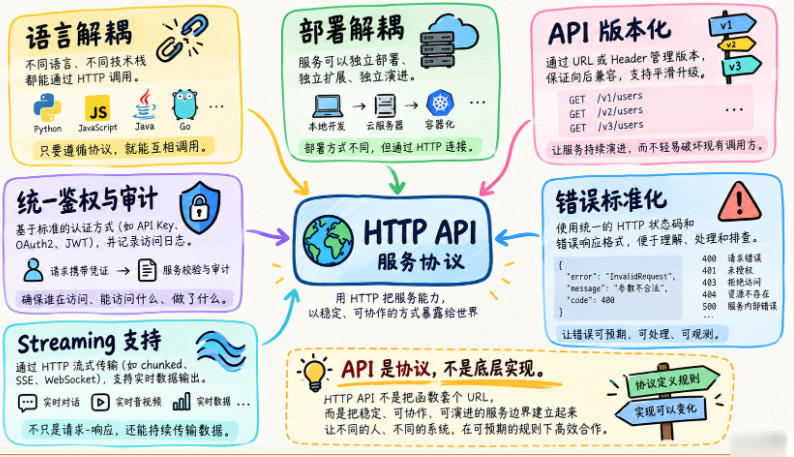
如图能很直观地看出来,HTTP API 的价值远不止“把函数放到网络上”。它更像是在系统之间建立一套稳定规则:不同语言可以调用、部署方式可以分离、版本可以平滑升级、错误可以标准化处理、流式输出也能有统一边界。换句话说,API 是协议,不是底层实现本身。
从最表面看,HTTP API 只是:
Request
 ↓
Python Function
 ↓
JSON
但它真正带来的,是系统解耦。
语言解耦
调用方可以是任意语言。
前端:
fetchJava:
HTTP ClientGo:
net/http飞书:
Webhook都能调用。
它们完全不需要知道你的 Python 类结构。
部署解耦
Agent Server 可以单独部署。
例如:
agent.internal前端在另一台机器。
飞书在公网。
数据平台又在别的服务。
只要网络可达即可。
未来 Agent 内部从某个 Provider 换到另一个 Provider,客户端也不用知道。
API 版本化
真实接口常见:
/api/v1/chat以后协议变化,可以:
/api/v2/chat旧客户端暂时继续用 v1。
这比所有调用方直接 import Python 类稳定很多。
统一鉴权与审计
HTTP 层可以统一加入:
Authentication
Authorization
Request ID
Rate Limit
Audit
AgentEngine 不应该自己处理所有 Web 鉴权细节。
它更应该接收已经验证后的调用上下文。
尤其不要直接相信 Body 里的 user_id、workspace 或 role="admin"。认证回答“调用者是谁”,授权回答“他能操作哪个 Session、Workspace 和 Memory”。Route 或网关完成认证后,把可信身份传给 Service;Service 再做资源级授权。只验证用户已登录,却不检查 Run 属于谁,仍然可能形成越权读取。
错误标准化
本地脚本可以直接看到:
KeyError
ValueError
RuntimeError
外部客户端需要的是稳定协议。
例如:
{
  "error": {
    "code": "SESSION_NOT_FOUND",
    "message": "session does not exist"
  }
}
配合:
404
400
500
客户端才知道怎么处理。
错误返回也要控制信息边界。客户端需要可处理的 code、简洁 message 和用于排查的 request_id,不需要服务器文件路径、环境变量或完整 traceback。详细堆栈留在服务端 Trace,并用同一个 request_id 关联。
Streaming 也依赖服务入口
Agent 如果运行很久,用户不希望看到:
Loading...持续一分钟。
后面我们会通过 SSE 把:
正在读取项目
正在运行测试
发现错误
正在重试
实时发回。
这种交互能力只有服务层真正建立以后才容易实现。
API 是协议,不是底层实现
今天:
POST /api/v1/chat
→ 同步执行 Agent
未来可能:
POST /api/v1/runs
→ 创建异步 Run
→ Worker 执行
只要对外协议设计稳定,内部实现可以继续演进。
这也是服务化最大的价值之一,把“怎么调用”与“内部怎么跑”分开。
HTTP 重试不等于“只执行一次”
这里单靠文字说,很多同学还是容易把问题想轻了。下面这张时序图把过程展开了:客户端第一次 POST /runs 之后,服务端其实已经创建了 Run A 并开始执行,但客户端因为超时没拿到响应,于是又重试一次,结果服务端再创建了一个 Run B,同样的任务被执行了两遍。
这也是为什么服务化以后,经常要配幂等键、请求 ID、去重策略以及状态查询接口。问题不在于“客户端为什么手欠重试”,而在于HTTP 超时和任务是否已经创建成功,本来就是两回事。
一次请求可能已经到达服务器,只是响应在回程丢了。客户端看到超时后重试,服务端便可能创建两个 Run、重复发消息,甚至重复执行写操作。
因此“创建任务”类接口通常需要接受 Idempotency-Key,并在同一调用者和同一接口范围内保存第一次创建的结果。收到相同 Key 时返回原来的 run_id,而不是再启动一遍。request_id 用于追踪一次请求,idempotency_key 用于识别一次业务提交,两者不要混为一谈。
这部分会在 Run 生命周期中继续实现。现在先记住一个边界:HTTP 让调用变得统一,却没有承诺 exactly-once;超时也只代表客户端没有及时收到答案,不代表 Agent 一定没有开始执行。















请登录后查看评论内容