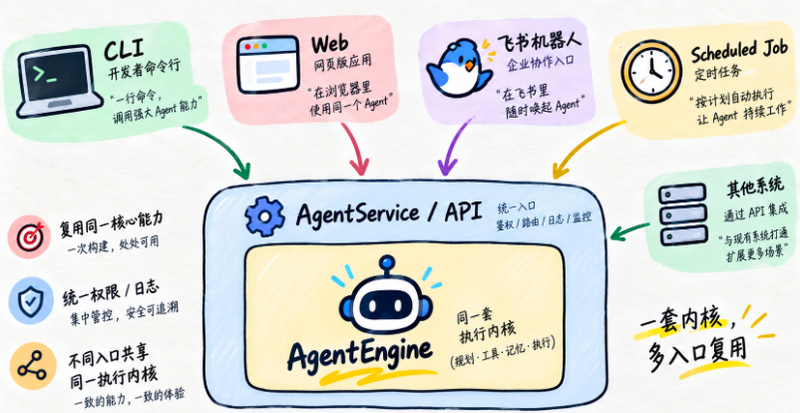


这一部分其实和前面的“不要复制 Agent”是同一个思想,只不过这里更强调入口视角。下面这张图把 CLI、Web、飞书机器人、定时任务和其他系统怎么一起接到统一入口上,画成了一个更完整的复用关系。
你可以把它理解成:对外入口可以很多,但内核最好只有一套。这样做,一方面减少重复建设,另一方面也让权限、日志、监控和对外协议都更统一。尤其是当业务场景不断增加时,这种设计会越来越值钱。
现在回到课程最核心的工程思想,AgentEngine 应该与调用入口无关。
它不应该关心:
当前请求来自浏览器?
来自飞书?
来自 CLI?
来自定时任务?
它只需要关心:
Task
State
Context
Tools
CLI 仍然保留
例如:
class AgentEngine:

    def run(
        self,
        task: str,
    ) -> str:
        return (
            "processed: "
            + task
        )


if __name__ == "__main__":
    engine = AgentEngine()

    print(
        engine.run(
            "分析这个项目"
        )
    )
这对于:
本地调试
自动化测试
开发排错
仍然很有价值。
Web 走 Service
Flask
 ↓
AgentService
 ↓
AgentEngine
飞书也走 Service
Feishu Event
 ↓
Feishu Adapter
 ↓
AgentService
 ↓
AgentEngine
Adapter 不只是“把文字转发进去”。它还要把各渠道不同的用户、会话和请求标识规范化,并验证 Webhook 签名、处理平台重试。飞书会话 ID、浏览器 Session ID 和 Agent 的 session_id 不一定是同一个概念,最好由映射层明确转换,别把外部 ID 直接当成内部权限边界。
定时任务也一样
Cron
 ↓
Scheduled Adapter
 ↓
AgentService
 ↓
AgentEngine
所以真正稳定的结构是:
             ┌─ CLI
             ├─ Flask
Client Layer ├─ Feishu
             └─ Cron
                  ↓
             AgentService
                  ↓
             AgentEngine
这和 LLM Provider 设计其实很像
前面我们做:
AgentEngine
 ↓
LLMProvider
 ↓
OpenAI / Claude / Local
现在做:
CLI / Web / Feishu
 ↓
AgentService
 ↓
AgentEngine两者本质都在做,隔离变化。
Provider 隔离模型厂商差异。
Service 隔离调用渠道差异。
服务化以后为什么 Session 突然非常重要?
因为 HTTP 请求天然是一条一条的。
第一次:
POST
message="帮我分析项目"
第二次:
POST
message="继续"
如果没有:
session_id服务器不知道“继续”指哪一个上下文。
所以前面 SessionManager 的设计,在这里终于从概念变成真实后端需求。
为什么后面还需要 Run?
聊到这里,Session 和 Run 的区别就必须单独说清楚了。下面这张图左边解释 Session:它表示“谁在聊”、维护连续对话和上下文;右边解释 Run:它表示“这次具体执行的任务”,关注任务状态、执行结果、可轮询和可追踪。
一个 Session 可以有多个 Run。也就是说,服务化以后,我们要把“会话归属”和“单次执行”拆开管理。Session 解决连续性,Run 解决执行生命周期,这样后面的状态追踪、重试、取消和审计才好做。
同一个 Session 里可能:
Run 1:先定位 Bug
Run 2:按方案修复
Run 3:重新验证
所以 session_id 不等于 run_id。
下一章开始,我们就会真正把这些 ID 放进 API。
从谁来调用,决定是否需要服务化
如果你还想把“函数调用”到“服务化”这件事看得再顺一点,这里可以配合下面这张七步图来理解。从本地 agent.run() 开始,逐步抽出输入输出、封装成 AgentEngine、再加上 AgentService、暴露 HTTP 接口,最后接上鉴权、日志、错误码、Session 和 Run 管理,才真正变成一个可复用服务。
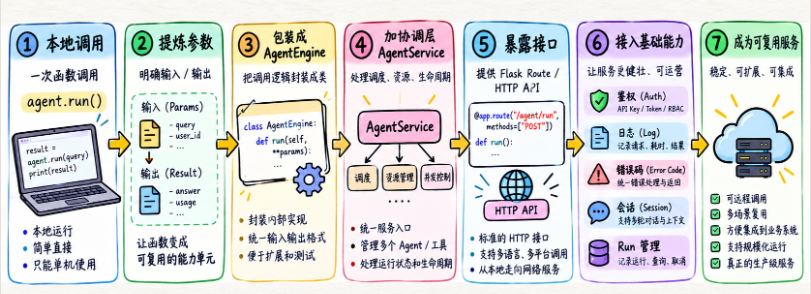
这张图的价值在于把“服务化”这件事拆开了。很多人一想到服务化就觉得很重,但真拆开看,其实它是一层层长出来的:先抽象调用边界,再补统一入口,最后补齐运维和多用户能力。
如果工具只供开发者在本机使用,CLI 可以长期作为正式入口。需要网页、机器人或其他服务共同调用时,我们才引入 HTTP API。这里要解决的是调用方式和运行生命周期,而不是认为 Python 脚本天然不适合工程使用。
Flask 可以承担生产 API,但开发服务器、请求内线程和后台任务的可靠性需要分别考虑。仅把 Flask 换成异步框架,也不会自动得到持久队列或崩溃恢复。我们先定义 AgentService 的提交、查询、取消入口,再选择合适的 Web 框架和 Worker 运行方式。
长任务通常先创建可查询的 Run,再交给执行器。客户端连接断开时,任务是否继续取决于产品约定;我们不应靠 HTTP 连接是否存在来猜测用户是否还需要结果。运行状态必须能独立于页面被检查。
这也帮助我们选择同步还是异步接口:几百毫秒就能完成的只读调用可以同步返回;执行时间不可预测、会调用多个 Tool 的 Agent 任务,更适合快速返回 202 Accepted + run_id。这里的 202 表示“已经接收”,不是“已经成功完成”。真正结果要通过查询、回调或 Streaming 获取。
动手划分:一次函数调用怎样成为服务
将原来的 agent.run(task) 分成提交与执行两步,提交返回 run_id,执行更新结果。参考验收是提交后可以独立查询状态,即便调用方不再等待也能取回结果。若状态仅保存在请求对象里,服务入口与运行状态还没有分开。















请登录后查看评论内容