

在正式看字段定义之前,先把整体结构放在脑子里。下面这张图把一个 Run 常见要保存的信息都铺开了。
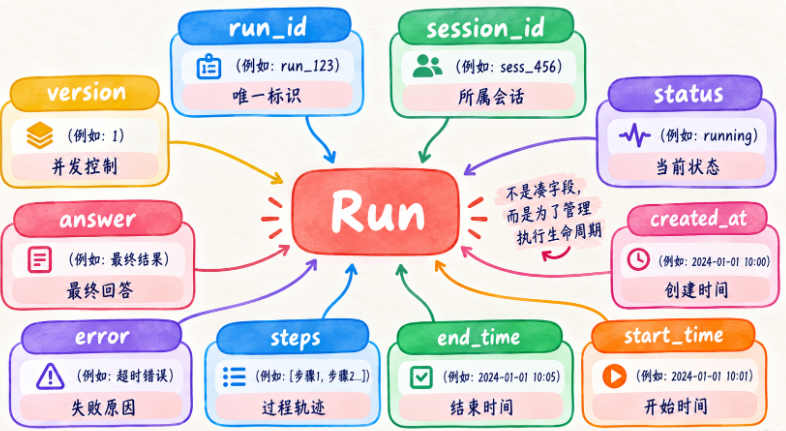
你会发现,这些字段并不是为了“把表凑满”,而是为了完整描述一次执行生命周期。run_id 用来唯一标识,session_id 说明它归属哪个会话,status、start_time、end_time 用来表达执行进展,steps 用来保留过程轨迹,error 让失败也能被结构化记录,answer 则承接最终输出。把这些字段想清楚,后面写 API、做观测和排错都会轻松很多。
现在正式设计:
run_id
session_id
status
created_at
start_time
end_time
steps
error
run_id
这一次任务执行的唯一 ID。
例如:
run_0f9c31841a未来几乎所有 Trace 都可以关联它:
LLM Calls
Tool Calls
Token
Latency
Error
Step
session_id
说明这个 Run 属于哪个 Session。
这让我们可以:
查询某个 Session 的全部 Runs也能知道,这次执行继承了哪段会话上下文。
session_id 只表达归属关系,不等于授权。查询 Run 时还要验证当前用户是否有权访问它所属的 Session。共享服务里,如果只凭猜到的 run_id 就能读取结果、Trace 或 Tool 参数,会形成典型的对象级越权。
status
最基础先有:
READY
RUNNING
COMPLETED
FAILED
状态不是装饰字段。
它是 Agent Backend 能否被可靠查询的核心。
created_at
Run 被系统接受并创建的时间。异步队列里,它通常早于真正执行时间。created_at → start_time 是排队耗时,start_time → end_time 才是执行耗时;如果只保留一个开始时间,两类延迟会混在一起。
start_time
什么时候真正开始执行。
注意:
created_at和:
start_time理论上也可以不同。
未来异步队列里:
12:00 创建 Run
12:02 Worker 才开始执行
教学版可以先从 start_time 开始,但课程项目的工程实现会同时保留 created_at,这样后面接 Worker 时不用重新解释等待时间从哪里来。
end_time
只有终态才设置:
COMPLETED
FAILED
如果:
RUNNING则:
end_time = Nonesteps
Run 不是一个黑盒。
Agent 的价值就在于多步执行。
所以需要记录:
Step 1
Step 2
...
本节可以先保存简单 RunStep。
后面 Tracing 会进一步丰富:
prompt
tool
arguments
observation
latency
token
error
成功时:
None失败时:
结构化错误比如:
ProviderTimeout
ToolExecutionError
MaxStepsExceeded
最好不要只保存一个巨大 traceback 字符串。
外部 Run 对象保存:
error_type
message
完整 traceback 写日志或 Trace。
还要区分“给客户端看的错误”和“给维护者看的诊断”。Run 中可以保存稳定 code 与脱敏 message;堆栈、Provider 原始响应和内部路径进入受控 Trace。否则 GET Run 虽然方便,却可能顺手变成信息泄露接口。
设计 RunStep
from __future__ import annotations

from dataclasses import dataclass, field
from datetime import datetime, timezone
from typing import Any


def utc_now() -> str:
    return datetime.now(
        timezone.utc
    ).isoformat()


@dataclass
class RunStep:
    step: int
    kind: str
    detail: str
    created_at: str = field(
        default_factory=utc_now
    )


@dataclass
class Run:
    run_id: str
    session_id: str
    status: str = "READY"
    start_time: str | None = None
    end_time: str | None = None
    steps: list[RunStep] = field(
        default_factory=list
    )
    error: dict[str, Any] | None = None
为什么 Step 不只存一个整数?
如果:
steps = 12我们只知道执行了 12 步。
不知道做了什么。
而:
RunStep(
    step=3,
    kind="tool",
    detail="read_file: src/app.py"
)
就有了基本可观察性。
Run 数据结构要不要保存 answer?
可以。
真实系统经常会有:
result
answer
output
但用户本节明确核心字段没有要求,我们先保留在 API Service 返回层。
后续 Run 对象可以继续扩展:
result
metadata
usage
状态应该用常量
不要到处写:
"running"
"RUNNING"
"runing"
可以定义:
class RunStatus:
    READY = "ready"
    RUNNING = "running"
    COMPLETED = "completed"
    FAILED = "failed"
这样更稳定。
项目代码进一步使用 class RunStatus(str, Enum)。它既能约束状态集合,又能自然序列化成字符串,比散落的常量更适合贯穿 Service、存储和 API。
















请登录后查看评论内容