

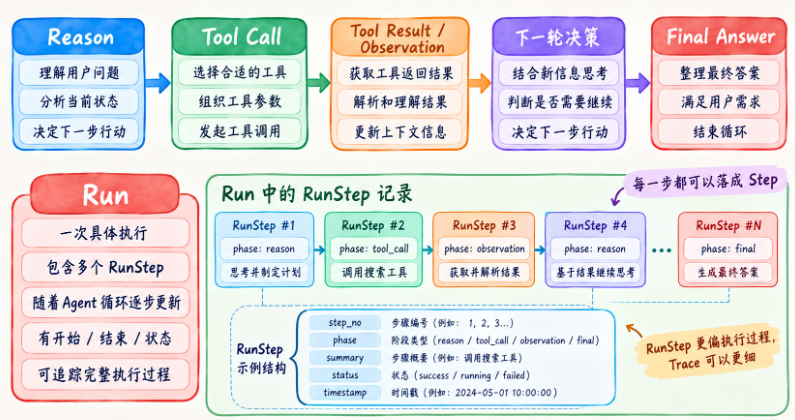
图里上半部分展示的是 Agent 的典型循环:Reason、Tool Call、Observation、再决策,最后输出 Final Answer。下半部分则把它转换成 Run 内部的一串 RunStep 记录。也就是说,每走一步循环,都可以同步形成一个 RunStep。这样做的价值很大:你不只是知道“结果是什么”,还知道“它是怎么一步步走到这个结果的”。后面再做追踪、可观测性甚至人工介入时,这个设计都会非常有用。
本节 Step 还很简单。
但要意识到,Run 最终会成为 Main Loop 的外层“执行容器”。
例如:
Run
 ├─ Step 1 Reason
 ├─ Step 2 Tool Call
 ├─ Step 3 Observation
 ├─ Step 4 Reason
 ├─ Step 5 Tool Call
 └─ Step 6 Final
这与前面 Main Loop 完全接上。
每一个 Loop Step 都可以写 Run
伪代码:
while True:
    response = provider.chat(...)

    run_manager.add_step(
        run_id,
        kind="llm",
        detail="model responded",
    )

    if response.tool_call:
        run_manager.add_step(
            run_id,
            kind="tool_call",
            detail=...,
        )

        result = execute_tool(...)

        run_manager.add_step(
            run_id,
            kind="observation",
            detail=...,
        )
这就是后面 Tracing 的基础。
Run Step 和 Trace 有什么区别?
本章 RunStep 只是轻量记录:
第几步
类型
简单详情
时间
后面的 Trace 会更丰富:
Prompt
LLM Response
Tool Arguments
Tool Result
Latency
Token
Status
可以理解:
Run
= 任务生命周期

Trace
= 任务执行证据
二者有关联,但不是一回事。
为什么 Run 应该知道 error?
因为前端查询时需要快速知道:
FAILED
为什么失败
无需先翻完整 Trace。
所以 Run 保存:
{
  "type": "ProviderTimeout",
  "message": "model request timed out"
}
就够。
完整 traceback 留服务端。
Step 详情也不是越完整越好。Tool Result 可能包含整份文件、查询数据或敏感字段,直接塞进每个 Run 会让查询接口越来越重。RunStep 保留短摘要与状态,较大的输入输出保存为 Artifact 或 Trace 引用,这样列表和状态查询仍然轻量。
MAX_STEPS 也应该变成 Run Failed
比如后面 Agent 超过最大步数:
MaxStepsExceeded不要让进程直接崩掉。
应该:
Run.status = failed
Run.error = ...
Run.end_time = ...
这就是生命周期思维。
从产品语义看,预算耗尽最好使用独立的 budget_exceeded,而不是全部折叠成普通 failed。它能告诉用户任务不是业务逻辑报错,而是触发了最大步数、Tool 次数、Token 或时间预算;是否扩大预算后重试,也更容易由上层明确决定。
用户点了取消,工具可能已经开始执行
取消逻辑是工程里很容易被低估的一块。很多人以为点了取消就等于立刻停止,但真正落到 Agent 执行链路上,中间通常还会有一个过程。
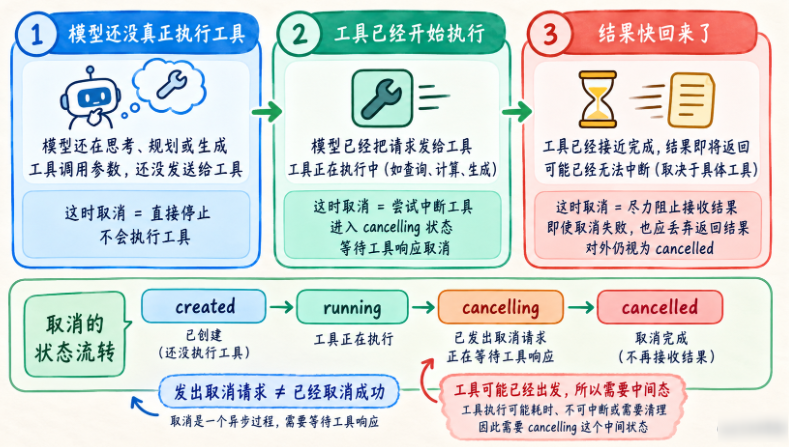
如图就把三个阶段拆得很清楚:工具还没真正执行时,取消相对简单;工具已经开始执行时,就需要进入 cancelling 这种中间态等待反馈;结果快返回时,即使外部已经点了取消,也可能只能选择丢弃结果并把对外状态视为 cancelled。所以这里最需要记住的一点是:发出取消请求,不等于已经取消成功。 这也是为什么 cancelling 和 cancelled 最好分开。
我们把取消放到时间线上:模型返回动作、工具开始执行、用户点击取消、工具返回结果。用户请求可以立刻被记录,但已经发生的文件写入不会因此自动撤销。Run 应明确区分取消已请求、停止已确认,以及停止前已经发生的影响。
可协作取消的工具可以在阶段边界检查信号;子进程则需要管理进程组和清理资源。对于暂时无法中断的调用,可以等待它返回并阻止后续动作,报告已完成部分。配套服务会在每个 Agent 工具调用前检查取消,并在 Trace 进度与步骤边界续租;已经开始的工具仍可能先返回,所以这里承诺的是“下一安全边界停止”,不是强行打断所有正在运行的调用。
恢复也需要动作日志。若进程在工具提交后、结果落盘前退出,重启时可能不知道副作用是否发生。我们要查询外部状态或使用幂等结果记录,不能直接从“上一个 step”再跑一次。完成和取消竞争时,由明确的状态转换规则决定最终状态。
服务重启后,谁来处理遗留的 running?
持久化 Run 以后还会出现“孤儿状态”:Worker 已经崩溃,数据库里却仍写着 running。仅有数据库并不会自动修复它。真实执行器通常记录 Worker Lease、Heartbeat 或最后进展时间;恢复任务扫描超过阈值且没有有效 Lease 的 Run,再根据动作日志选择继续、标记失败,或进入 recovery_required 等待人工判断。
这里尤其不能见到旧 running 就从最后一步无脑重跑。读文件通常可以重试,付款、发消息、删文件或提交审批却可能已经产生副作用。是否恢复必须结合 Tool 的幂等性和外部查询能力。
动手推演:在三个位置取消
分别在工具开始前、工具执行中、任务完成后请求取消。参考验收是第一种不执行工具,第二种如实报告停止时机及已发生影响,第三种保持原终态。尤其不要把已经交付完成的任务改写成“从未完成”。
















请登录后查看评论内容