

这个案例在真实项目里特别常见:任务其实已经失败了,但状态却没有被正确写回,最终调用方只会一直看到一个悬空的 running。下面这张对比图正好把问题讲透了。
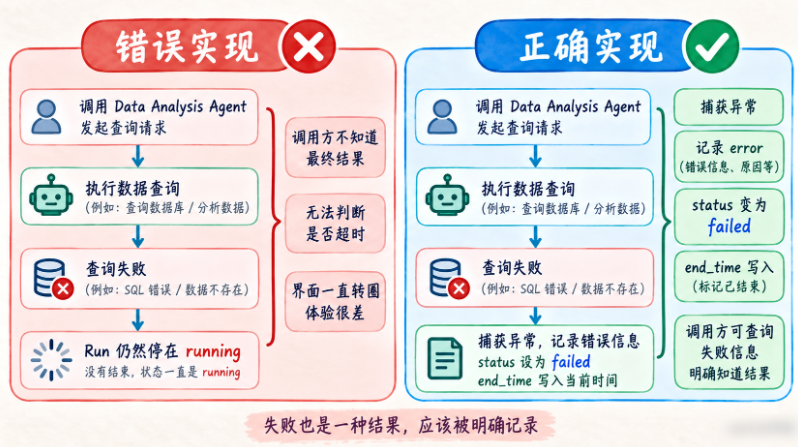
左边是不太合理的实现:查询失败以后,没有把异常收口进 Run,导致调用方既不知道最终结果,也很难判断是不是超时。右边是更稳妥的做法:捕获异常、写入 error、把 status 改成 failed、同时补上 end_time。这样一来,失败也成为了一种可查询、可解释、可追踪的结果,而不是一个永远停在执行中的“半成品状态”。
场景背景
用户,“分析昨天收入下降。”
创建:
run_ads_001Run:
READY
↓
RUNNING
执行到第 4 步:
query_metric结果数据库连接失败:
TimeoutError错误实现
代码直接抛 Exception。
HTTP 500。
但没有更新 Run。
于是:
run_ads_001.status仍然:
running前端 10 分钟后查询:
还在 running这是典型的“幽灵任务”。
正确实现
异常捕获后:
status = failed
end_time = now
error = {
  type: TimeoutError,
  message: query timed out
}
结果
用户明确知道,任务已经结束,只是失败了。
监控系统也可以统计:
Run Failure Rate复盘
Run 生命周期真正解决的是,任务状态不能靠猜。
Backend 必须明确记录:
现在是什么状态
什么时候开始
什么时候结束
为什么失败
常见误区
这一章到这里,其实已经有几类特别典型的误解反复出现了。先用一张对照图,把这些坑集中梳理一下。
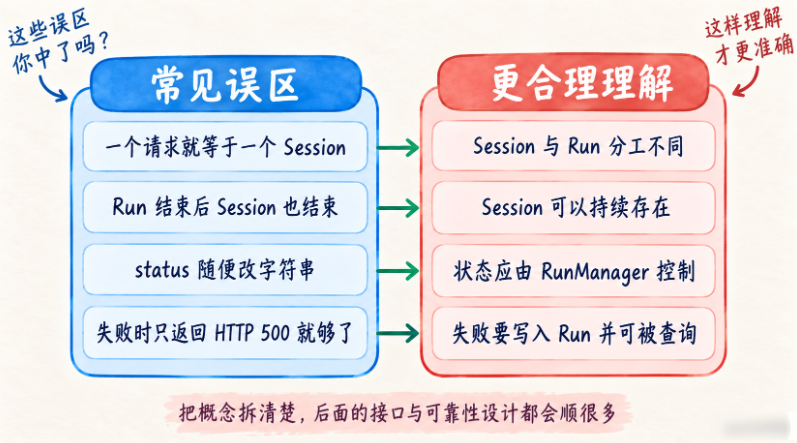
这张图特别适合在读完整章后回头再看一遍。左边列的是很多项目刚起步时很容易踩进去的误区,比如把一个请求直接等同于一个 Session,或者觉得失败时只要返回 HTTP 500 就够了;右边则对应更工程化的理解。把这些概念拆清楚,后面无论是设计状态机、做 API、还是补齐可靠性能力,整体思路都会顺很多。
常见误区
误解: Session 和 Run 都是 ID,直接用一个 ID 最简单。
正解: Session 表示一段持续会话,一个 Session 里可以连续执行多个不同任务;Run 表示其中一次具体执行。用户先分析、再修改、再验证,可以属于同一 Session,但应有三个 Run。否则时间、错误、Step、成本都会混在一起,后面无法准确观测和追踪。
误解: Run 只有成功和失败两个状态就够了。
正解: 成熟系统至少需要区分“还没开始”“正在执行”“已经成功”“已经失败”。后面还会加入 WAITING_APPROVAL 等状态。状态越明确,客户端越容易知道当前应该等待、重试、展示结果还是要求人工操作。布尔 success 无法表达执行过程。
误解: HTTP 请求失败了,Run 自然就算失败,不需要额外更新状态。
正解: HTTP 只是调用协议,Run 是业务对象。如果代码抛异常后没有显式把 Run 从 RUNNING 改为 FAILED,那么数据库或内存中的状态可能永远停在 running。正确做法是无论异常发生在哪一层,都确保 Run 写入 end_time、failed 状态和结构化 error。
误解: steps 只需要保存一个计数器,例如 steps=12。
正解: 计数器只能告诉你“执行了多少步”,无法回答“第 8 步做了什么”。本章先用轻量 RunStep 保存 step、kind、detail、created_at,后续 Tracing 再扩展 Prompt、Tool 参数、Observation、Latency 和 Token。Step 是 Agent 可观察性的入口。
误解: Run completed 后应该顺便 close Session。
正解: Run 结束只表示这一次任务完成,用户完全可能继续在同一 Session 中追问或创建新 Run。Session 生命周期通常更长,只有用户主动关闭、系统过期或明确业务规则才结束。把 Run 与 Session 生命周期绑定,会破坏多轮交互。
误解: 现在 POST /runs 还是同步执行,所以设计 Run 没意义,等异步时再做即可。
正解: Run 的价值不只在异步。同步任务同样需要唯一 ID、时间、状态、Steps 和 Error,用于日志关联、调试与 Trace。先把 Run 数据模型和 API 设计好,以后从同步执行升级到 Worker/Queue 时,外部协议可以基本保持不变。
误解: 用户点击取消后,可以立刻把 Run 标成 cancelled。
正解: 对正在执行的任务,点击取消只说明意图已经送达,更准确的中间状态是 cancelling。执行器确认不会继续运行后才能进入 cancelled。若工具已经产生副作用或任务在竞争中先完成,系统要如实保留结果,不能把历史改写成“从未执行”。
误解: Run 已经持久化到数据库,服务重启后就会自动恢复。
正解: 数据库只能保留记录,不能判断旧 running 对应的 Worker 是否仍活着。需要 Lease、Heartbeat 或最后进展时间识别孤儿 Run,并结合 Tool 幂等性决定继续、失败还是人工恢复。对有副作用的动作,无脑重跑最后一步可能造成重复执行。
误解: 失败后重试,直接把原 Run 从 failed 改回 running 最省事。
正解: 终态应该保留为不可变历史。重试创建新的 Run,并通过 retry_of 或 parent_run_id 关联原 Run。这样每次尝试的输入、耗时、错误、审批和副作用都能独立审计。
误解: RunStep 里保存完整 Prompt、文件和 Tool Result,排查最方便。
正解: RunStep 适合做轻量进度索引。巨大或敏感数据进入受控 Trace / Artifact,Step 只保存摘要、状态和引用。否则每次 GET Run 都会搬运大对象,还可能把不该对客户端开放的数据一起返回。
















请登录后查看评论内容