

这一点一定要讲清楚。
很多人一听 Streaming,就想:
把模型每一句内部推理都实时输出这不是一个好的产品边界。
用户需要的是“进度”
例如:
正在读取项目
正在运行测试
发现 ImportError
正在重试
这些能帮助用户理解,Agent 当前在做什么。
用户不需要的是“全部内部细节”
例如:
完整 System Prompt
完整模型中间推理
完整 Tool Schema
完整 traceback
全部 Token 统计
全部原始 SQL
这些更适合 Trace。
可以把事件分成几类
推荐:
run.started
run.progress
tool.started
tool.completed
run.warning
run.failed
run.completed
例如:
{
  "event": "tool.started",
  "data": {
    "tool": "run_shell",
    "message": "正在运行测试"
  }
}
这比只发纯字符串更容易扩展。
事件名一旦被前端使用,就已经属于 API 合同。我们可以在 payload 里保留 schema_version,以后新增字段尽量保持向后兼容:
{
  "schema_version": 1,
  "run_id": "run_xxx",
  "step": 4,
  "status": "running",
  "message": "正在运行测试"
}
注意不要把数据库状态、Python 类名和前端事件名绑死。内部实现可以重构,公开事件合同应保持稳定;真的需要破坏性调整时,再升级版本。
为什么不要把原始 Tool Result 全发前端?
比如 pytest 输出 500 行。
如果 SSE 全量推:
前端很乱
网络流量大
用户看不懂
可能泄露内部信息
更合适:
测试完成:1 failed, 18 passed
发现 ImportError: requests
详细日志在需要时另开:
Trace 页面
Run Detail
Streaming Event 应该是“产品层摘要”
可以理解:
Trace
→ 面向工程师

Streaming
→ 面向当前用户
同一个 RunStep 可以生成两种表示。
这也是后面 Observability 章节会继续深化的地方。
这个产品边界如果只靠文字很容易越做越模糊。更直观的理解是:同一份真实执行事实,可以同时生成用户视图和工程视图,但两边的信息密度完全不同。
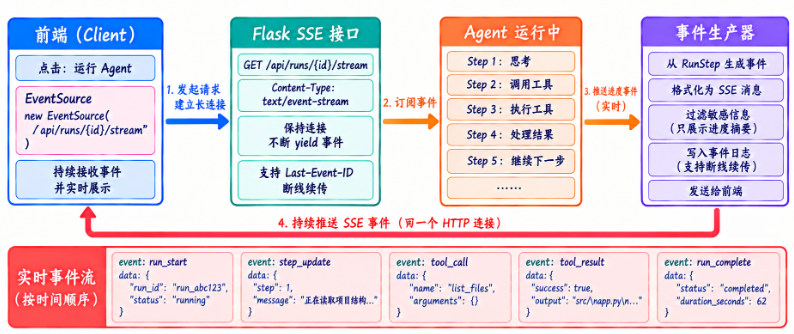
前端事件要帮助用户理解“现在在做什么”;Trace 则要帮助工程师回答“为什么会这样”。来源可以一致,但绝不能因为做了 Streaming,就把完整内部证据原样暴露出去。
进度事件流,不等于模型 Token 流
Streaming 还有一种常见含义:模型每生成一小段文字,就发送一个 token.delta。它和我们这一节的 run.progress 不是同一类数据:
run.progress
→ 低频、结构化、描述任务走到哪里

token.delta
→ 高频、临时、拼接最终回答
两者可以走同一个 SSE 连接,但消费策略不能混在一起。进度事件适合持久化和断线回放;Token 增量数量大,重放和去重更复杂,慢客户端还可能跟不上生成速度。实际项目通常会合并过细的 delta、限制缓冲区,并把最终回答作为一条独立的持久化结果保存。
还有一条边界不能省:Token 流只是最终回答的增量输出,不应该拿来暴露模型内部推理。我们展示可交付内容和可理解的执行进度,内部思考仍然留在系统边界之内。
如果未来同时做回答 Token 流,可以把它和进度事件放在同一条 SSE 连接里,但消费逻辑要明确分开。进度事件是低频、结构化状态;Token 增量则是高频文本片段。
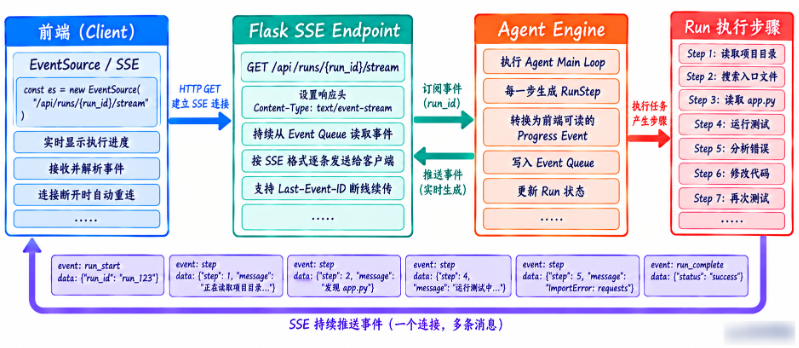
前者很适合逐条持久化和重放,后者则更关心合并、顺序、缓冲和客户端处理速度。最终答案仍应该独立保存,不能只依赖浏览器当时收到的 delta。
把历史回放与实时订阅接在一起
前面的内存队列帮助我们看清了链路,但它不能支持可靠重连和多个订阅者。配套项目已经把这一层补成了“SQLite 事件日志 + 独立游标 + 实时等待”:RunService.stream_events() 先按 Last-Event-ID 补发缺失事件;暂时没有新事件而 Run 仍在执行时,通过条件变量等待 Worker 通知;等待超时则发送一个 heartbeat。
发现任务终态后,服务端不会立刻粗暴断开。它会先发送尚未读取的终态事件,再自然结束流。每次从 SQLite 最多读取有限批次,发送完再推进游标,这样历史很长或客户端很慢时,也不会一次把全部事件堆进内存。
这里的 heartbeat 没有事件 ID,也不增加 RunStep。它只是告诉浏览器和中间代理“连接还活着”;真正可恢复的进度仍以 SQLite 中带 ID 的业务事件为准。接口同时返回 Cache-Control: no-cache 和 X-Accel-Buffering: no,尽量减少被代理缓冲成一次性输出的情况。
长步骤时这个区别尤其重要。例如 pytest 可能 60 秒没有新的业务进度,但连接不能因此看起来像“死掉了”。heartbeat 可以维持传输链路,却不应该伪装成 Agent 又完成了一个 Step。
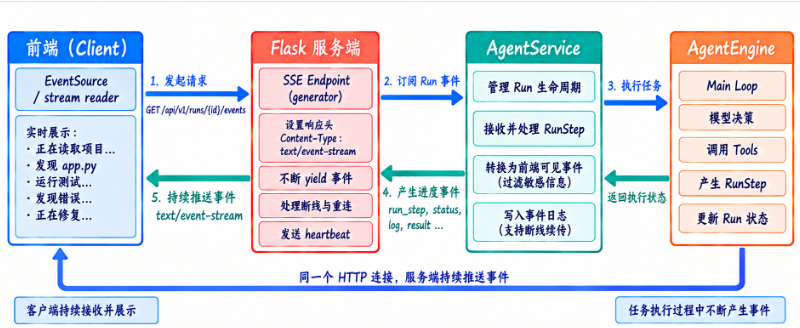
所以 heartbeat 属于传输层;run.progress、tool.completed 这类才属于业务事件层。两者分开以后,RunStep 计数、断线回放和前端进度都会更准确。
重连可能重复收到最后一条事件,客户端仍要按 ID 去重。不同客户端各自维护游标,从同一份持久化日志读取,不会像共享 Queue 那样抢走彼此的事件。页面中的 EventSource 负责正常实时更新,并保留较低频率的状态对账;这样即使某个代理不友好,最终界面也能与 Run 状态重新对齐。
把断线恢复放到图里看,关键其实只有两个词:事件日志 和游标。业务事件必须先成为可恢复记录,客户端才有可能从最后确认的位置继续往后读。
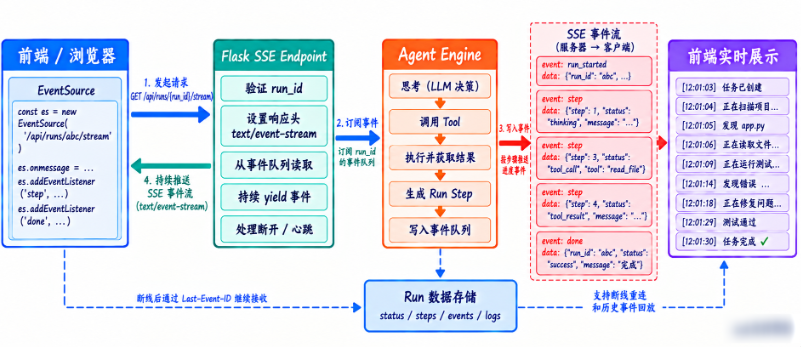
因此 Last-Event-ID 不是“浏览器神奇地记住历史”,它只是告诉服务端“我已经消费到哪里”。真正能补发历史的前提,是后端保存了带稳定 ID 的业务事件。
我们还要留住一个部署边界:当前条件变量只负责唤醒同一个服务进程里的订阅者。如果 Web 和 Worker 分布在多个进程或多台机器,应把即时通知替换成 Redis、消息队列或数据库通知等共享事件总线。SQLite 的按 ID 回放合同仍可保留,只是实时唤醒机制要升级。
慢客户端与背压
生成器执行到 yield 后,会等待客户端继续读取。如果这时仍持有发布锁,一个网速慢的浏览器就可能拖住 Worker。配套实现先在锁内读取事件或等待通知,离开锁后再 yield,让发布任务不被慢连接阻塞。
这还不是无限吞吐的承诺。生产环境要继续考虑连接数、单 Run 事件上限、历史保留期、代理超时和每个客户端的发送缓冲。判断链路是否可靠,不能只看“浏览器收到第一条”,还要验证慢读、断网重连、两个客户端并发订阅和终态关闭。
慢客户端是 Streaming 很容易忽略的一条工程边界。服务端读取事件、推进游标和持锁等待应该尽量短;真正 yield 给网络以后,就不要继续占着发布路径上的关键锁。
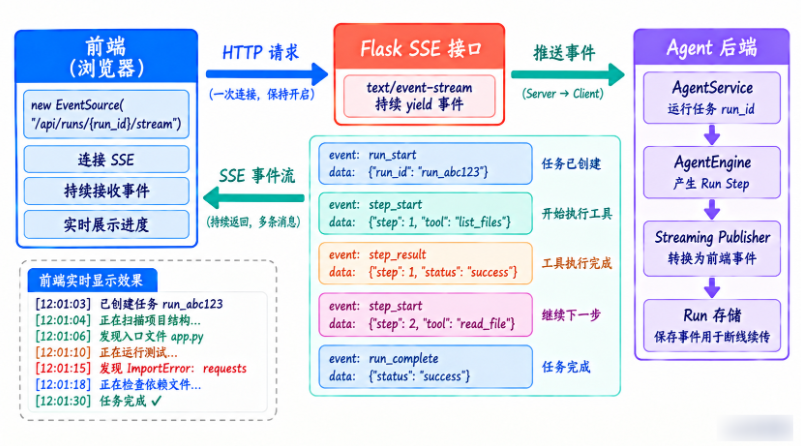
这样某个浏览器网络很慢,最多拖慢它自己的消费,不应该反过来把 Worker 发布新事件也卡住。后面再结合连接上限、批量读取和发送缓冲,才能真正处理背压问题。
动手模拟:收到一半时刷新
让任务每隔一段时间产生一个事件,在收到第二条后重连并带上该 ID。参考结果是后续事件可继续接收,界面不重复展示旧事件,任务完成后状态一致。再用两个客户端订阅,确认双方都能看到完整进度。
















请登录后查看评论内容