

Trigger 设计得好不好,会直接决定 Reminder 是帮忙还是添乱。下面这张图基本把常见触发策略都收全了。
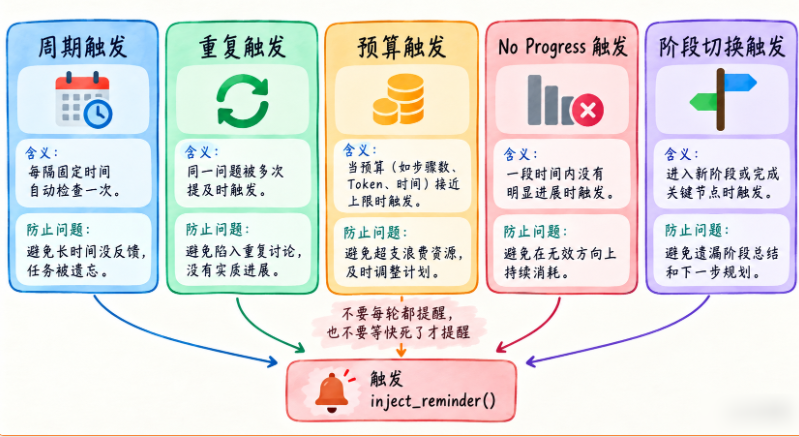
从图上你可以一眼看到五类典型场景:周期触发适合防遗忘,重复触发适合抓无效循环,预算触发用来控制资源消耗,No Progress 触发更像刹车,而阶段切换触发则适合在关键节点做总结和规划。真正实战里,通常不是只选一种,而是根据任务风险把几种策略组合起来。
inject_reminder() 有了以后,真正关键的问题是,什么时候调用?
最简单方式:
每 N Step 一次。例如:
REMINDER_INTERVAL = 5每 5 步提醒一次。
这很好理解。
但真实系统可以更聪明。
方式一:周期触发
例如:
step % 5 == 0优点:
简单
稳定
可预测
缺点:
有时没跑偏也会提醒教学阶段很适合。
方式二:重复触发
例如:
同一个 Tool Call >= 2 次
同一个 Error >= 2 次
这时立即注入 Reminder。
不必等到第 5 步。
方式三:预算触发
例如:
Step 使用率 > 60%
Token 使用率 > 70%
提醒:
资源已经过半,
请优先完成剩余核心任务。
这对控制收敛很有帮助。
方式四:No Progress 触发
如果:
最近 5 Step
completed 没新增
error 没变化
goal 没变化
可以触发。
方式五:阶段切换触发
例如:
Analysis → Edit
Edit → Verification
阶段转换时插入:
当前已完成定位,接下来只允许最小修改并验证。这也很有效。
一个 ReminderPolicy
from dataclasses import dataclass


@dataclass
class ReminderPolicy:
    interval_steps: int = 5
    step_ratio_trigger: float = 0.6
    token_ratio_trigger: float = 0.7
    repeated_tool_trigger: int = 2
    repeated_error_trigger: int = 2
    cooldown_steps: int = 2
然后判断:
def should_inject_reminder(
    step: int,
    max_steps: int,
    tokens: int,
    max_tokens: int,
    repeated_tool_count: int,
    repeated_error_count: int,
    policy: ReminderPolicy,
    last_reminder_step: int = -10**9,
) -> bool:
    if policy.interval_steps <= 0 or policy.cooldown_steps < 0:
        raise ValueError(
            "interval_steps must be positive and cooldown_steps non-negative"
        )
    if max_steps <= 0 or max_tokens <= 0:
        raise ValueError(
            "max_steps and max_tokens must be positive"
        )

    if step - last_reminder_step < policy.cooldown_steps:
        return False

    if (
        step > 0
        and step % policy.interval_steps == 0
    ):
        return True

    if (
        step / max_steps
        >= policy.step_ratio_trigger
    ):
        return True

    if (
        tokens / max_tokens
        >= policy.token_ratio_trigger
    ):
        return True

    if (
        repeated_tool_count
        >= policy.repeated_tool_trigger
    ):
        return True

    if (
        repeated_error_count
        >= policy.repeated_error_trigger
    ):
        return True

    return False
这里还要加一个小小的“防抖”意识。比如 Token 使用率一旦超过 70%,如果没有冷却窗口,之后每一轮都会再次注入同一类提醒;提醒本身就会变成噪声。实际实现通常记录 last_reminder_step,让周期触发和风险触发共享一个 cooldown_steps。触发原因和上次提醒的 Step 也应写入 Trace,后面才能判断提醒到底有没有改变策略。
为什么不要每轮都提醒?
因为 Reminder 过于频繁会产生两个问题。
第一:
Context 变长。第二:
模型每轮都被“训话”,反而降低自然决策空间。所以更好的定位是,必要时纠偏,不是每步指挥。
Reminder 和 RunGuard 的先后顺序
一个很合理的流程是:
先 RunGuard.check()
↓
如果已经超硬预算
→ 直接停止

如果还没超
↓
should_inject_reminder()
↓
必要时提醒
↓
继续下一轮也就是说,硬边界优先级高于 Reminder。
已经超预算,就不能靠提醒继续跑。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END
















请登录后查看评论内容