

接下来就不是“会不会规划”的问题了,而是“规划到底放在哪”。这张图比较适合配合代码一起看,因为它把 NeedPlan、Planner、Plan/Tasks、AgentEngine Main Loop、Tool / Observation 这几个角色的边界画得很清楚。
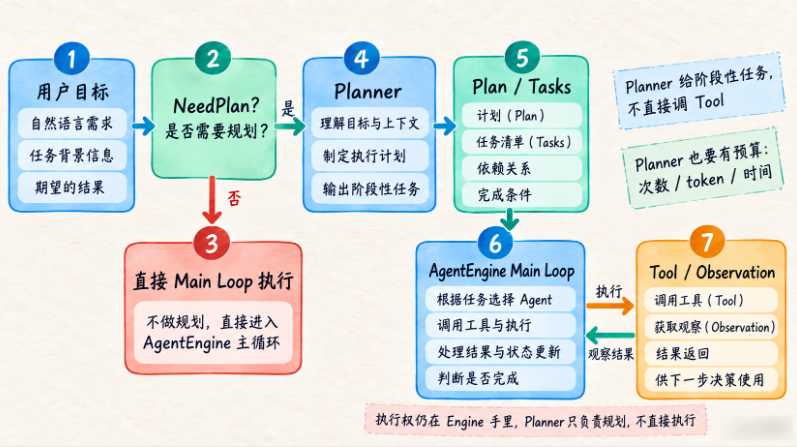
顺着图理解会更直观:先看用户目标,再做 NeedPlan 判断;如果不需要规划,就直接进入主循环;如果需要,就由 Planner 产出阶段性任务,再交给 AgentEngine 去真正执行。这里最关键的一点是:执行权始终在 Engine 手里,Planner 只负责规划,不直接调 Tool。
现在把 Planner 接回整体架构。
现在把 Planner 接回整体架构。
推荐:
User Goal
 ↓
NeedPlan?
 ↓
Planner
 ↓
Working Memory.plan
 ↓
AgentEngine Main Loop
Main Loop 仍然负责:
当前到底调用什么 ToolPlanner 只提供:
当前阶段和任务骨架。一个简单执行流程
Goal:
迁移配置结构

Planner:
Task1 理解现状
Task2 修改配置层
Task3 修改调用方
Task4 验证

Main Loop:
当前 Task1
→ search_files
→ read_file
→ observation
→ Task1 completed

当前 Task2
→ edit_file
→ run tests
...
为什么 Planner 不应该直接调用 Tool?
当然也可以设计:
Planner Agent自己调用 Tool。
但课程第一版不建议。
因为这样角色容易混乱:
Planner 到底是计划者还是执行者?我们先保持:
Planner
→ 生成计划

Executor / AgentEngine
→ 执行计划
边界更清楚。
NeedPlan 怎么实现?
最简单可以:
def need_plan(
    estimated_stages: int,
    multiple_tools: bool,
    strong_constraints: bool,
) -> bool:
    if estimated_stages >= 4:
        return True

    if (
        multiple_tools
        and strong_constraints
    ):
        return True

    return False
真实系统也可以让 LLM 输出:
{
  "need_plan": true,
  "reason": "任务包含多阶段迁移与验证"
}
但建议 Harness 保留兜底规则。
Planner 也应该有 Budget
别忘了上一部分的资源思想。
Planner 不是无限免费的。
例如:
最多 1~2 次 Planning
最多 2 次 Replan
否则 Agent 可能:
Plan
Replan
Replan
Replan
又产生一种新死循环。
所以可以:
MAX_REPLANS = 2Planner Failure 怎么办?
如果 Planner 输出:
空计划
重复任务
任务过多
不可执行描述
Harness 应:
校验而不是直接接受。
例如:
tasks 不能为 0
tasks 最多 8
title 不能为空
task_id 唯一
这和 Tool Schema Validation 的思路完全一样。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END
















请登录后查看评论内容