

假设 Skill 目录里已经有 Python 调试、Flask 项目和数据分析等多个能力,下一步就不是“全部读进来”,而是先根据用户任务选出相关项。这张图把选择过程拆成了几步,也把预算放到了合适的位置。
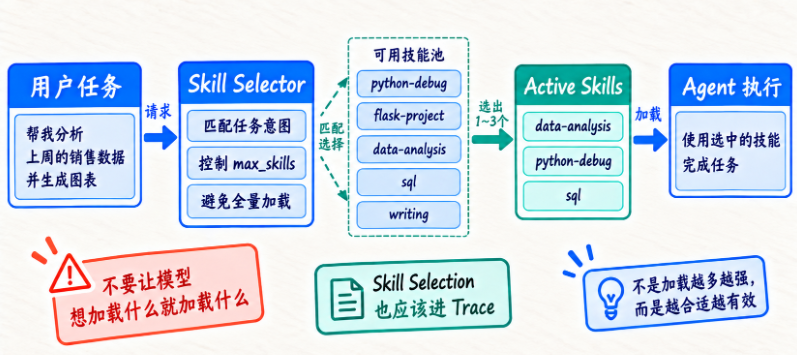
例如只做销售数据分析时,先选与分析有关的 Skill 就够了;是否还需要 SQL 或 Python 调试说明,要看任务本身,而不是看目录里有没有。max_skills 约束的是一次激活的数量,选择记录进入 Trace 后,后续也更容易检查到底加载了什么。
现在最关键的问题来了:
什么时候加载哪个 Skill?
最简单:
用户任务
→ Skill Selector
→ 选出相关 Skills
比如:
“pytest 报 ImportError”选择:
python-debug如果:
“Flask 项目升级后 pytest 失败”选择:
flask-project
python-debug
如果:
“分析昨天广告收入下降”选择:
data-analysis一个简单 Selector
这只是教学版。
为什么要 max_skills?
因为如果 Selector 一口气加载:
12 个 Skill又回到:
Prompt 无限增长。所以 Skill 也要有预算。
比如:
MAX_ACTIVE_SKILLS = 3Skill 是否可以在运行中切换?
当然可以。
例如任务一开始:
python-debug后来发现:
问题其实来自 Flask app factory可以动态加入:
flask-project再把完全不相关 Skill 移除。
这和:
Dynamic Context非常契合。
是否让 LLM 自己选择 Skill?
可以。
例如给模型:
[
  {
    "name": "python-debug",
    "description": "用于 Python 错误定位和 pytest 失败"
  },
  {
    "name": "flask-project",
    "description": "用于 Flask 项目结构、配置和路由"
  }
]
让它返回:
{
  "skills": [
    "python-debug",
    "flask-project"
  ]
}
但系统仍要:
校验名称
限制数量
限制权限
和 Tool Calling 一样。
模型只能选择:
Registry 中存在的 Skill。Skill Selection 也应该进 Trace
记录:
为什么加载
加载了哪些
什么时候卸载
以后你才能分析:
是不是加载了错误 Skill?
某个 Skill 是否提升成功率?
这会进入 Agent Evaluation。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END
















请登录后查看评论内容