

题目 1:为什么“把所有能力都写进 System Prompt”不是一个可持续的 Agent 设计?
请从 Context、规则冲突、维护和复用四个角度解释。
所有能力都写进 System Prompt 会让每次请求都携带大量无关信息,增加 Token 和延迟;不同能力的行为规则还可能互相干扰;一个巨大 Prompt 难以单独版本化和测试某个能力;多个 Agent 想复用其中一部分时也只能复制。Skill 把能力拆成独立模块,再按任务动态加载,可以让 Context 更聚焦、维护更清晰、复用成本更低。
题目 2:一个好的 SKILL.md 至少应该包含哪些内容?
请说明为什么“适用场景、操作原则、约束、完成条件”比百科式知识更重要。
一个实用 Skill 至少应说明什么时候应该启用、启用后优先按什么顺序行动、哪些操作禁止或不推荐、做到什么条件可以认为任务完成。Agent 真正需要的是可执行行为指导,而不是大量背景知识。百科式内容可能增加 Token,却不一定改变 Agent 下一步动作;操作原则和完成条件则可以直接影响 Main Loop 的决策与收敛。
题目 3:编程实现——写一个最小 SkillLoader
要求从 skills/<name>/SKILL.md 读取内容,不存在时抛 FileNotFoundError。
from pathlib import Path


class SkillLoader:

    def __init__(
        self,
        root: Path,
    ):
        self.root = (
            root.resolve()
        )

    def load(
        self,
        name: str,
    ) -> str:
        skill_dir = (
            self.root
            / name
        ).resolve()

        if (
            skill_dir.parent
            != self.root
        ):
            raise PermissionError(
                "invalid skill path"
            )

        skill_file = (
            skill_dir
            / "SKILL.md"
        )

        if not skill_file.exists():
            raise FileNotFoundError(
                name
            )

        return skill_file.read_text(
            encoding="utf-8"
        )


if __name__ == "__main__":
    root = Path(
        "skills"
    )

    loader = SkillLoader(
        root
    )

    print(
        loader.load(
            "python-debug"
        )
    )
#实际项目还可以在此基础上增加 SkillMeta、版本、优先级和缓存。
题目 4:Skill 与 Tool 最大的区别是什么?
请用 python-debug 与 run_shell 举例说明。
run_shell是一个 Tool,它提供“执行命令”这种环境动作;python-debug是一个 Skill,它告诉 Agent 在 Python 错误场景下应该先复现、读 traceback、最小修改、运行相关测试等。一个 Skill 会组合使用 read_file、search_files、run_shell 等多个 Tool,而同一个 Tool 也可以被多个 Skill 调用,因此二者分别对应“动作能力”和“任务方法”。
题目 5:为什么 Skill 需要 MAX_ACTIVE_SKILLS 之类的预算?
请说明如果无限加载 Skill,会重新出现什么问题。
如果模型可以无限加载 Skill,随着 Run 推进,Context 会不断积累 Python、Flask、SQL、Data Analysis、Deployment 等能力,最终又回到“大 Prompt”问题:Token 增加、规则冲突、注意力被稀释。限制 MAX_ACTIVE_SKILLS,并允许不再需要的 Skill 被移除,可以保持当前 Context 聚焦,也让 Skill 模块化真正发挥作用。
题目 6:Skill、Memory、AGENTS.md 三者分别解决什么问题?
请分别给出一个具体例子。
Skill 解决“某类任务应该怎么做”,例如
python-debug告诉 Agent 如何调试;Memory 解决“过去发生过什么、长期需要记住什么”,例如项目已决定使用 Python 3.11;AGENTS.md 解决“当前项目自己的规则”,例如不允许修改 tests/、必须用 pytest 验证。三者作用域和生命周期不同,混在一起会让 Context 难以维护。
题目 7:如何验证一个 Skill 是否真的有效?
请设计一个简单评估方法,并给出至少四个指标。
可以准备一组固定任务,A 组不加载 Skill,B 组按任务加载对应 Skill。比较成功率、平均 Steps、Token、Tool Calls、重复操作次数、修改范围、验证通过率等指标。还可以通过 Trace 检查 Skill 加载后 Agent 是否更早选择正确 Tool、是否减少无关探索。如果成功率提升或成本下降,就说明 Skill 有价值;否则需要继续调整内容或触发条件。
进一步阅读
- Prompt Modularity:理解 Prompt 为什么应该拆成多个来源而不是单文件。
- Dynamic Context Loading:根据任务动态选择上下文片段。
- Capability Registry:把 Skill 作为可发现、可版本化能力管理。
- Skill Selection:使用规则、Embedding 或 LLM 选择相关 Skill。
- Prompt Routing:不同任务加载不同提示模块。
- AGENTS.md:下一节会进一步讲项目级规则如何独立于通用 Skill 存在。
- Memory vs Skill:区分经验记忆与行为能力。
- Agent Evaluation:测量某个 Skill 是否真的降低 Steps 或提高成功率。
术语表
- Skill:可动态加载的 Agent 能力模块,描述某类任务的适用场景、操作原则、约束和完成条件。
- SKILL.md:某个 Skill 的主要定义文件,用 Markdown 描述该能力应该如何被 Agent 使用。
- SkillLoader:负责从本地或其他存储位置读取 Skill 内容的组件。
- SkillRegistry:维护 Skill 名称、描述、关键词、优先级、版本和作用域等元数据的注册中心。
- Skill Selector:根据当前任务判断应该激活哪些 Skill 的组件,可以使用规则、关键词、向量检索或模型选择。
- Active Skills:当前 Run / Task 已经注入 Context 的 Skill 集合,应随着任务变化动态增删。
- Prompt Modularity:把 System Prompt、Project Rules、Skills、Memory 等拆成独立模块再由 ContextBuilder 组合的设计方式。
- Capability Budget:限制同时加载的 Skill 数量、总 Token 或切换次数,避免动态能力系统重新导致 Context 膨胀。
本章总结
回到本章最开始的问题:如果 Agent 需要越来越多的经验和工作方法,应该继续堆 Prompt,还是让能力独立存在?这张收束图把前面几节的关系放在了一起,可以作为回看代码时的检查清单。
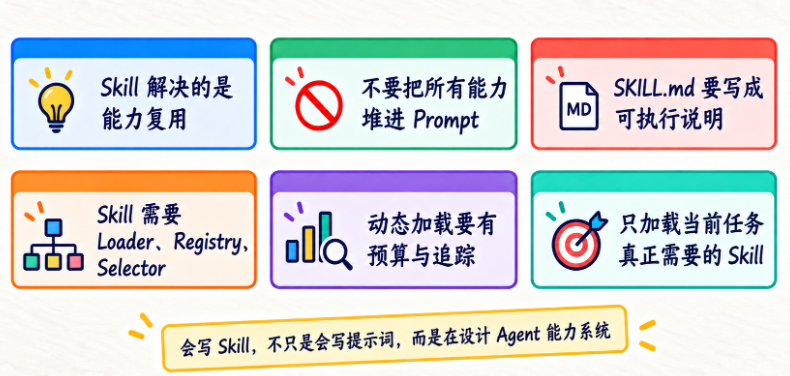
复盘时可以顺着三个问题检查自己的实现:SKILL.md 是否写成了可执行说明,Loader/Registry/Selector 是否各有职责,ContextBuilder 是否只引入当前任务真正需要的内容。做到这些,才算把“能力可复用”落实到 Harness 的结构里。
这一节,我们继续把 Agent 的能力从一个巨大 Prompt 里拆出来。
最核心的问题是:
Prompt 不应该无限变长。
如果一个 Agent 逐渐拥有:
Python Debug
Flask
SQL
Data Analysis
Git
Deployment
Testing
Research
这些能力,最简单的做法是全部塞进 System Prompt。
但这样会导致:
Context 膨胀
规则冲突
维护困难
复用困难
所以这一章引入:
Skills。
我们设计了:
skills/
├── python-debug/
│   └── SKILL.md
├── flask-project/
│   └── SKILL.md
└── data-analysis/
    └── SKILL.md
每个 Skill 只负责一个清晰能力域。
真正关键的不是:
把 Prompt 拆成几个文件。而是:
任务需要的时候才加载。
比如:
pytest + ImportError
→ python-debug

Flask + pytest
→ flask-project + python-debug

收入下降
→ data-analysis
这让 ContextBuilder 可以从:
一个巨大 Prompt升级成:
System Prompt
+
Project Rules
+
Relevant Skills
+
Memory
+
Conversation
+
Tool Results
+
Current Task
我们还实现了:
Skill
SkillLoader
SkillMeta
SkillSelector
并建立:
MAX_ACTIVE_SKILLS这种能力预算。
因为 Skill 也不能无限加载。
否则:
动态加载最后又会变成:
全部都在 Context 里。这一章还特别讲清楚四个非常容易混淆的概念:
Tool
Skill
Memory
AGENTS.md
可以直接记住:
能做什么动作?
→ Tool

遇到这类任务应该怎么做?
→ Skill

过去发生过什么?
→ Memory

这个项目有什么特殊规则?
→ AGENTS.md
System Prompt 则继续负责:
Agent 的长期角色和最高层规则。只要这几个边界清楚,整个 Agent Harness 会越来越干净。
Skill 也不是百科知识。
一个真正有用的 SKILL.md 更应该写:
适用场景
操作原则
约束
完成条件
而不是堆几千字背景介绍。
因为 Skill 最重要的是:
改变 Agent 的行为路径。
最后,我们还讨论了 Skill 的动态生命周期。
Skill 可以:
任务开始时加载
执行中增加
不再相关时移除
它应该跟着:
当前 Task走。
而不是永久塞进 Session。
如果一个信息需要长期记住:
放 Memory。如果是项目长期规则:
放 AGENTS.md。如果是任务方法:
放 Skill。到这里,我们已经真正实现了:
能力模块化。
下一节,我们会接着讲:
AGENTS.md:给不同项目定义不同规则。
因为一个通用 Coding Agent 即使拥有很多 Skills,也仍然需要知道:
这个项目用什么 Python 版本?
能不能修改 tests/?
测试命令是什么?
能不能新增依赖?
修改以后要不要跑 pytest?
这些都不应该写进通用 Skill。
它们属于:
项目自己的规则。
















请登录后查看评论内容